OnePiece: Bringing Context Engineering and Reasoning to Industrial Cascade Ranking System
Renmin University of China × Shopee × USTC × NUS
Shopee 把 LLM 成功的两个「架构之外」机制——上下文工程(context engineering)与多步推理(reasoning)——同时搬进工业级召回+排序级联系统。三大件:①结构化上下文工程(交互历史 IH + 偏好锚点 PA + 情境描述符 SD + 候选集 CIS)统一成 token 序列喂纯 Transformer;②块级隐式推理(block-wise latent reasoning),把 ReaRec 的单 token 推理升级为「一组 hidden state」迭代精炼,用 block size 调推理带宽;③渐进式多任务训练,用「曝光→点击→下单」反馈链给每一步推理做过程监督。线上 Shopee 主搜召回 +1.08% GMV/UU、排序 +1.12% GMV/UU 且广告收入 +2.90%。
核心思路
工业搜推圈过去几年「复刻 LLM」的努力,大多停留在把 Transformer 架构搬过来(SASRec / BERT4Rec / HSTU / 生成式 transducer),结果相对强 DLRM 只是增量提升——因为 attention、序列特征建模这些早就被经典 DLRM 吸收了。
本文的 first-principle 论断是:LLM 的突破不只来自架构,还来自两个互补机制——
- 上下文工程 (Context Engineering):从输入侧用结构化上下文线索(外部知识、记忆、交互历史)丰富原始 query,更好地「激发」模型能力;
- 多步推理 (Multi-Step Reasoning):从输出侧通过中间(显式 CoT 或隐式 latent)推理步骤迭代精炼预测。
OnePiece 就是把这两件事第一次系统性地、可部署地搬进工业**级联(retrieval + ranking)**系统。落地两个核心难题:
- 怎么构造有信息量的输入上下文? 传统模型只吃 user–item 原始交互序列,缺 LLM prompt 那样的结构化丰富度。→ 用结构化上下文工程,把异构信号统一成 token 序列。
- 怎么优化多步推理? 工业排序没有 CoT 标注,连专家都没法用自然语言写出用户决策路径。→ 用**天然存在的用户反馈链(曝光→点击→加购→下单)**作为推理步骤的过程监督。
整体实现思路
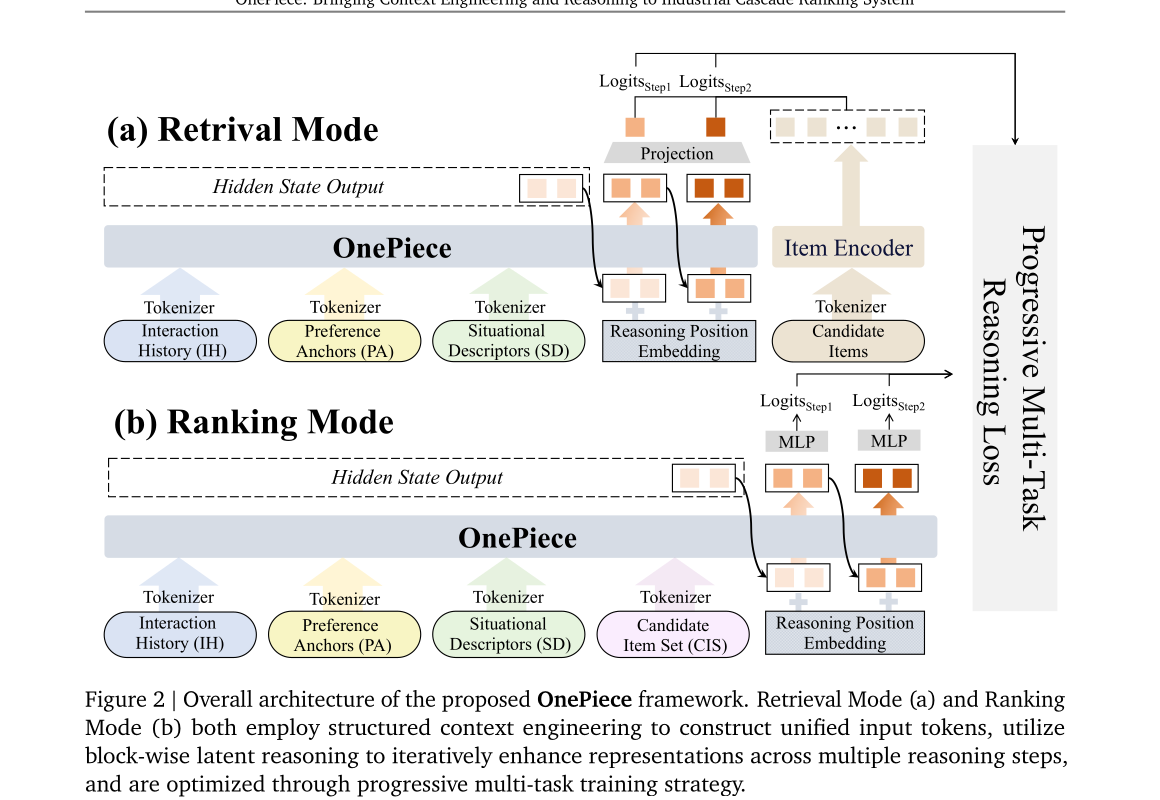
OnePiece 是召回与排序共享的统一纯 Transformer 框架,三个组件:
- Context Engineering(输入 token 序列):把 4 类异构信号 tokenize 成统一序列——交互历史 IH、偏好锚点 PA、情境描述符 SD、候选集 CIS(仅排序)。召回/排序共享 IH/PA/SD 构造,排序额外拼 CIS 实现单塔联合打分。
- 块级推理 Transformer backbone:在双向 Transformer 编码之上,加 latent reasoning block,迭代精炼中间表征。与 ReaRec「单 hidden state 循环」不同,OnePiece 一次传递一整块 (M×d) hidden state,用 block size M 调「推理带宽」。
- 渐进式多任务训练:把不同强度的反馈信号分配给不同推理步——早期步对齐弱而密的信号(曝光/点击),后期步对齐强而稀的信号(加购/下单),形成 curriculum,并避免单一表征上的梯度冲突。
召回与排序的本质差异:召回是双塔(user tower / item tower 解耦)、ANN 全库检索、粗粒度;排序是单塔联合编码候选、细粒度判别。OnePiece 用同一 backbone 统一两者。
子模块实现(可复现细节)
1. 结构化上下文工程
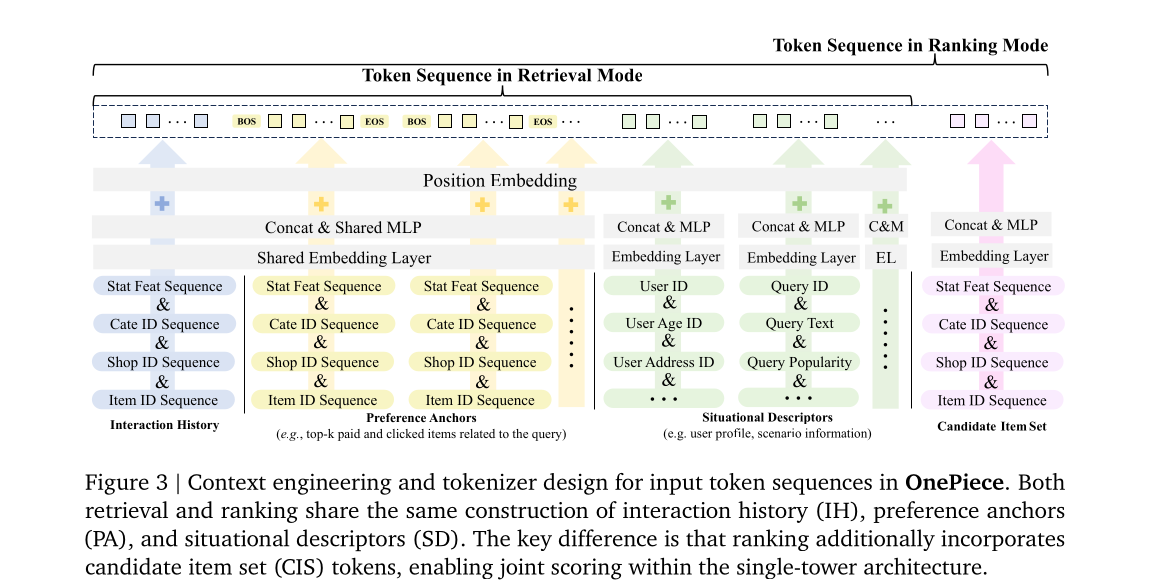
每个实体(user/query/item)用 entity-specific embedding 函数 φ 把类别+连续特征映射成拼接向量,再用轻量 MLP 投影头 Proj 统一到 backbone 的 d 维隐空间。IH 与 PA 共享 Proj_shared,user / query / candidate 各有独立投影层。
-
Interaction History (IH):用户近一个月的 click / cart / purchase 序列,按时间排序合并(mixing)。每个 item token: 其中 是按交互顺序的可学习位置嵌入。每个 item 含 ID / category / shop / 统计特征 等(共享 Embedding Layer + Concat + Shared MLP)。
-
Preference Anchors (PA):基于领域知识构造的辅助 item 序列(注入归纳偏置、约束表征空间)。例如个性化搜索里取 query 关联的 top-k 曝光 / top-k 点击 / top-k 购买。形式上有 B 个 anchor group,第 b 组 ,token 同样过
Proj_shared,加组内位置嵌入 ,并用可学习边界 token 包裹每组: 关键:PA 用序列拼接(concatenation)而非 mixing,[BOS]/[EOS] 分隔不同序列类型。组间按业务规则排序。 -
Situational Descriptors (SD):静态非 item 信息。两个专用 token——User Token(user ID + age + location + 人口学)与 Query Token(query ID + 文本 embedding + query 流行度)。,。
-
Candidate Item Set (CIS, 仅排序):排序的关键设计是 pointwise / setwise。本文采用 grouped setwise:把召回的候选集 V′(常数千)随机切成大小 C(如 12)的小组,组内 item 互相可见(intra-group interaction),组间独立处理。 退化为 pointwise, 为 full-set。CIS token 故意不加位置嵌入 ,避免学到「位置↔相关性」的虚假相关;训练/推理随机分组让模型对候选排列鲁棒。
-
序列打包(⊕ 为拼接):
- 召回:
I_retrieval = (IH 按时间) ⊕ (B 个 PA 组,BOS/EOS 包裹,组间按业务规则排) ⊕ (SD 段 h^U, h^Q, ...) - 排序:
I_rank = I_retrieval ⊕ (h^CIS_1, ..., h^CIS_C)(CIS 无位置编码)
- 召回:
2. Backbone:双向 Transformer + 块级推理
编码器:L 层双向 Transformer + pre-norm。选双向 attention(非自回归),因为推理/服务都非自回归,全上下文条件化更优:
块级多步推理:block size M 任务相关, 是第 k 个推理块。初始块取编码器输出末尾 M 个 token: 之后第 k 步从上一步输出提取块 。用 Reasoning Position Embedding (RPE) 区分推理步:。每步把基础序列 I 与所有历史增强块 拼接,过 backbone 配块级因果掩码 : 掩码规则:块 token 可 attend 所有 base token I 和所有历史块;不可 attend 未来块。
任务相关 block size:
- 召回:M = SD 长度。把 user token (个性化)与 query token (相关性)当聚合块,迭代推理同时强化两维。
- 排序:M = C(候选组大小),每块对应全部候选 item token,末块 含最终排序表征;训练随机分组保证排列不变性。
3. 渐进式多任务训练(过程监督)
K 个学习目标 按 curriculum 从基础到高级排列(电商:曝光→点击→下单)。第 k 步推理只优化任务 。
召回模式:每块过 LN + mean-pool 得步级 user 表征 。对每个 instance 构候选池 Ω(含跨任务多行为标签)。两个互补 loss:
- BCE(点级标定):
- 双向对比 BCL(借鉴 CLIP):U2I 让 user 表征区分正负 item,I2U 让正 item 从 in-batch 所有 user 中认出自己 user,温度 η。
- 总召回 loss:
排序模式:M=C,每块含 C 个候选 hidden state,过任务专属 MLP 得 logit 。
- BCE 点级标定 + Set Contrastive Learning (SCL) 集合级:,正候选与组内全部候选竞争排序位。
- 总排序 loss:
数据构造(附录 A):召回——保留有点击的 session,m 个点击 item 为曝光+点击双正,n 个曝光未点为曝光正/点击负,再从 top-500 排序结果抽 k 个未曝光为负,外加 l 个同类目 hard negative。排序——按 funnel 取任务专属正样本,funnel 中前序任务的交互作为该任务负样本(如下单任务里,曝光/点击/加购但未购买的为负),同样加 top-500 未曝光 hard negative。
4. 复杂度与部署技巧
- 编码器每层 ,总 。
- 推理阶段用 KV-Cache 复用历史 K/V,每步只算 M 个新块 token 与缓存的注意力:每层每步 ,K 步 L 层总额外开销 。
- 召回线上:离线生成全库 item 向量 → HNSW ANN 索引。排序线上分数融合:。
- 生产版排序是降级变体:block size 降到 M=1、item 边信息特征大幅削减(资源约束)。
实验设置与结果
数据:Shopee 30 天日志(2025-06-11 ~ 07-10),10M 用户 / 93M item / 12M query / 0.24B 曝光 / 60M 点击 / 12M 加购 / 6M 下单。流式协议:逐天增量训练,day-t checkpoint 在 day-(t+1) 未见数据上评估。
指标:召回 R@100 / R@500(点击样本);排序 click/cart/order 三类反馈各报 AUC + GAUC。
baseline:DLRM(Shopee 生产基线,召回 DSSM 双塔 + DIN-like + zero-attention + text CNN + DCNv2;排序 ResFlow + DIN target attention + cross-attention + DCNv2 + SENet)、HSTU(Meta 生成式推荐)、ReaRec(隐式推理推荐),及 +PA 变体。
主结果(30 天,Table 2)
| Model | R@100 | R@500 | C-AUC | C-GAUC | A-AUC | A-GAUC | O-AUC | O-GAUC |
|---|---|---|---|---|---|---|---|---|
| DLRM | 0.458 | 0.679 | 0.856 | 0.851 | 0.893 | 0.843 | 0.931 | 0.854 |
| HSTU | 0.443 | 0.658 | 0.833 | 0.829 | 0.878 | 0.827 | 0.913 | 0.839 |
| HSTU+PA | 0.472 | 0.680 | 0.855 | 0.852 | 0.901 | 0.848 | 0.926 | 0.849 |
| ReaRec | 0.452 | 0.674 | 0.843 | 0.838 | 0.882 | 0.834 | 0.919 | 0.843 |
| ReaRec+PA | 0.485 | 0.701 | 0.862 | 0.863 | 0.908 | 0.851 | 0.927 | 0.851 |
| OnePiece | 0.517 | 0.731 | 0.911 | 0.909 | 0.952 | 0.897 | 0.963 | 0.886 |
要点:①DLRM 仍是很强基线,原版 HSTU/ReaRec 只吃交互序列反而打不过;②PA 机制与 backbone 无关地稳定增益;③OnePiece 比最强 ReaRec+PA 再涨 R@100 0.485→0.517、C-AUC 0.862→0.911。
上下文工程消融(Table 3)
PA 长度有清晰 scaling 效应:V1 仅 raw item ID → V2 加 side info(R@100 0.407→0.428,C-AUC 0.802→0.846) → V3~V7 PA 从 10 加到 90(R@100 0.428→0.504) → V8 加 SD(R@100 0.504→0.517)。SD 对召回增益明显、对排序边际(排序里 query 相关性已高)。
| Version | Model | R@100 | C-AUC |
|---|---|---|---|
| V2 | IH(ID+SideInfo) | 0.428 | 0.846 |
| V5 | V2+PA(30) | 0.475 | 0.892 |
| V7 | V2+PA(90) | 0.504 | 0.908 |
| V8 | V7+SD | 0.517 | 0.911 |
训练策略消融(Table 4/5)
- 召回:因果掩码 0.464 → 双向 0.470 → +1 步推理(末步点击)0.490 → +末步多任务 0.495 → 2 步推理多任务 0.510 → 2 步渐进多任务 0.517。
- 排序:双向+CIS 互不可见 C-AUC 0.860 → CIS 互可见 0.881(候选互见是排序最大单点增益) → +1 步推理 0.890 → 3 步多任务 0.906 → 3 步渐进多任务 0.911。
- 渐进式 > 单 embedding 多任务:把不同任务分散到多个推理步当「专用 read-out token」,解耦梯度流、避免梯度冲突。召回最优 2 步(曝光-点击)、排序最优 3 步(完整转化漏斗)。
数据与推理 scaling
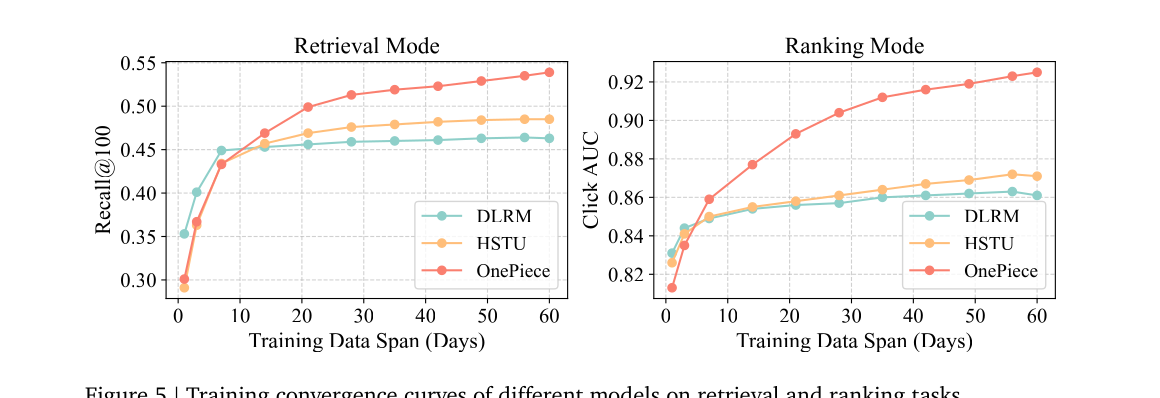
- 数据 scaling:OnePiece 仅 7–10 天训练就超 DLRM/HSTU;DLRM/HSTU 很快 plateau,OnePiece 到 60 天仍在涨且 gap 拉大,未收敛。
- block size scaling(60 天,排序,Table 6):M=C 从 1→12,C-AUC 0.885→0.913→0.920→0.927(+4.7%)。最大跃升在 1→4(pointwise 缺跨样本对比),之后边际递减(块过大冗余饱和)。
效率(A30,Table 10)
- 召回:推理 40ms→30ms(-25%),MFU 35%→80%(+129%),MU 30%→50%。统一 Transformer 更契合 GPU 并行。
- 排序(batch=128,KV-Cache):M=1 时 110ms(+0.9%)但 MFU 23%→67%(+191%);block size 1→12 仅 +10.1% 时延换 12× 推理容量,子线性(0.9%→2.8%→5.5%→10.1%)。
线上 A/B(10% 流量)
- 召回(替换 DLRM 的 U2I 召回路):GMV/UU +1.08%、GMV(99.5%)/UU +0.91%、Paid Order/UU +0.98%、CTCVR +0.66%、Bad Query Rate -0.17%(相关性还更好)。
- 排序(替换 pre-ranking DLRM):GMV/UU +1.12%、AR/UU +2.90%、CTR +0.29%。
- 召回覆盖与独占贡献:OnePiece 对其他召回路覆盖率全面提升(STR1 37.3%→66.2%、STR2 31.3%→64.4%、S2I 47.6%→67.8%);独占曝光 3.6%→9.9%(2.8×)、独占点击 2.4%→5.7%(2.4×)——既能 subsume 其他路又贡献新流量。
思考与可参考价值
局限:
- 过程监督的天花板:渐进多任务依赖反馈链(曝光→点击→加购→下单)做监督,反馈类型有限 → 推理步数受限,难进一步 scale latent reasoning。作者把 RL(用在线反馈自适应决定推理深度)列为未来方向。
- 生产版被迫降级:线上排序 M=1 且砍 item 边信息,离线 M=12 的 +4.7% C-AUC 增益没完全吃到,离线-在线有 gap。
- 在已有强 DLRM + 多路召回的成熟系统里替换/并入,工程复杂度与收益需权衡。
对电商/搜推/Agent 的可借鉴点:
- PA(偏好锚点)是最易迁移、最稳的杠杆:query 关联的 top-k 曝光/点击/购买当辅助序列拼进输入,与 backbone 无关地涨点,且有清晰长度 scaling。对任何带 query 的电商搜索/推荐都可直接试,本质是把「协同过滤聚合信号」结构化注入。
- CIS 候选互可见(grouped setwise)是排序最大单点增益(C-AUC +2.1pt):随机分组 + 组内互见 + 候选不加位置编码,既保留 listwise 比较能力又控住成本,比 pointwise 强很多。
- 渐进式多任务 = 用反馈漏斗做 curriculum 过程监督:把曝光→点击→下单分配到不同推理步当专用 read-out,解耦梯度冲突。这套思路对任何有天然反馈链(电商转化漏斗、Agent 多阶段任务)的场景都适用,比所有任务挤在一个表征上更稳。
- block-wise latent reasoning 比单 token 循环(ReaRec)更优:用 block size 当「推理带宽」旋钮,是 rec 里少见的「推理可调容量」设计;KV-Cache 让多步推理在线上几乎零额外时延(子线性)。
- 统一架构的「One For All」野心:单模型靠不同 prompt(I2U/I2I/U2I/Q2I context engineering)替代多路异构召回系统(图 7),独占贡献翻倍验证可行性——对维护多路召回的团队是降本方向。
- 纯 Transformer 统一 backbone 的 MFU 大幅提升(召回 +129%、排序 +191%) 也是实打实的部署红利,DLRM 的异构组件 GPU 利用率低。