A Unified Language Model for Large Scale Search, Recommendation, and Reasoning
Spotify
NEO 把预训练 decoder-only LLM 改造成「无工具、目录受约束」的统一生成器:用 Semantic ID(SID) 把 1000 万级异构 item 当作一种新模态,与自然语言交错在同一序列里。靠三阶段对齐配方(语义基座→域对齐→能力诱导)+ 前缀 trie 约束解码,单模型同时做推荐/搜索/推荐解释/用户兴趣画像,且全程语言可控(language-steerable),离线全面超越 Spotify 多年打磨的生产基线。
配图说明:本文 PDF 内嵌的 Figure 1 / Figure 2 矢量图与正文严重不匹配(渲染出的是另一篇 GRLM/Term-ID 论文的 iPhone/Nintendo 示意图,疑似 arXiv 投稿打包时图层错配),为避免误导读者本解读不引用论文配图,所有关键架构与数据均以文字 + markdown 表格呈现,内容均来自正文与附录文本。
核心思路
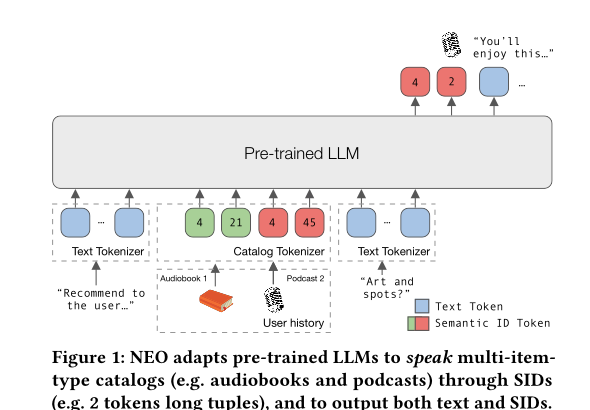
NEO(Spotify)瞄准一个工业界真实痛点:在一个超 1000 万 item、多 item 类型(podcast 单集 episode、节目 show、有声书 audiobook、艺人 artist)的异构目录上,部署单一端到端模型同时支撑推荐、文本检索、item-grounded 文本生成(推荐解释、用户画像),并且要语言可控、无工具调用、低延迟。
现有路线都有硬伤:
- 纯文本 item mention(让 LLM 直接吐 item 标题)→ 歧义、不稳定、易幻觉,无法保证指向真实目录 item;
- 连续 embedding 序列注入 LLM → 长用户历史下带宽/显存爆炸,需要改架构(projection/adapter)+ 额外 loss;
- tool-augmented / RAG 推荐(外挂 retriever、planner)→ 编排复杂、无法端到端优化、延迟高;
- 传统生成式推荐(atomic ID 序列,如 HSTU/TIGER)→ 能 scale 但只做 next-item、不能与语言交错、不能跨 item 类型、不能生成 grounded 解释。
NEO 的解法可以浓缩成三个设计决策:
- 把 item 当作一种”外语”模态:每个 item 用 Semantic ID(SID)——一个 个离散 token、每个 个取值的短元组——表示。SID 由内容 embedding 经残差量化(Residual K-means)得到,天然 coarse-to-fine(前面的码捕获大语义区域,后面的码细化区内差异),契合自回归生成。
- typed mixed-sequence 接口:SID 与文本 token 共享同一词表 ,在输入和输出里自由交错,item 引用只在显式 span 内出现:
⟨text⟩[SID]⟨c1…cM⟩[/SID]⟨text⟩。自然语言 prompt 显式指定任务(recommend/retrieve/explain/understand)、目标 item 类型、输出格式(SID-only/text-only/mixed)——这就是论文反复强调的 language-steerability。 - 借鉴多模态对齐的分阶段训练 + 约束解码:staged recipe(语义基座 / 域对齐 / 能力诱导)保证既把 SID 接进来又不破坏语言能力;推理时用前缀 trie 约束解码,保证
[SID]…[/SID]span 内生成的元组一定对应真实目录 item,span 外只允许文本 token。全程保持标准 next-token prediction 目标,不改任何架构(无 bespoke attention mask、无 cross-attention、无特制 loss)。
一句话:NEO = 「SID 当模态 + 文本/SID 交错单序列 + 三阶段对齐 + trie 约束解码」,让一个开源小 LLM(默认 Qwen3-0.6B)变成目录受约束的统一生成式 discovery 引擎。
整体实现思路
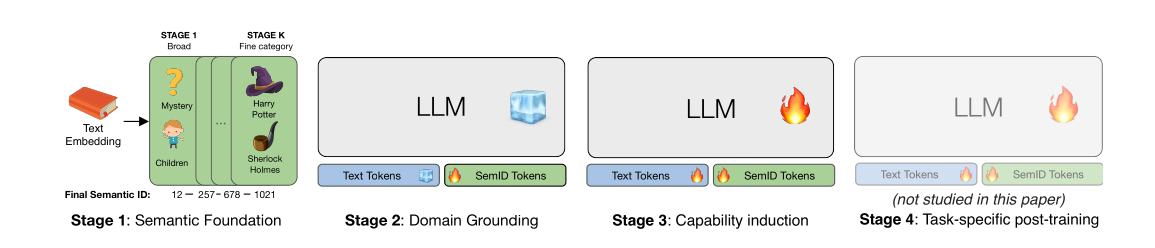
论文把 NEO 放在一个更通用的四阶段域适配 LLM 流水线里,NEO 实例化前三阶段:
| 阶段 | 名称 | 干什么 | 冻结/训练 |
|---|---|---|---|
| Stage 1 | Semantic Foundation(语义基座) | 内容 embedding → 残差量化得到 SID;扩词表 | 量化器离线训练,与 LLM 解耦 |
| Stage 2 | Domain Grounding(域对齐) | 把 SID token 对齐到 LLM 语言空间(SID↔文本双向) | 冻结 backbone,只训新 SID 输入 embedding + SID 输出 logits |
| Stage 3 | Capability Induction(能力诱导) | 多任务指令微调,学会 recommend/retrieve/explain/understand | 全参微调(也可 LoRA) |
| Stage 4 | Task-specific post-training | 业务约束/RL/产品定制(本文不研究) | — |
数据规模:域对齐阶段约 5M 样本;能力诱导阶段共 10M 训练样本,测试约 100K。Backbone 默认 Qwen3-0.6B,并用 Llama 3.2 1B 验证框架无关性。训练用 8×H100、PyTorch、序列 packing + Ray 做 CPU/GPU 负载分布。
子模块实现(可复现细节)
1. Semantic ID 构造(Stage 1)
形式定义:给定 item embedding ,
量化器:Residual K-means(论文明确选它而非 RQ-VAE,因为后者常需多个辅助 loss 防坏的局部最优)。维护 个码本 ,每本 个质心。从 起逐级量化残差:
超参与配置(关键、可复现):
- 个码本。(episode/show/audiobook),(artist,因为音频 embedding 更复杂)。
- 每个 item 类型独立 SID 词表——早期实验发现不同类型 embedding 空间差异巨大,单一量化器会严重劣化 SID 质量。
- 内容 embedding 来源:
- shows/episodes/audiobooks:用 Qwen3-embedding (8B) 编码 title+description;episode 元数据常缺失/雷同,先用一个 LLM 对多字段生成更丰富的 summary 再编码。
- artists:把 track 频谱图 → 音频 embedding,按 artist 平均得到 artist 级向量。
- 用 Qwen3-embedding 的 Matryoshka 特性把维度降到 1024 维再做 K-means(缓解维度灾难)。
- 词表扩充量:所有 item 类型 SID token 之和 + 两个 span 分隔符
[SID]/[/SID],共扩 7168 + 2 个 token,对应在 LLM embedding 层和 head 各加参数(权重 untie 时 head 也加)。 - 冲突解决:多个 item 可能撞同一 SID 元组,按**热度(popularity)**选 canonical item;消融显示与随机选差异不显著(冲突很罕见)。
- 选 的准则:① collision rate(撞桶比例)② prefix coherence(共享同一 SID 前缀的 item 间平均余弦相似度),在低冲突与短前缀高语义一致间取平衡。
2. 域对齐 / Alignment(Stage 2)
把 SID 当”外语”,学 SID↔自然语言的双向映射。记 、 为 item 的短文本描述、 为 item 类型。三个互补目标:
- SID→text(verbalization):
⟨prompt(s_e)⟩ → ⟨t_e⟩,给 SID span 预测自然语言描述。 - text→SID(grounded retrieval):
⟨prompt(q)⟩ → [SID]⟨s_e⟩[/SID]。query 只从 item 字段子集(主要 name + 短描述)构造,减少歧义噪声——论文假设 prompt 越具体、对齐质量越高。 - SID→type(type disambiguation):
⟨prompt(s_e)⟩ → ⟨c_e⟩,预测 item 类型。
稳定性参数化(防灾难性遗忘,关键):本阶段冻结整个预训练 backbone,只优化两组参数:(i) 新引入 SID token 的输入 embedding;(ii) head 中预测 SID token 的输出权重(SID-specific logits)。这样既能把 SID 接进语言空间,又完整保留 backbone 的语言能力。
配对数据:audiobook/episode/show 的描述子含 title、description、summary、topic、category;artist 含 name、genre、Wikipedia 片段。
3. 能力诱导 / 指令微调(Stage 3)
解冻全参,在多任务指令数据上 SFT。训练样本是 prefix–completion 对 :prefix 含 system prompt + 用户指令 + 轻量用户特征 + SID span 形式的 item 引用;completion 可含文本、SID span 或二者。loss 只加在 上, 全 mask(多轮可直接拼对话历史并 mask 所有 user 消息)。
四大任务族(统一 schema 显式声明 task / target item type / output format):
- Next-item recommendation:给指令+轻量用户/上下文特征+SID 表示的短交互历史,预测下一个指定类型 item 的 SID。audiobook/show 还加跨 item 类型的近期活动。
- Text-based retrieval:给自然语言 query(可选用户上下文),生成最相关 item 的 SID。
- Grounded mixed generation(recsplanation = recommendation + explanation):同时输出推荐 item 的 SID + 一段基于用户历史和被推 item 的自然语言理由。
- User understanding(兴趣画像):给 SID 表示的用户历史,生成一段用户兴趣的自然语言描述。
合成监督蒸馏(无天然标签的任务):
- 用户画像:用 32B LLM,喂入用户已消费 item 的文本描述 → 生成简洁兴趣摘要;然后把文本 item 表示替换为 SID,训 NEO 直接从 SID 历史生成同一摘要(无中间 CoT)。
- recsplanation:对每个用户序列采样切点 ,让大 LLM 解释为什么 的 item 匹配 前兴趣;再把文本 item mention 换成 SID,训 NEO 复现理由 + 输出正确 SID。
- 为增强多样性,mixed text-SID 任务构造了 20 种 prompt 模板,每条样本随机选一种填充用户信息。
4. 推理 / 约束解码(Inference)
SID 组合空间巨大(如 4-token、 → )。做法:
- 预计算所有合法 SID 元组存进前缀 trie;自回归解码时只在
[SID]…[/SID]span 内做 trie-based masking,每步只允许 trie 一致的后继 token;span 外只允许文本 token(含[SID]),防止自由文本里误吐 SID token。 - 检索任务用 beam search over SID tokens(30 beams) 产多候选。
- 冲突的 SID→item 用热度等启发式选 canonical item。
5. 超参(附录 Table 7,Qwen 版)
| 超参 | Stage 2(对齐) | Stage 3(指令微调) |
|---|---|---|
| Learning rate | 1.0×10⁻³ | 1×10⁻⁴ |
| LR scheduler | Cosine | Cosine |
| Weight decay | 0.01 | 0.01 |
| Gradient clip | 1.0 | 1.0 |
| Optimizer | AdamW (β1=0.9, β2=0.95) | 同左 |
| Warm-up steps | 300 | 400 |
| Batch size | 64 | 64 |
评测指标:HR@K 与 NDCG@K()。NDCG 用 ( 为相关 item 排名,超出 top-K 记 0)。
实验设置与结果
数据:某大型流媒体平台交互日志,目录 >1000 万 item、约 1500 万用户,含 episode/show/audiobook/artist 四类。全局时间评测协议:上下文取到第 天,标签是 消费的 item(episode/show 取 ,audiobook 取 ),在 评测以防时间泄漏。NEO 与基线同窗口训练、同 held-out 窗口、同候选集评测。
Baseline(成熟生产系统,打磨多年):
- 推荐:GNN + 双塔(two-tower),建模跨 item 类型 co-consumption,含 weak signal(follow/preview)应对冷启,用类目/topic/国家等类别特征 + LLM 编码的 item 元数据。
- 文本检索:dense retrieval,训练数据含 query-entity 对、多步改写 session、人工 curate 语义 query、合成 query。
- recsplanation / 用户画像:无基线(全新任务)。
多任务主结果(Table 5,相对生产基线的提升 %)
| 任务 | 变体 | HR@10 | HR@30 | NDCG@10 | NDCG@30 |
|---|---|---|---|---|---|
| Episode 推荐 | NEO-mono | +57% | +41% | +80% | +60% |
| NEO-multi | +58% | +40% | +80% | +59% | |
| Show 推荐 | NEO-mono | +20% | +2% | +46% | +30% |
| NEO-multi | +24% | +2% | +58% | +39% | |
| Audiobook 推荐 | NEO-mono | +36% | +6% | +73% | +52% |
| NEO-multi | +46% | +14% | +97% | +66% | |
| 文本检索 | NEO-mono | +45% | +36% | +62% | +58% |
| NEO-multi | +47% | +36% | +62% | +58% |
(文本检索基线绝对值:HR@10=0.45, HR@30=0.51, NDCG@10=0.37, NDCG@30=0.38。)多任务相对单任务有小而稳定的正向迁移,尤其 audiobook。NEO 只用了生产基线 ~50% 的历史日志,样本效率更高。
检索按类型/复杂度细分(Table 9,vs 基线 %)
| 维度 | HR@10 | HR@30 | NDCG@10 | NDCG@30 |
|---|---|---|---|---|
| Artists | +36% | +35% | +38% | +38% |
| Audiobooks | +26% | +27% | +29% | +30% |
| Episodes | +40% | +16% | +73% | +59% |
| One-step query | +21% | +12% | +33% | +30% |
| Multi-steps query | +185% | +176% | +243% | +229% |
需要用户多次改写的难 query 上,NEO 优势极大(生成式语义检索更能处理一次性表达不清的需求)。
冷启分解(Table 8,episode)
| 用户类型 | HR@10 | HR@30 | NDCG@10 | NDCG@30 |
|---|---|---|---|---|
| Warmstart | +57% | +40% | +70% | +60% |
| Coldstart | −48% | −57% | −34% | −40% |
冷启(约占数据 ~2%)是 NEO 的短板——基线有专门的 no-history side feature;NEO 移除历史只靠用户元数据,仍有提升空间。
关键消融
(A) item 表示(Table 2,ΔHR@10 vs NEO)
| 方法 | ΔHR@10 |
|---|---|
| NEO(baseline) | — |
| A - Atomic item IDs(随机打乱 SID 元组,保留码长/词表但破坏语义邻域) | −59.7% |
| B - LSH 量化器(数据无关随机投影替代 Residual K-means) | −51.2% |
| C - 用 raw 元数据(不做 LLM augment) | −2.9% |
| D - CF-based SID(artist 用 playlist 共现训 word2vec) | −25.6% |
→ ① 语义结构化 SID >> atomic ID(cold-start/long-tail 泛化关键);② 学习型量化(K-means) >> 数据无关哈希(LSH);③ 元数据质量重要但非决定性;④ content-based SID >> CF-based SID(违反传统推荐直觉)——附录 D:CF embedding 时间不稳,3 周 Jaccard@50 中位 0.59(约保留 37/50 邻居),最差 decile 仅 0.37,跨类型对齐困难。
(B) 训练策略(Table 4,vs NEO %)
| 方法 | HR@10 | HR@30 | NDCG@10 | NDCG@30 |
|---|---|---|---|---|
| A - 去掉 Domain Grounding | −6% | −7% | −8% | −8% |
| B - 对齐+诱导合并成两阶段 | −8% | −7% | −10% | −10% |
| C - Random init(无预训练 backbone) | −44% | −44% | −44% | −43% |
| D - Continuous pretraining (CPT, PLUM 路线) | −3% | −3% | −2% | −3% |
CPT 在下游略逊 NEO,但通用知识崩塌:MMLU-Redux 从 backbone 原始的 0.46 暴跌到 0.03,而 NEO 对齐后保持 0.46。这对需要指令遵循 + grounded 文本生成(检索、recsplanation)的任务是致命的——NEO 把 SID 整合隔离在新 token 参数上、再做全量指令微调,在 item grounding 与语言保留间取得更好折中。
(C) 约束解码 / 解码策略(Table 3,vs NEO)
| 推理策略 | ΔHR@10 | ΔHR@30 | Δlatency@10 |
|---|---|---|---|
| A - Beam search 无约束 | −1.80% | −1.93% | −2.92% |
| B - Top-p sampling(temp 0.6, top-k 20, top-p 0.95) | −21.97% | −32.41% | −7.91% |
无约束时模型仍 98% 生成合法 SID;加 trie 约束延迟开销很小,却换来灵活性(如限定只生成新上架内容)。Beam search(30 beams)显著优于 top-p 采样。
(D) 语言可控性 & backbone 无关性:只改 prompt 里的 Target Item Type 并关掉约束解码,模型能把全部 30 beam 都导向目标类型 SID。Llama 3.2 1B 上 Domain Grounding 让文本检索提升约 18%,说明是框架级贡献而非模型特定 trick。
(E) LLM-as-a-Judge(Table 6,GPT-4o-mini,0–5 分)
| 维度 | Artists | Episodes |
|---|---|---|
| 兴趣画像 - Coverage | 3.79 | 3.47 |
| 兴趣画像 - Groundedness | 3.81 | 3.50 |
| Recsplanation - Faithfulness(item) | 4.08 | 3.28 |
| Recsplanation - Faithfulness(history) | 4.16 | 2.79 |
| Recsplanation - Non-deceptive | 4.74 | 4.52 |
模型仅凭 SID 序列就能复原连贯的高层兴趣并产出 grounded 解释,episode 上对历史的 faithfulness 偏弱(粒度细、词汇歧义大)。
失败尝试(附录 F,有价值):① 给 backbone 加 SID expert(BEiT-3 式硬路由)→ 与无 expert 相当,弃用;② Vision-as-LoRA 式 LoRA 接 SID → 劣于 NEO;③ 用学到的 SID token embedding 拼接/平均做 k-NN 检索 → 显著差于生产基线和生成式 NEO(4×1024=4096 维向量做近邻不可靠,需额外度量学习/降维)。
思考与可参考价值
局限:
- 冷启明显劣于生产基线(−40%~−57%),生产部署需保留专门的 no-history 通路或补冷启 side feature。
- 全离线评测,无线上 A/B;指标多为相对生产基线的百分比,缺绝对值与统计显著性。
- 未做 Stage 4(业务约束/RL/多样性/去重/合规),工业落地的”最后一公里”留白。
- backbone 仅到 1B,未验证更大模型 scaling;SID/量化器需随内容分布漂移定期重训。
- SID 元组非一一映射,靠热度选 canonical item,强热门/长尾场景可能有偏。
- 论文 PDF 配图与正文不匹配(见顶部说明),复现时需以文字描述为准。
对电商/搜推/Agent 的可借鉴点:
- SID 当模态 + 文本/SID 交错单序列是统一搜推 + 生成式解释的干净范式:电商可把 SPU/SKU/品牌/类目各建独立 SID 词表(异构目录必须分类型量化),用一个 LLM 同时做”猜你喜欢/搜索召回/为什么推这个/用户画像”,省掉多套独立栈。
- 三阶段对齐配方 + 冻结 backbone 只训新 token 参数是把离散实体接进 LLM 又不毁语言能力的可复用模板——直接对标”CPT 会让 MMLU 从 0.46 崩到 0.03”这个强证据,凡是要保留指令遵循/解释能力的 LLM4Rec 都该用 staged alignment 而非粗暴 CPT。
- 前缀 trie 约束解码保证目录合法性、零幻觉指向真实 item,且能在线限定子集(新品/在售/合规品),延迟开销可忽略——电商生成式召回/导购的工程刚需。
- content-based SID 优于 CF-based SID(+CF 3 周 Jaccard 仅 0.59 的不稳定性证据)提醒:快速变化的目录(电商促销/季节性)下,生成式 tokenization 用内容嵌入更稳,CF 信号应延后到指令微调阶段让模型从用户历史里学,而非烧进 ID。
- 难 query(多步改写)上 +185%~+243% 说明生成式语义检索对”一次说不清”的长尾意图杠杆巨大,对电商搜索改写/Agent 多轮澄清很有参考价值。
- distill 大模型造合成监督(32B LLM 造兴趣摘要/解释,再换成 SID 训小模型直出、无 CoT)是低成本拿到 grounded 文本能力的实用配方。
- 失败清单(SID expert、Vision-as-LoRA、SID-token k-NN 都不如直接 mixed-sequence + 全参微调)帮后来者避坑:把 SID 当普通 token 走标准 next-token 目标,比加专家/适配器/改架构更简单也更好。