M6-Rec: Generative Pretrained Language Models are Open-Ended Recommender Systems
DAMO Academy, Alibaba Group
把工业推荐系统里所有任务(召回/排序/解释生成/个性化内容创作/对话推荐)统一成"自然语言文本的理解或生成",全部交给一个预训练语言模型 M6(300M,类 GPT-3/T5)。用文本而非 item ID 表征用户和商品,从而支持开放域、零样本推荐;再用 option tuning(只调 1% 参数胜过 fine-tuning)、多段 late interaction(缓存前 L′ 层、请求到来只算最后 ≤3 层)、蒸馏+剪枝+早退把模型压到 2M 上端侧,是早期把"LLM as 推荐基座"做到真实落地(淘宝/支付宝线上)的代表作。
核心思路
工业推荐系统的现状是”一个子任务一个模型、一个域一套系统”:召回、排序、关键词高亮、解释生成、趋势预测、AI 辅助内容生产各自为政;同一个 App(淘宝、支付宝)里又有商品、短视频、搜索 query、基金、小程序等多个域。M6-Rec 想验证一个命题:能不能用一个统一的基座模型(foundation model)支撑推荐系统里”开放式(open-ended)“的下游任务与域,从而做到(i)基座的改进直接惠及所有任务/域,(ii)大幅降低下游对标注数据的需求(数据稀缺的新业务也能跑),(iii)只预训练一次、下游适配极轻,降低碳足迹。
实现这一目标的关键设计有两条:
-
把所有推荐任务转写成”语言理解或语言生成”。收集匿名用户行为,序列化成自然语言纯文本,例如”一位北京的男性用户,昨晚点击了商品 X、今天中午点击了商品 Y,被推荐了商品 Z 但没点”。打分任务(CTR/CVR)→ 用 [EOS] 位置输出向量过 softmax 分类;生成任务(解释/产品标题/query/对话)→ 自回归续写;召回 → 双塔对比学习取 128 维向量做 kNN。全程不使用 item ID,只用 item 的文本,这是支持开放域(下游出现训练时没见过的 item)和零样本的根本前提。
-
针对工业部署的硬约束做架构改造。为了在严苛的算力/延迟/存储预算下落地,提出 option tuning(改进版 prompt tuning,仅 1% 任务参数即超过全参 fine-tuning)、multi-segment late interaction(缓存深层、请求时只跑浅层 ≤3 层,毫秒级延迟仍保住大模型容量)、以及面向手机端的蒸馏(300M→10M)+ 剪枝(10M→2M)+ 8-bit 量化 + 早退(early-exiting)。
基座选 M6:阿里达摩院的视觉-语言预训练模型系列,类 GPT-3/T5,支持中英文、多模态,已在阿里生态大规模落地(本文为简化只用文本)。
整体实现思路
M6-base 是单个 Transformer:L=24 层、H=16 头、d=1024 隐维,约 300M 参数。注意力掩码采用类 UniLM 的 seq2seq 形式——源句(用户侧特征)落在双向(bidirectional)区,目标句(候选 item 及交叉特征)落在单向自回归(autoregressive)区。预训练有两个目标:(i) text infilling(文本填空,掩掉小 span 后自回归还原,赋予”判断一段文本/一个事件是否合理”的打分能力),(ii) 自回归语言生成(掩掉整句,支撑下游生成)。
下游适配时,每类任务都被”文本模板化”后送进同一个 M6:
- 打分(CTR/CVR):用户侧特征写进
[BOS′]...[EOS′](双向区),候选 item + 用户-候选交叉特征写进[BOS]...[EOS](自回归区)。取[EOS]处输出向量 → 线性 softmax(CTR 二分类)→ 交叉熵。模板里直接把统计特征写成自然语言,如”该商品过去 14 天人群级 CTR 高,处于 top 5%;用户过去 2 年点击过该类目 4 次”。 - 生成(解释/产品设计/query/对话):用同一个自回归 LM loss 续写。解释生成把”…because”之前的文本喂进去让模型续写理由(ground-truth 来自用户评论的 aspect 级情感分析);个性化产品设计是填两个空(类目名 + 标题);query 生成填”用户现在搜索 query ___“;对话推荐用
USER:/SYSTEM:标记说话人。 - 零样本打分:无需训练分类层,直接比较两个事件文本的归一化对数似然。例如判断点过登山鞋的用户更偏好”trekking poles”还是”yoga knee pads”,分别构造两句,比较各 token 平均 log 概率。
- 召回:用户文本经 M6 后取
[EOS′]输出 → 线性投影到 128 维 + l2 归一化得到 x;item 文本取[EOS]输出 → 另一矩阵投影到 128 维 + l2 归一化得到 y(用户塔/item 塔用两套投影矩阵);in-batch 对比学习,温度 τ=0.07。
子模块实现(可复现细节)
Option tuning(核心,1% 参数胜过 fine-tuning)
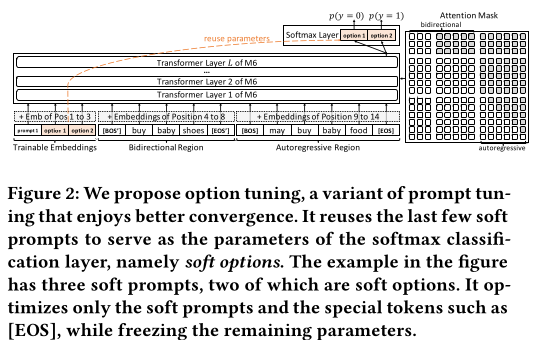
Prompt tuning 在输入前拼接若干可训练 embedding 作”soft prompt”替代离散文本提示,只训 soft prompt、冻结主干。已知问题是收敛慢。M6-Rec 的改法:复用最后 C 个 soft prompt(图中 option embeddings)直接充当 softmax 分类层的参数(C = 类别数),而不是另起一个可学习线性分类头。直觉是把”答案选项”以 soft prompt 形式写进任务描述里,故名 option tuning。实验证明它比独立线性分类头收敛更好。
进一步叠加 adapter,得到 option-adapter tuning:在每层 Transformer 的 FFN 上加一个低秩 adapter,第 l 层 FFN 改为
FFN(l)(Z) = FFN(l)(Z) + λ(l) · [ σ(Z·W1(l) + b1(l)) · W2(l) + b2(l) ]
其中 Z ∈ R^{B×d}(B 批大小),W1(l) ∈ R^{d×r}、b1(l) ∈ R^{1×r}、W2(l) ∈ R^{r×d}、b2(l) ∈ R^{1×d}、λ(l) ∈ R 均可训练,r ≪ d。总可训练参数约占主干的 1%。
Multi-segment late interaction(低延迟实时推理)
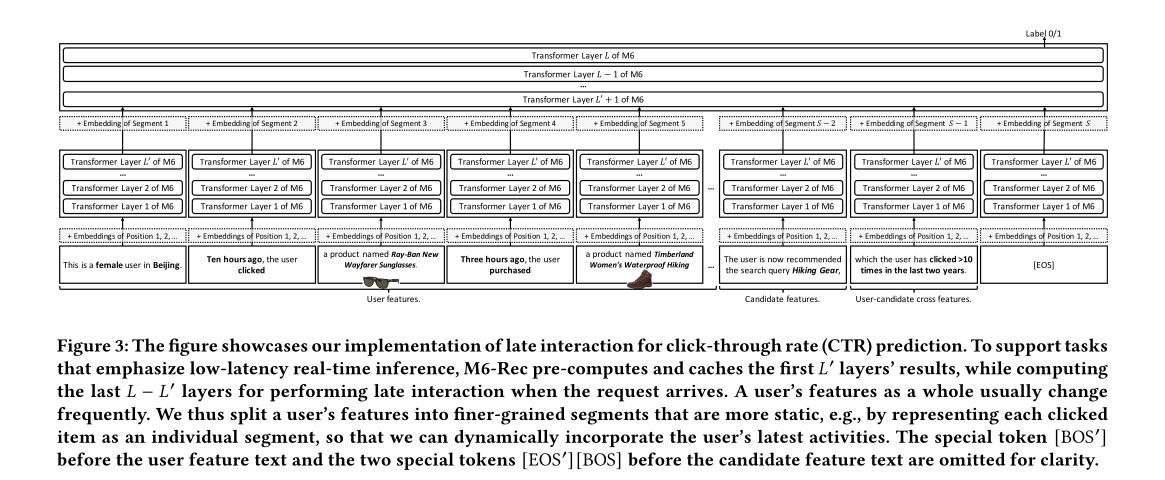
原始 late interaction(如 ColBERT/TwinBERT)只在两个粗粒度实体间做。M6-Rec 扩展为多段细粒度。核心:前 L′ 层离线预计算并缓存,请求到来时只跑最后 L−L′ 层做特征交互,取 L−L′ ≤ 3 保证低延迟。
关键技巧——分段提升缓存复用率。请求”Male. Clicked X. Clicked Y. Will click Z?”不整体跑前 L′ 层,而是切成”Male.”/“Clicked X.”/“Clicked Y.”/“Will click Z?”四段,各自独立过前 L′ 层并缓存。下一个请求”Female. Clicked Y. Will click Z?”就能复用已缓存的”Clicked Y.”和”Will click Z?”段。用户整体特征变化频繁,但把每个点击 item 拆成独立段后这些段更静态、可长期缓存,从而动态拼入用户最新行为。
由于各段被独立处理时首 token 都当成在 position 1,前 L′ 层不建模段间交互;于是把各段前 L′ 层输出拼成一个序列、再叠加一组可学习的 segment embedding(类似 position embedding,告诉后 L−L′ 层哪些来自第 1 段、哪些来自第 2 段……),最后跑后 L−L′ 层完成交互。论文还给出 option tuning 与 multi-segment late interaction 联合时如何一次前向完成训练(图 4)。
端侧压缩 M6-Edge(300M → 2M)
- 蒸馏:用 MiniLM 的 relation-based 方法把 300M M6-base 蒸成 10M 的 M6-Edge,在预训练阶段蒸馏而非微调阶段,输入输出 schema 与预训练任务沿用 M6-base。M6-Edge:L=24 层、H=16 头、768 隐维;仿 ALBERT —— 24 层共享同一套参数 + token embedding 从 128 维线性投影到 768 维。
- 剪枝:post-distillation 预训练阶段做 gradual magnitude pruning(非结构化),对每个 embedding 表和线性层逐步剪掉最小幅度权重至 80% 稀疏,期间持续优化训练 loss,把 10M 压到 2M。
- 早退:在第 k 层早退时用第 k 层而非最后一层输出训练/推理。优化累积损失 Σ_{k=1}^{L} [2k / (k(k+1))] · L_k 而非仅 L_L(L_k 为第 k 层早退的 loss)。低端设备只跑 1-2 层、高端跑更多层,按硬件自适应。
- 部署再叠加 8-bit 量化。论文估计要降到约 2M 才能不损害手机端用户体验(现有 tiny LM 普遍 >10M)。
实验设置与结果
数据集:AlipayQuery(支付宝搜索 query 推荐)、TaoProduct(淘宝商品推荐)、AlipayMiniApp(支付宝小程序召回)、Amazon-Movie/Amazon-Cloth、ReDial(对话推荐)。
排序(CTR,AUC)—— 文本语义 vs ID embedding
| Method | 类型 | AlipayQuery | TaoProduct |
|---|---|---|---|
| DIN | ID embeddings | 0.7332 | 0.7611 |
| M6-Rec | Text semantics | 0.7508 | 0.7995 |
DIN 额外用了被公认有用的 item ID 特征,M6-Rec 纯文本仍超越。且 M6-Rec 不到 100 万样本即超过需要上亿样本的 DIN(图 5)。
召回(kNN,HitRate@100,AlipayMiniApp)
| Method | 类型 | All Items | Unseen Items |
|---|---|---|---|
| YouTubeDNN | ID embeddings | 54.4% | fail |
| TwinBERT | Text semantics | 69.6% | 49.6% |
| M6-Rec | Text semantics | 74.1% | 57.0% |
ID 类方法对训练时未见的 query/小程序直接失效,M6-Rec 仍稳。线上替换 TwinBERT-like 召回,CTR 相对 +1.0%,2021 年 7 月起全量部署在支付宝。
解释生成(严格复现 PETER 设置)
| Method | FMR↑ | FCR↑ | DIV↓ | USR↑ | BLEU-1↑ | BLEU-4↑ | R1-F↑ | R2-F↑ |
|---|---|---|---|---|---|---|---|---|
| PETER+ | 0.77 | 0.31 | 1.20 | 0.46 | 19.75 | 3.06 | 26.35 | 6.71 |
| M6-Rec | 0.98 | 0.44 | 0.89 | 0.89 | 20.38 | 3.59 | 34.16 | 13.78 |
在可解释性与文本质量上全面大幅领先(ROUGE-2 F1 几乎翻倍)。
对话推荐(ReDial,KBRD 设置)
| Method | PPL↓ | BLEU-2↑ | Dist-3↑ | Dist-4↑ |
|---|---|---|---|---|
| KGSF | 10.73 | 0.033 | 0.40 | 0.46 |
| M6-Rec | 10.25 | 0.122 | 0.46 | 0.64 |
late interaction 效果(TaoProduct)
| Method | AUC↑ | Latency(ms)↓ |
|---|---|---|
| M6-Rec (L=24) | 0.7995 | 57 |
| M6-Rec, distilled (L=3) | 0.7566 | 16 |
| M6-Rec, late-inter (L=24, L−L′=1) | 0.7299 | 10 |
| M6-Rec, late-inter (L=24, L−L′=3) | 0.7731 | 16 |
缓存前 L′=21 层、只算后 3 层,延迟与 3 层蒸馏学生相当(16ms),但 AUC 损失远小于蒸馏(0.7731 vs 0.7566)。
端侧 M6-Edge(CLUE 基准)
| Method | #Params | TNEWS↑ | IFLYTEK↑ | CSL↑ |
|---|---|---|---|---|
| M6-base | 327M | 0.598 | 0.631 | 0.852 |
| M6-Edge | 10M | 0.552 | 0.586 | 0.831 |
| ALBERT-zh-tiny | 4M | 0.534 | 0.488 | 0.750 |
| M6-Edge, Pruned | 2M | 0.537 | 0.559 | 0.798 |
同规模超公开 tiny LM。基于 M6-Edge 的端侧 ranker 在支付宝部署,用户点击 +约 0.4%。
消融:tuning 方法(10M M6-Edge,CLUE)
| Tuning | #Params | TNEWS↑ | IFLYTEK↑ | CSL↑ |
|---|---|---|---|---|
| Fine-Tuning | 100% | 0.544 | 0.575 | 0.829 |
| Adapter | 1% | 0.542 | 0.574 | 0.825 |
| Prompt Tuning | 1% | 0.534 | 0.531 | 0.760 |
| Prompt + Soft Options(=option tuning) | 1% | 0.544 | 0.565 | 0.813 |
| Prompt + Soft Options + FFN Adapters | 1% | 0.552 | 0.586 | 0.831 |
加 soft options 显著改善收敛(图 8),option-adapter tuning 仅 1% 参数即超过全参 fine-tuning。
零样本与个性化内容创作
零样本排序在 AlipayQuery/Amazon-Movie/Amazon-Cloth 三个不同域验证有效(图 7);少量样本拟合语言 loss 后即可匹敌用百万样本训练的 ID ranker。个性化 query 生成(指标对标 KOBE)Dist/BLEU 全面优于 KOBE。
思考与可参考价值
这是 2022 年把”LLM as 推荐基座”做到真实工业落地的早期标杆(早于 P5、TIGER 等大量 LLM4Rec 工作),其工程取舍至今仍有很强参考价值。
可借鉴点(电商/搜推/Agent):
- 去 item ID、纯文本表征 = 开放域 + 零样本的钥匙。这是后来 Semantic ID / 生成式推荐路线的思想前身。对电商冷启动、新业务扩域、长尾/未见 item,文本语义比 ID embedding 天然更鲁棒(召回 Unseen Items 57.0% vs ID 法直接 fail)。值得注意的是它用”自然语言写统计特征”(如”过去 14 天人群 CTR 处于 top 5%”),把数值特征也语言化,便于 LLM 利用世界知识(如感恩节推火鸡)。
- multi-segment late interaction 是大模型上线 CTR 的关键工程范式:把用户行为切成静态段、深层缓存、请求时只算 ≤3 层做交互。这套”缓存前缀 + 浅层实时交互 + segment embedding 区分段”的思路,对今天想把 LLM/大序列模型塞进毫秒级排序链路的团队仍直接可用。
- option tuning(复用 soft prompt 当分类头)和 option-adapter tuning 提供了”一个共享主干服务多任务、每任务仅 1% 参数、还能超 fine-tuning”的范式,特别契合端侧多任务共享与避免灾难遗忘的诉求。
- 端侧三连(预训练期蒸馏 + 80% 幅度剪枝 + 早退自适应层数 + 8-bit)压到 2M 的配方对端云协同 ranker 很实用。
局限:(i) 本文只用文本、丢弃了 M6 的多模态能力(作者列为 future work);(ii) 在线收益偏温和(召回 CTR +1.0%、端侧点击 +0.4%),且未给出全链路替换后的系统级收益,“基座改进惠及全系统”更多是愿景;(iii) 文本序列化对超长用户历史的上下文长度/成本压力、以及把数值特征语言化带来的精度损失,论文未深入;(iv) 评测多为离线、baseline 较早(DIN/TwinBERT/PETER),与当代生成式推荐 SOTA 缺直接对比。对今天的实践,可把它当作”文本化统一接口 + late interaction 上线工程”的方法论来参考,而非直接照搬其离线指标。