LEARN: Knowledge Adaptation from Large Language Model to Recommendation for Practical Industrial Application
Kuaishou Technology × Southeast University
快手提出 LEARN,把"Rec-to-LLM"(喂对话给 LLM 出文本)反转成"LLM-to-Rec":冻结 LLM 当 item 内容编码器抽 content embedding,再用一个从头训的 12 层 causal-transformer(PAL)把开放域语义投影进协同域,用对比/dense-all-action loss 对齐推荐任务。双塔产出的 user/item emb 直接喂线上排序模型,工业 A/B 上 CVR/营收稳定正向,对冷启动与长尾用户收益尤其显著。
核心思路
当前工业推荐系统主要依赖 ID embedding 捕捉 user-item 协同信号,但完全丢弃了 item 文本描述里的语义信息,导致冷启动、长尾用户上泛化差,且无法像 CV/NLP 那样训出一个可跨下游迁移的预训练底座。LLM 天然携带丰富的开放域知识与推理能力,自然想把它接进推荐。
本文的关键判断是:主流接法(作者称为 “Rec-to-LLM”)在工业场景不可行。Rec-to-LLM 指把 user-item 交互序列文本化成对话 prompt 喂进 LLM、用 next-token loss 微调 LLM 直接出文本预测(用户兴趣 / 下一个 item / 推荐理由)。三个致命问题:
- 算力不可承受:LLM 输入长度 2K–128K,而快手短视频用户平均每周交互近 800 个视频,几个月的全局历史根本喂不进,推理/微调成本工业上不可行。
- 灾难性遗忘:用推荐数据微调 LLM,因协同域与开放域 gap 巨大,会破坏开放域知识,反而变差。
- 目标错配:LLM 的 next-token 目标与推荐的检索/排序目标不对齐。
LEARN 把方向反过来——“LLM-to-Rec”:不让推荐去迁就 LLM 的文本格式,而是把 LLM 抽出的语义 content embedding 投影进协同域,用推荐任务本身当监督目标。具体做法:冻结 LLM 当 item 内容编码器(而非 user 偏好编码器,每个 item 独立编码,规避长序列算力问题),再接一个从头训的轻量 transformer 把语义投影成 user/item embedding,对齐线上排序模型的相似度检索目标。
整体实现思路
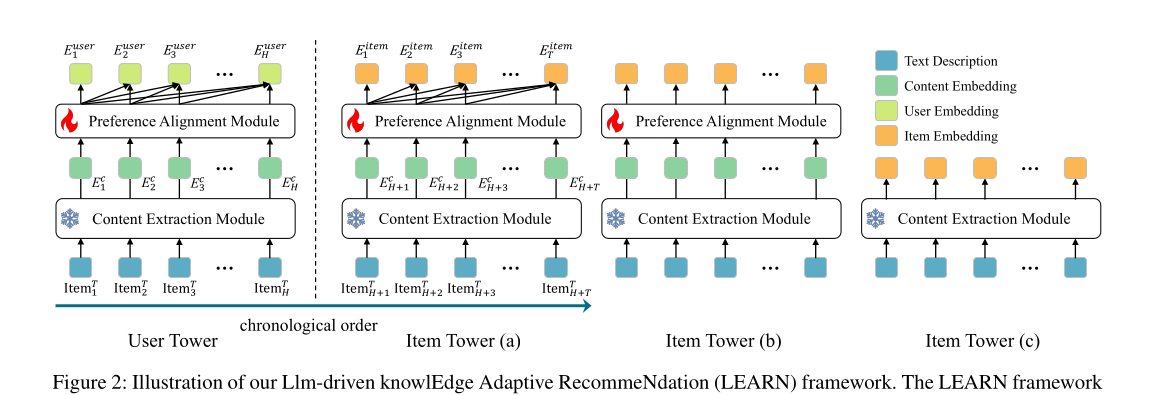
把用户按时间顺序的交互序列以某一时间戳切成两段:前段为历史序列 U^hist(长度 H),后段为目标序列 U^tar(长度 T)。LEARN 是双塔结构:
- User Tower:输入 U^hist 的 item 文本描述序列 → 输出 user embedding E^user ∈ R^64。
- Item Tower:输入 U^tar 的 item → 输出 item embedding E^item。
两塔各由两个模块串联:
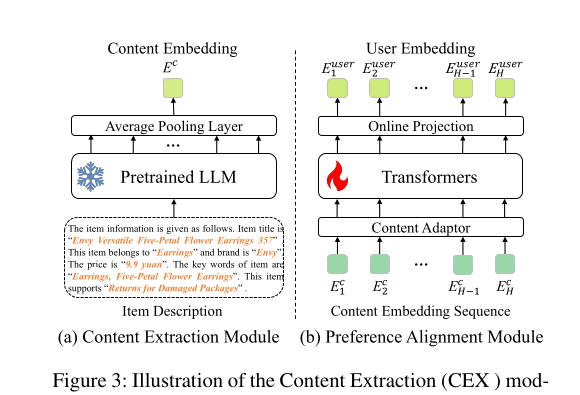
- CEX(Content EXtraction)模块:冻结的预训练 LLM + average pooling,把每个 item 的文本描述编码成 content embedding E^c。每个 item 独立过 CEX(这是规避长序列算力的关键)。
- PAL(Preference ALignment)模块:content adaptor(维度变换)+ 12 层 causal transformer + online projection,把 E^c 序列从开放域投影到协同域,输出 user/item emb。
训练用自监督对比学习对齐线上排序目标(user emb 与相关 item emb 拉近、与无关 item 推远),并采用 dense all-action loss 充分利用长期兴趣。线上则把双塔产出的 user/item emb 通过一个 LEARN-Adaptor 融合进既有排序模型。
子模块实现(可复现细节)
CEX 模块(内容抽取)
- Backbone:Baichuan2-7B(选它是因为中英双语理解强),训练全程冻结,避免灾难性遗忘、保留开放域知识。
- 输入 prompt:刻意设计得极简,用于衡量文本描述本身的信息量。工业数据用 6 类信息拼描述(title / category / brand / price / keywords / attributes)。原文 prompt 示例(耳环商品):
The item information is given as follows. Item title is “Envy Versatile Five-Petal Flower Earrings 357”. This item belongs to “Earrings” and brand is “Envy”. The price is “9.9 yuan”. The keywords of item are “Earrings, Five-Petal Flower Earrings”. This item supports “Returns for Damaged Packages”.
- 输出:取 LLM 最后一层 decoder 的 hidden states → average pooling 层 → content embedding E^c。
- 整段历史序列里每个 item 各自独立编码,拼成 content embedding 序列。
PAL 模块(偏好对齐 / 域投影)
- content adaptor:先做维度变换,把 LLM 维度的 content emb 降到 transformer 工作维度。
- backbone:12 层 transformer,配置照搬 BERT-base,但从头训练(不是用 BERT 权重)。
- 注意力:与 BERT 的双向注意力不同,PAL 用 causal attention——只看过去的 item,符合用户偏好的时序因果性。
- 输出:经 online projection 层产出 user embedding E^user ∈ R^64(64 维是为了对齐线上系统)。
Item Tower 三种变体(消融的核心设计)
| 变体 | 注意力 | 训练时输入 | 域适配方向 | 备注 |
|---|---|---|---|---|
| Item Tower (a) | causal(与 User Tower 同) | 整个 target 序列 U^tar | LLM-to-Rec(投影进协同域) | 默认,序列到序列对齐,更能抓长期兴趣 |
| Item Tower (b) | self-attention(每个 item 只看自己) | 单个 item 独立 | LLM-to-Rec | 序列到 item 对齐 |
| Item Tower (c) | — | 单个 item 独立 | Rec-to-LLM(直接用 E^c 当 item emb) | 用 content emb 当对齐目标,效果最差 |
- (a)/(b) 与 User Tower 共享权重、同架构;(c) 跳过 PAL,直接拿 content embedding E^c 当 item emb 去监督 user emb 学习(即把推荐域往 LLM 域投,复刻 Rec-to-LLM)。
- 推理阶段三种变体都是单 item 输入、独立产出 item emb。
- 注意:Amazon 数据集因 leave-one-out 设定 target 序列长度为 1,故 (a) 等价于 (b)。
训练目标(loss 构造)
- 自监督对比学习:对齐线上排序”算 user-item 相似度取 top-k”的机制。正样本对 = 同一用户历史序列采的 user emb × 该用户 target 序列采的 item emb;负样本 = 同 batch 内其他用户的 target item emb(in-batch negatives)。
- dense all-action loss(来自 PinnerFormer):从历史序列采 N_h 个 user emb、target 序列采 N_t 个 item emb,构造 N_h × N_t 个正样本对,充分挖掘单个用户交互、捕捉长期兴趣。N_h = N_t = 10(默认)。
两阶段采样策略(工业长序列)
用户序列长达 10 个月、太长跑不动,设计两阶段采样:
-
第一阶段:从完整历史/目标交互里随机采样当 User Tower 输入,保证建模无偏。
-
第二阶段:构造正负样本对时做样本加权,优先近期 item(可视化发现近期交互更能反映当前兴趣、更贴 target)。第 i 个 item 的权重:
超参 α = 10,β = 10000,N 为第一阶段采到的序列长度。
线上排序接入(LEARN-Adaptor)
- 基线 = 原排序模型,吃既有线上特征(图中 “Other”)。
- LEARN-Adaptor = fusion module(两个线性层)+ MLP,把 user emb 和 item emb 聚合成 fusion emb,由 CVR loss 监督。
- 最终把 fusion emb + LEARN 的 user/item emb + 既有线上特征 concat 后喂排序模型,由 ranking loss 监督。
实验设置与结果
数据集
- 工业数据:短视频 App 电商平台,12M 用户 × 31M item,2022.06–2023.04 共 10 个月;前 9 个月当历史、最后 1 个月当 target。Train 11.97M 用户 / 18.8 亿交互 / 平均序列 157.4;Test 23.98 万用户 / 3768 万交互。item 描述用 6 类信息。
- Amazon Review(对齐 RecFormer 设定):7 类做 pretraining、另 6 类(Scientific / Instruments / Arts / Office / Games / Pet)做 finetuning,item 描述用 3 类(title / category / brand),leave-one-out 评测。
超参
- LLM = Baichuan2-7B(冻结),优化器 AdamW + cosine scheduler。
- 工业:batch 240,历史长 80 / target 长 40(受显存限制),10 epoch;评测 H@50/H@100、R@50/R@100。
- Amazon:pretrain batch 1024 / lr 5e-5 / 20 epoch;finetune batch 16 / lr 2e-5 / 200 epoch;评测 N@10、R@10、MRR;序列短故不用采样策略。
Amazon Review 主结果(Recall@10,vs SOTA RecFormer)
| 数据集 | RecFormer | LEARN | 提升 |
|---|---|---|---|
| Scientific | 0.1448 | 0.1594 | +10.08% |
| Instruments | 0.1052 | 0.1240 | +17.87% |
| Arts | 0.1614 | 0.1701 | +5.39% |
| Office | 0.1403 | 0.1549 | +10.41% |
| Games | 0.1039 | 0.1345 | +29.45% |
| Pet | 0.1162 | 0.1284 | +10.50% |
Recall@10 平均提升 13.95%,且 LEARN 只用单阶段 user-item 对比 loss(RecFormer 要 MLM loss + 两阶段微调),约束更少、流程更简却更强。zero-shot 设定(仅 pretrain)下 LEARN 也优于 UniSRec/ZESRec/RecFormer,说明可当预训练推荐底座。
消融 1:对齐策略(Amazon,N@10 / R@10)
| 数据集 | w/o Align | w/ ItemTower(c) | LEARN |
|---|---|---|---|
| Scientific R@10 | 0.0813 | 0.1389 | 0.1594 (+14.76%) |
| Instruments R@10 | 0.0332 | 0.0940 | 0.1240 (+31.91%) |
| Games R@10 | 0.0361 | 0.0891 | 0.1345 (+50.95%) |
- w/o Align(直接平均 content emb 当 user emb、content emb 当 item emb)效果极差 → 证实开放域与协同域 gap 巨大,LLM 的 content emb 不能直接用于推荐。
- ItemTower(c)(Rec-to-LLM,用 content emb 当对齐目标)显著弱于 LEARN(LLM-to-Rec,把源域投进目标域)→ 方向必须是”把语义投进协同域”。
消融 2:工业数据集(H@/R@ at 50/100)
| 变体 | H@50 | R@50 | H@100 | R@100 |
|---|---|---|---|---|
| w/o Align | 0.0069 | 0.0154 | 0.0101 | 0.0210 |
| w/ ItemTower(c) | 0.0292 | 0.0416 | 0.0468 | 0.0626 |
| w/ ItemTower(b) | 0.0313 | 0.0488 | 0.0505 | 0.0675 |
| w/ RandomSample | 0.0440 | 0.0610 | 0.0701 | 0.0905 |
| LEARN (ours) | 0.0477 | 0.0663 | 0.0751 | 0.0970 |
排序 (a) > (b) > (c):序列到序列对齐 > 序列到 item > Rec-to-LLM。样本加权 vs 随机采样在 H@100/R@100 上各 +7.13% / +7.18%。
消融 3:embedding 类型 & PAL backbone(工业)
| input emb | Params | H@100 | R@100 |
|---|---|---|---|
| ID-emb | 2.3B | 0.0503 | 0.0754 |
| BERT-emb | 86M | 0.0576 | 0.0843 |
| LLM-emb (Ours) | 89M | 0.0751 | 0.0970 |
LLM content emb 替代 ID emb:H@100 0.0504→0.0751(+49.01%),且仅 89M 可训参数 vs ID 的 2.3B;比 BERT emb 再 +30.38%。
PAL backbone 用 LLM+LoRA vs 从头训 12 层 transformer:把 PAL 换成 Baichuan2-7B + LoRA,可训参数 134M→572M,H@100 仅 0.0376→0.0513,远逊于从头训 transformer 的 0.0751。原因:LoRA 输出是”开放域原始特征 + 推荐域 LoRA 特征”的混合,而冻结参数远多于 LoRA 参数,被 next-token 监督的原始特征占主导,与对比 loss 训的 LoRA 特征冲突,拉不到最优。
线上 A/B(4 亿+ DAU 短视频广告,2024.01 起部署)
- AUC:UAUC 0.6885→0.6969(+0.84pp),WUAUC 0.7002→0.7078(+0.76pp)。
- 分群营收(按交互频次分 cold-start / long-tail / others):
| 类型 | cold-start | long-tail | others |
|---|---|---|---|
| User 营收 | +1.56% | +5.79% | +0.32% |
| Item 营收 | +8.77% | +4.63% | +0.35% |
收益高度集中在冷启动与长尾,印证语义泛化优势。20% 流量、9 天实验,CVR 与营收稳定显著正向(营收量级以千万计,2% 提升已极显著)。
思考与可参考价值
核心可借鉴点
- “LLM-to-Rec” 而非 “Rec-to-LLM”:在工业体量下,把 LLM 当冻结的 item 内容编码器、再用轻量可训模块把语义投影进协同域,比把推荐数据文本化喂 LLM 微调更省算力、更不易遗忘、目标更对齐。这条工程路线对电商/搜推几乎可直接复用。
- 每 item 独立编码 + 双塔解耦:item emb 可离线预算并缓存,user emb 线上轻量推理,规避长序列进 LLM 的算力墙——这是它能上 4 亿 DAU 的关键。
- 对齐目标即线上目标:用 in-batch 对比 + dense all-action loss 直接对齐”算相似度取 top-k”的检索机制,省掉 MLM/两阶段微调仍 SOTA,简化训练。
- 语义 emb 替代/增强 ID emb 的强证据:LLM emb 比 ID emb +49%、参数还少 25 倍,且冷启动/长尾增益巨大——给”用 semantic content emb 替代 ID emb”提供了工业级背书,与 Semantic-ID/生成式推荐方向呼应。
- PAL 别用大 LLM+LoRA:从头训 12 层小 transformer 反而显著更好,因为冻结大模型的开放域特征会压制 LoRA 学到的协同信号——提醒做域适配时”投影头宁小而专”。
局限与风险
- prompt 极简、特征工程化:item 描述靠人工拼 6 个字段,对字段缺失/脏数据敏感;未探索更丰富的多模态(图像/视频)内容,这对短视频电商其实是大遗漏。
- LLM 冻结 → 语义上限锁死:content emb 完全由冻结 LLM 决定,无法针对推荐域做语义层面的再适配,若 item 描述里的细粒度卖点 LLM 理解偏差,下游无从纠正。
- 离线 emb 时效性:item emb 离线预算,价格/促销/库存等高频变化属性的更新延迟未讨论,电商场景需关注 emb 刷新频率。
- 对比 loss 的负采样:纯 in-batch 负样本可能 false negative,工业 31M item 下负样本质量与 hard negative 策略未展开。
- 未开源:无代码,N_h/N_t、采样权重、Adaptor 维度等需自行复现调参。