Unlocking Scaling Law in Industrial Recommendation Systems with a Three-step Paradigm based Large User Model
Alibaba Group (阿里巴巴, 淘宝广告)
把"用 LLM"的 pretrain→prompt→应用三步范式搬到工业推荐:先用生成式预训练一个 Large User Model(LUM)把 UBS 建成 next-condition-item 预测的知识库,再用"condition token 当 prompt"按场景/query/类目触发用户兴趣,最后把触发出的兴趣 embedding 作为特征喂回成熟 DLRM 排序/召回。三步解耦让 LUM 可离线缓存、scaling 到 7B 仍不增加在线延迟,淘宝广告搜索线上 A/B CTR +2.9% / RPM +1.2%。
核心思路
工业推荐想吃到 LLM 那样的 scaling law,最直接的做法是端到端生成式推荐(E2E-GR,如 HSTU):把用户行为序列 UBS 当语料、用 Transformer 做 next-item prediction。但论文指出 E2E-GR 在工业落地有四个硬伤:
- 生成式训练 vs 判别式应用不一致:生成模型优化 data likelihood(建模行为生成过程),而工业排序要的是高度校准的概率 + 细粒度 ranking 敏感度(CTR),二者目标错位,E2E-GR 在判别下游常打不过 DLRM。
- 效率约束:流式训练要 24h 内消化当天数据,在线排序要 <30ms 出 100 个候选。E2E-GR 的模型容量和序列长度直接受这两个约束卡死,无法 scale。
- 缺乏灵活性:新增一类行为(退款、新场景)就要改输入 schema → 整模型重训。
- 兼容性差:E2E-GR 建在 raw UBS 上,丢掉了成熟 DLRM 几十年沉淀的特征工程和参数继承。
核心 insight:LLM 本身就不是”端到端判别”的——它是”生成式预训练 → 用 prompt 查询 → 把回答用于下游判别决策”的多步、generative-to-discriminative 范式(Figure 1)。把这个范式照搬到推荐,就得到 LUM 的三步法,关键是用一个新 tokenization + next-condition-item prediction 任务,把 Step1 学到的联合分布 p(x,y) 可控地”触发”到 Step3 的判别任务里。
- Step 1 知识构建:生成式预训练 LUM,把用户兴趣和 item 间协同关系编进一个知识库。
- Step 2 知识查询:用预定义的 condition token 当”prompt”去查 LUM,elicit 出特定上下文(场景/query/类目)下的用户兴趣 item。
- Step 3 知识利用:把 Step2 触发出的兴趣作为附加特征喂回传统 DLRM,增强其排序/召回。
三步解耦是全文的工程命脉:Step1/2 可离线预计算 + 缓存,只有 Step3(DLRM)在在线链路上,所以 LUM 可以放心 scale 到 7B 甚至 14B 而在线延迟恒定。
整体实现思路
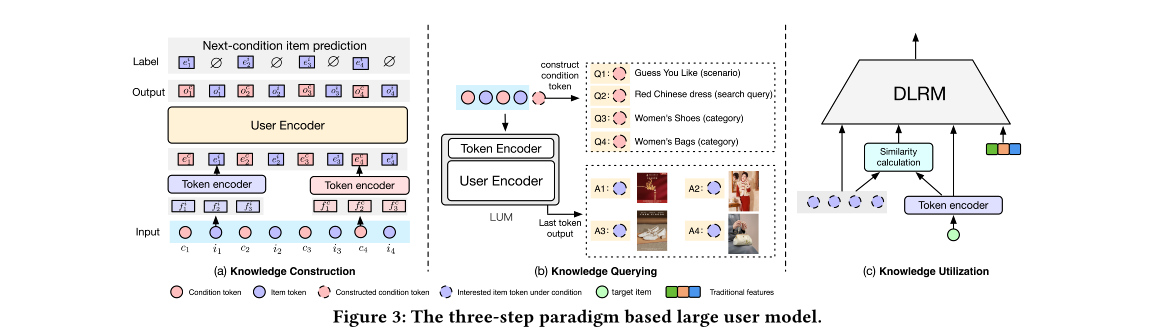
把传统范式(Embedding+MLP 的 DLRM 直接吃 UBS)改成:
UBS ──tokenize──> {c1,i1,c2,i2,...,cL,iL}
        │  (每个 item 拆成 condition token c + item token i)
        ▼
   [Step1] LUM 生成式预训练:next-condition-item prediction (InfoNCE + packing)
        │  学到 p(c1,i1,...,cL,iL)
        ▼
   [Step2] 给定查询条件 cq(场景/query/类目)→ 条件生成 p(iq | 历史, cq)
        │  group query 一次算多条件;结果 o^i_qn 缓存
        ▼
   [Step3] DLRM 把 {o^i_qn} 和 target item embedding e^i_i 作为附加特征
           ranking: ŷ = f(u,i,s, {o^i_qn, sim(o^i_qn,e^i_i)}, e^i_i)
           retrieval: e^r_us = UEnc(us,{o^i_q1..o^i_qN}),  e^r_i = IEnc(i,e^i_i)
最妙的点是 condition token = prompt:标准 next-item prediction 生成的是”泛兴趣分布”,可能和下游任务错位(用户搜”连衣裙”,无条件模型可能生成跟时尚无关的东西);而 next-condition-item 在生成第 k 个 item 前先吃一个 condition token c_k(场景/query/类目),inference 时把 c_q 当 trigger 就能把生成 steer 到任务相关输出。
子模块实现(可复现细节)
4.1.1 Tokenization:item 拆成 (condition, item) 两个 token
把每个交互 item i_k 拆成 condition token c_k + item token i_k,UBS 从 {i1,...,iL} 变成交替序列 {c1,i1,c2,i2,...,cL,iL}。c_k 编码的是”紧跟其后的 i_k 所处的上下文”,例如 scenario token(“search” / “homepage recommendation”)、search query、category。
- 与 HSTU 的本质区别:HSTU 也用辅助 token(action type),但它把 action a_k 绑在过去的 item i_k 上组成 tuple ⟨i_k, a_k⟩;LUM 的 condition 是用来条件化未来 item 的预测。前者无法基于”prospective context”动态塑造 next-item 分布,后者支持 context-aware 生成与 task-controllable inference。
4.1.2 架构:Token Encoder + User Encoder(两级)
Token Encoder:输入 token 异构(condition / item 两类),每类带一组属性特征——item token 有 ID 类(item ID、brand ID)、统计类(CTR)、内容类(title embedding);condition token 有 scenario ID、query text 等。统一映射到共享 embedding 空间:
e_t = proj_t( concat(f_t1; f_t2; f_t3; ...) ), t ∈ {i, c}
f_t_k 是 token t 的第 k 个特征表示,proj_t 默认是一个线性层。
User Encoder:把 token 序列经 token encoder 得到 {e^c_1,e^i_1,...,e^c_L,e^i_L},再用一个标准自回归 Transformer 处理,输出记为 o^c_k(聚合了序列信息)。
4.1.3 Next-condition-item Prediction + InfoNCE + Packing
自回归似然只在 condition token 的输出位上施加 loss 来预测下一个 item:
p(c1,i1,...,cL,iL) = Π_{l=1}^{L} p(i_l | c1,i1,...,i_{l-1}, c_l)
InfoNCE Loss(工业 item 词表可达 billions,全量 softmax 不现实,改对比学习):
Loss = − Σ_{l=1}^{L} log [ exp(sim(o^c_l, e^i_l)) / ( exp(sim(o^c_l, e^i_l)) + Σ_{k=1}^{K} exp(sim(o^c_l, e^i_k)) ) ]
o^c_l 是第 l 个 condition token 的 user-encoder 输出,e^i_l 是正样本 item embedding;同 batch 内其他 item 当负样本,K 是负样本数。
Packing:UBS 长度方差大、多数远短于 max length,逐条处理浪费算力。借鉴 GPT 系列把多条 UBS 拼成一条序列填满 max length。实测 Step1 加速 82%(处理一天工业数据 151h → 26h,Table 6)。
4.2 Step 2 知识查询(condition token 当 prompt)
对每个下游请求构造一个 condition token c_q(如搜索”dresses”就把 scenario ID + query text 塞进 c_q),算条件概率 p(iq | c1,i1,...,cL,iL, cq) 估计用户对 i_q 的兴趣。三个示例:c_q=场景标识→不同 app 上下文的兴趣;c_q=search query→细粒度意图;c_q=类目标签→类目偏好。支持多条件:往 condition token 里塞多个特征字段 {f^c_1; f^c_2; ...} 联合条件化(场景+意图+元数据)。
Group Query 加速:一个用户对应多条 query 但共享同一 UBS。把所有 query 拼成一条 p(iq1,iq2,...| c1,i1,...,cL,iL, cq1,cq2,...),用 masking 阻断不同 c_qj 之间的注意力交互,使公共前缀 {c1,i1,...,cL,iL} 只算一次,同时并行查多个条件下的 i_qj。实测 Step2 加速 78%(17h → 3.6h,Table 6 / Figure 4)。
冷启动:新场景/新类目的 condition token 无法直接触发;新 query 因为 condition token 用 tokenized query text embedding 做特征,文本天然有一定泛化能力缓解冷启动。论文把冷启动留作 future work。
4.3 Step 3 知识利用(两种喂回 DLRM 的策略)
Step2 得到 N 个 next-condition item {iq1,...,iqN},对应输出 o^i_qn;每个 item i 也经 token encoder 得 embedding e^i_i。两种利用方式:
- Direct Feature Incorporation:把 o^i_qn 和 target item 的 e^i_i 作为固定附加特征直接喂进 DLRM。
- Interest Matching via Similarity:算 target item 与用户兴趣的对齐度 sim(o^i_qn, e^i_i) 作为额外特征。
公式:
- 召回(双塔):
e^r_us = UEnc(us, {o^i_q1,...,o^i_qN}),e^r_i = IEnc(i, e^i_i) - 排序:
ŷ = f(u, i, s, {o^i_qn, sim(o^i_qn, e^i_i) | n=1..N}, e^i_i)
4.4 工业部署(淘宝赞助搜索,闭环协同进化)
LUM 集成在排序阶段。在线服务时,Step2(知识查询)在用户请求早期、与召回/预排序并行实时执行,从而把 LUM inference 从最终排序的严格延迟约束中解耦。一个中心化 cache 系统:(1) 存实时查询结果;(2) 预载离线推断的用户兴趣作 fallback 保覆盖。排序阶段从 cache 取兴趣喂 DLRM,并 log 供离线训练。
离线训练用同步 pipeline 对齐 LUM 预训练与 DLRM 流式训练:DLRM 训练时直接消费在线 LUM inference log 出来的用户兴趣,绕过 Step1/2,大幅提升训练效率;LUM 与 DLRM 并行训练,LUM 更新后部署上线、其 inference 输出再 log 影响后续 DLRM 训练——形成闭环协同进化。
实验设置与结果
数据集:3 个公开(ML-1M、ML-20M、Amazon Books)+ 1 个工业(淘宝,4B 交互 / 0.1B user / 0.1B item)。
Baseline:召回用双塔 EDB;排序用 DIN/DIEN/SIM/TWIN;E2E-GR 用 HSTU;序列模型 SASRec。
训练配置:公开集 Transformer 系(LUM/HSTU/SASRec)约 30M 参数、序列长 256、lr 1e-3、32 GPU;工业集 0.3B 参数、序列长 4096、lr 1e-4、128 GPU;batch size 全 2048,均从 scratch 训。公开集 LUM 的 Step3 backbone 用 SIM(排序)/EDB(召回),工业集 backbone 直接用线上生产模型。注:尝试增大 DLRM baseline 参数量但无进一步增益(与 DIN 论文一致)。
公开数据集(AUC,Table 2)
| Model | ML-1M | ML-20M | Amazon Books |
|---|---|---|---|
| SASRec | 0.7295 | 0.7166 | 0.6699 |
| HSTU | 0.7533 | 0.7463 | 0.6712 |
| DIN | 0.7455 | 0.7299 | 0.6139 |
| SIM | 0.7579 | 0.7341 | 0.6551 |
| TWIN | 0.7539 | 0.7331 | 0.6538 |
| LUM | 0.7615 | 0.7483 | 0.6727 |
工业数据集(Table 3,排序 AUC + 召回 R@K)
| Model | AUC | R@10 | R@50 |
|---|---|---|---|
| SASRec | 0.7322 | 0.2560 | 0.4740 |
| HSTU | 0.7334 | 0.2594 | 0.4781 |
| Online Model | 0.7338 | 0.2482 | 0.4651 |
| LUM | 0.7514 | 0.2727 | 0.4915 |
| Imp. | +0.0176 | +0.0133 | +0.0134 |
(注:排序任务 0.001 绝对 AUC 即视为显著,LUM +0.0176 量级很大。)
LUM 即插即用到各种 DLRM(Table 4,AUC)
| DIN | DIEN | SIM | TWIN | Ave | |
|---|---|---|---|---|---|
| ML-1M Base | 0.7455 | 0.7527 | 0.7579 | 0.7539 | 0.7525 |
| Base+LUM | 0.7472 | 0.7604 | 0.7615 | 0.7675 | 0.7592 |
| ML-20M Base | 0.7299 | 0.7319 | 0.7341 | 0.7331 | 0.7323 |
| Base+LUM | 0.7413 | 0.7361 | 0.7483 | 0.7422 | 0.7420 |
| Amazon Base | 0.6139 | 0.6130 | 0.6551 | 0.6538 | 0.6340 |
| Base+LUM | 0.6261 | 0.6194 | 0.6727 | 0.6591 | 0.6443 |
提升幅度 +0.0053 ~ +0.0176,证明 LUM 可通用增强任意 DLRM。
消融 / 兼容性(Table 5,工业 AUC)
| 配置 | 训练方式 | AUC |
|---|---|---|
| E2E-GR (HSTU) | from scratch | 0.7334 |
| DLRM | from scratch | 0.7338 |
| LUM | from scratch | 0.7514 |
| DLRM (feature) | incremental | 0.7541 |
| DLRM (param) | incremental | 0.7525 |
| DLRM (param+feature) | incremental | 0.7777 |
| LUM (feature) | incremental | 0.7659 |
| LUM (param) | incremental | 0.7620 |
| LUM (param+feature) | incremental | 0.7794 |
| LUM (w/o condition token) | scratch | 0.7416 |
| LUM (multi-conditions) | scratch | 0.7545 |
| LUM (direct feature) | scratch | 0.7402 |
| LUM (direct feature + interest matching) | scratch | 0.7514 |
关键结论:(1) condition token 是有效的——去掉后 0.7514→0.7416;多条件(场景+search term)再升到 0.7545。(2) 知识利用上 direct feature + interest matching(0.7514)> 单 direct feature(0.7402)。(3) 兼容性是 LUM 对 E2E-GR 的杀手锏:HSTU 从 scratch 只 0.7334,远低于继承了生产特征+参数的 DLRM(param+feature) 0.7777;而 LUM 能无缝接入增量训练,LUM(param+feature) 达 0.7794,比 scratch 高 +0.0106~+0.0280。E2E-GR 无法吃成熟系统沉淀的知识,这是其落地的根本障碍。
效率(Figure 6)
序列长 4096,0.5B~14B 参数,128 GPU,工业流式要求 24h 内消化当天数据、在线 <30ms 排 100 候选。
- 训练:LUM-Step3 训练成本与 DLRM 相当且对模型规模几乎不敏感(解耦设计);E2E-GR 比 LUM-Step3 慢 12×~98×,所有规模都无法在 24h 内训完,要追平 LUM 吞吐需 12×~98× GPU。
- 服务:LUM 各规模延迟恒定、不破 30ms;E2E-GR 连 0.5B 都超时,14B 时要满足 30ms 只能把序列长压到 4096 的 1/64(即 64)。
Scaling Law(Figure 7)
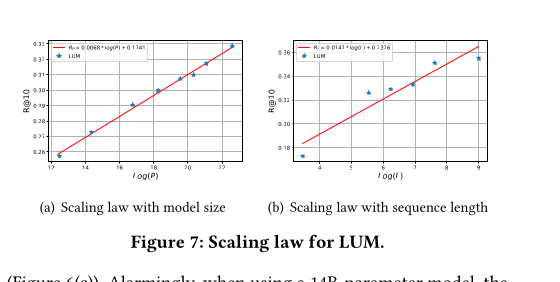
固定 300M 参数变序列长 256→8192,或固定序列变模型规模,R@10 呈幂律:
R_P = 0.0068 · log(P) + 0.1741   (P=模型规模)
R_L = 0.0147 · log(L) + 0.2326   (L=序列长度)
模型规模可一路 scale 到 7B 仍持续涨点,验证 LUM 具备类 LLM 的可扩展性。
在线 A/B(5.6)
淘宝赞助搜索排序任务上线,CTR +2.9%、RPM +1.2%,均显著。
思考与可参考价值
局限:
- 冷启动未解:新场景/新类目的 condition token 无法触发,论文明确留作 future work;只有新 query 靠文本 embedding 泛化部分缓解。
- Step3 信息有损:LUM 学到的是联合分布,但喂给 DLRM 的只是 N 个被触发兴趣的 embedding + 相似度,等于把生成能力压成几个静态特征,上限受 condition 设计和 N 的限制;condition token 选什么字段(场景/query/类目)很大程度靠人工 prompt engineering。
- 闭环依赖 log:在线训练绕过 Step1/2 直接消费 LUM inference log,模型迭代会引入分布漂移/反馈回路,论文未深入分析。
- 公开集只报 AUC,无校准/线上指标对照;scaling 到 7B 的具体配置(层数/宽度/数据量配比)未给。
对电商/搜推/Agent 的可借鉴点:
- “解耦换 scaling”是工业落地大模型的关键工程范式:把重的生成式大模型放到离线/可缓存的非关键路径,只让轻量判别模块上在线链路。这让”模型规模”和”在线延迟”脱钩——LUM 7B/14B 在线延迟恒定。任何想在严格 RT 约束下用大模型的电商场景都可复用这套”大模型离线产兴趣特征 + 缓存 + 喂回成熟排序模型”的架构。
- condition token = 可控触发,是 generative-to-discriminative 的桥:把”无条件 next-item”改成”next-condition-item”,让同一个用户模型按场景/query/类目/甚至业务规则(退款行为)被不同 prompt 触发出不同兴趣视图。对多场景统一建模(搜索+推荐+广告共享一个 LUM)极有价值,新增行为类型只需新增 condition token 而非重训 schema。
- 兼容存量是 E2E-GR 打不过 DLRM 的真正原因:Table 5 的 0.7334(HSTU scratch) vs 0.7777(DLRM param+feature) 说明,成熟系统几十年沉淀的特征工程+参数继承价值巨大。新方法不要想着推翻 DLRM,而要设计成”可被存量系统增量吸收”。
- 闭环协同进化 pipeline:LUM 与 DLRM 并行训练、互相 log 喂养,是一个可复用的”大模型+判别模型”双轨协同进化工程模板,对 Agent 优化电商、生成式推荐落地都有参考意义。
- group query(共享前缀 + mask 阻断条件间注意力,一次算多 query)和 packing(拼短序列填满长度)这两个 78%/82% 提速 trick,对任何”一个用户多 query / 序列长度方差大”的工业 inference 都直接可用。