IDProxy: Cold-Start CTR Prediction for Ads and Recommendation at Xiaohongshu with Multimodal LLMs
Xiaohongshu Inc. × Shanghai Jiao Tong University × Fudan University
小红书把多模态大模型(MLLM)的内容表征对齐到 CTR 模型已有的 item ID embedding 空间,生成"代理 ID embedding"(IDProxy),让冷启新 item 无交互数据也能直接顶替 ID embedding 进现有排序模型。核心是 coarse-to-fine 两阶段:先用对比学习把 MLLM 表征拟合到 ID embedding 分布,再用轻量 adaptor 抽 MLLM 多层 hidden state 端到端跟 CTR ranker 联合训练并复用其结构先验。已上线 Content Feed 与 Display Ads,新 note AUC 增益约为全局 2 倍。
核心思路
工业 CTR 模型严重依赖 item ID embedding 来捕获协同信号(collaborative signal),但新 item 没有足够交互历史,ID embedding 训练不充分——这就是 item cold-start 问题。小红书每天有海量新 note/广告必须即时分发,冷启尤其严重。
已有的”用多模态内容补冷启”路线有两个工业落地痛点:
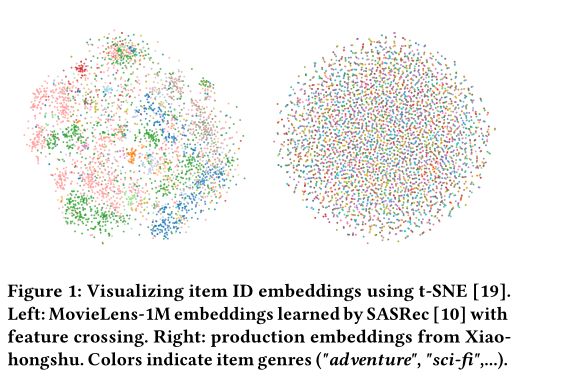
- 语义空间 ≠ 协同空间。多模态语义表征和 CTR 系统的协同 ID embedding 空间不匹配。论文用一张 t-SNE 图(Figure 1)说明:在 MovieLens 这类公开 benchmark 上 ID embedding 有清晰的按 genre 聚类结构,content→ID 对齐相对容易;但小红书生产环境的 ID embedding 因特征稀疏、交互模式复杂而呈现不规则、非聚类的分布,冻结的 content encoder 或浅层 MLP 映射根本架不起这座桥。
 2. 要复用成熟架构、不能加部署成本。已有方法(QARM / MOON / SimTier&Maker 对齐共现结构;CB2CF / CLCRec / GoRec / GAR 直接 content→collaborative 映射)要么靠手工设计的对齐目标反复调,要么没充分利用排序模型本身的结构与分布先验,增益有限且部署复杂。而且 CTR 模型在线上持续演化,对着一个静态 target学,长期优化和稳定部署都成问题。
IDProxy 的答案:用 MLLM 生成 proxy item embedding (p_i \in \mathbb{R}^d),它被显式对齐到现有 item ID embedding 空间,并在 CTR 目标下与 ranker 端到端联合优化,从而能直接”无缝顶替” (e_i) 进现有排序流水线,最大化复用已有 ID 知识和结构先验。
整体实现思路
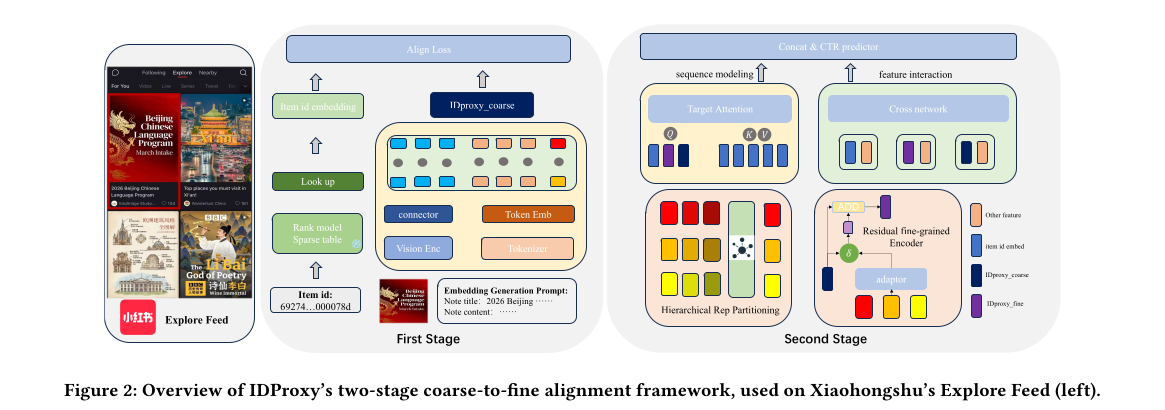
两阶段 coarse-to-fine:
- Stage 1(MLLM-based 粗对齐):用 MLLM 把 item 的多模态内容(文本 + 图)编码成 content embedding,再投影到 ID embedding 空间,用对比学习拉近到该 item 真实 ID embedding、推远其他 item,得到粗代理 (p_i^{coarse})。这一步把 MLLM 表征”扳”进静态 ID embedding 分布。
- Stage 2(CTR-aware 细对齐):抽 MLLM 多个 transformer 层的 hidden state,用 k-means 分成浅/中/深三组,经一个轻量多粒度 adaptor 融合,加 residual gating 控制细粒度信号贡献,得到 (p_i^{fine});把 (p_i^{coarse})、(p_i^{fine}) 灌进 ranker 的 feature interaction 与 target attention 模块,端到端跟 CTR loss 联合训练(MLLM 冻结),让代理 embedding 继承 ranker 演化中的结构先验。
部署上:adaptor 离线训一次,连同 MLLM 打包成 IDProxy 生成服务;线上对每个新 item 实时算 coarse/fine 代理写进在线存储,排序系统按 ID 取用即可,不改 ranker 架构。
子模块实现(可复现细节)
Stage 1:MLLM 粗代理生成
ID embedding 预处理。设 (e_i^{raw} \in \mathbb{R}^d) 为线上 CTR 模型学到的 item ID embedding。两步清洗:
- 频次过滤:用阈值 (\tau) 滤掉更新次数 < (\tau) 的 item,保证对齐 target 可靠(很多 item 交互极少)。
- L2 归一化:embedding 模长往往跟 item 热度相关,做 (e_i = e_i^{raw} / |e_i^{raw}|_2) 去掉热度引入的 bias,稳定对齐学习。
MLLM 多模态编码。MLLM (M) 的输入 prompt:
[BOS]<image><text>The compression word is:"[EMB]". [EOS]
<image>/<text> 替换成 item 内容,[EMB] 是用来”压缩”语义的特殊 token。取最后 token-level hidden state (H_i \in \mathbb{R}^{T \times D}),经基于 attention 的 token 聚合 (g(\cdot))(含 [EMB])得到 content embedding (z_i = g(H_i) \in \mathbb{R}^D)。再用 MLP (\phi) 投影到 ID 空间并 L2 归一化:
Proxy Alignment Loss(对比目标)。mini-batch (B) 内,((\tilde{h}_i, e_i)) 为正对,((\tilde{h}i, e_j){j\neq i}) 为 in-batch 负样本,温度 (\tau_c>0):
联合优化 (M) 与 (\phi)。收敛后定义粗代理 (p_i^{coarse} = \tilde{h}_i)。
Stage 2:CTR-aware 细对齐
层次表征划分(Hierarchical Representation Partitioning)。从 Stage 1 训好的 MLLM(数十层)抽多层 hidden state,用 k-means 把层聚成三个子组 (l_{n1}, l_{n2}, l_{n3})(浅→深,平衡表征丰富度与学习效率),各组再过 Stage 1 的聚合 (g(\cdot)):
轻量多粒度 adaptor + residual gating。三组拼接后过 MLP (\tilde{\phi})(参数远小于 MLLM 和 ranker):
为避免 (p_i^{raw_fine}) 与 (p_i^{coarse}) 信息冗余,加 residual gating 自适应控制细粒度信号贡献,鼓励学到超出 coarse 的信息:
端到端联合训练。把原本只有 item ID 和 (p_i^{coarse}) 的特征集,扩展加入 (p_i^{fine}),同时灌进 feature interaction 与 target attention 两个模块。CTR 预测:
标准交叉熵分类 loss:
Stage 2 优化 adaptor (\tilde{\phi})、(W_g)、(W_c) 和 ranker (\theta),MLLM 冻结。
部署。adaptor 离线训一次→参数与 MLLM 打包成 IDProxy 生成服务;每个新 item 实时算 coarse/fine 代理写在线存储,排序系统按 ID 取,无缝接入。
实验设置与结果
设置。MLLM 用 InternVL;所有方法 AdamW,lr=1e-4,batch=512。Base 是小红书高度优化的生产 CTR 系统(复杂 ID 特征交叉 + 用户序列建模)。在线 A/B 跑在 Explore Feed:Content Feed(推 note,2025 年 8 月测)、Display Ads(投广告,2025 年 3 月测)。部分实现细节因保密省略。
Q1+Q2 离线 ΔAUC(相对 Base):
| 模型变体 | ID | ΔAUC |
|---|---|---|
| Base(小红书生产基线) | - | 0 |
| Base + Notellm2-Like Embed(主流多模态 embed) | v1 | +0.015% |
| Base + Static Vector(MLP mapping,CB2CF 风格) | v2 | +0.02% |
| Base + IDProxy(Stage 1) | v3 | +0.05% |
| Base + IDProxy(Stage 1+2,不复用结构) | v4 | +0.08% |
| Base + IDProxy(Stage 1+2,完整) | v5 | +0.14% |
要点:v1(主流多模态 embed,类 NoteLLM2)和 v2(冻结 embed + MLP)因与 ID 分布失配只有微弱增益;v3 通过显式拟合 ID 分布 + MLLM 对齐已超过它们;v4 加端到端学习又涨;v5 把 IDProxy 灌进 ranker 的”原子 ID 槽位”复用其序列/特征交叉结构,达到 +0.14%——验证了让多模态特征继承 ID-based CTR 模型已训好的结构先验的价值。作者强调 ΔAUC 看似小,但在如此强的生产 Base 上已很有价值。
Q3 在线冷启(5 天 ΔAUC):
| Day1 | Day2 | Day3 | Day4 | Day5 | |
|---|---|---|---|---|---|
| Global Notes | +0.13% | +0.15% | +0.14% | +0.12% | +0.15% |
| New Notes(24h 内发布) | +0.24% | +0.32% | +0.23% | +0.27% | +0.31% |
新 note 增益约为全局的 2 倍,证明 IDProxy 有效把语义迁移给了无交互历史的 item。
Q4 在线 A/B 业务指标(均在 1% 显著性水平显著):
| 场景 | 指标与增益 |
|---|---|
| Content Feed | Time Spent +0.22%,Reads(点击) +0.39%,Engagements +0.5% |
| Display Ads | Impression +1.28%,ADVV +1.93%,COST +1.73%,CTR +0.23% |
思考与可参考价值
这篇做对了什么(对电商/搜推可借鉴):
- “代理 ID embedding”范式很务实。核心洞察是:不要去改 CTR 排序模型,而是把多模态表征”翻译”成 ranker 已经认识的 ID embedding 语言,从 ID 的”原子槽位”塞进去。这样冷启方案零改动复用整套成熟排序架构(target attention、cross network、序列建模),部署成本极低——这是工业落地能成的关键,比起另起炉灶的对齐目标更易推全量。
- coarse-to-fine 解耦”对齐”与”任务”。Stage 1 只管把 MLLM 表征拉进 ID 分布(对比学习,静态 target),Stage 2 才在 CTR 目标下端到端精修并复用 ranker 演化结构。这种解耦回避了”对着持续演化的线上模型学静态 target”的不稳定问题,值得做生成式表征/Semantic ID 的团队参考。
- 多层 hidden state + k-means 分组。不只用 MLLM 最后一层,而是抽多层、按浅/中/深聚成三组多粒度融合,呼应”中间层语义更可迁移、有时深层反而该丢”的发现。这是一个轻量但有效的特征抽取技巧,可迁移到任何用 LLM/MLLM 做表征的下游任务。
- 两个工程细节值得抄:(1) 频次阈值 (\tau) 过滤低频 item 做对齐 target,保证 target 可靠;(2) L2 归一化去掉热度引入的模长 bias。这两点直接决定对齐质量。
局限 / 需要注意:
- ΔAUC 绝对值很小(全量 +0.14%,全局在线 +0.12~0.15%),强 Base 下的真实增益主要体现在冷启子集和业务指标上,复现时需要在新 item 切片上单独评估,否则全局 AUC 容易”看不出来”。
- 保密导致不可完全复现。Base 架构、adaptor 维度 (\tilde{d})、(\tau)/(\tau_c) 具体取值、k-means 分组的层号、聚合 (g(\cdot)) 的 attention 细节均未给出,属于”思路可借鉴、参数需自调”。
- residual gating 是否真去冗余、MLLM 推理成本(数十亿参数 MLLM 对每个新 item 跑一遍)等没有量化分析;论文靠”离线算一次写存储”绕过在线推理成本,但 MLLM 离线刷库的吞吐与新鲜度 trade-off 未讨论。
- 论文仅 5 页(投稿中),消融较薄:没有对三层分组数量、是否需要 Stage 1 预热、对比温度等的 sensitivity 分析。
对 Agent/LLM4Rec 的启发:IDProxy 本质是”用大模型语义补结构化系统冷启”的通用模板——先把大模型表征对齐到下游系统已有的稠密空间,再端到端复用下游结构。这个”对齐到已有空间而非替换已有系统”的思路,对任何想把 LLM 接进成熟工业管线(推荐、广告、风控)的团队都有方法论价值。