How Well Does Generative Recommendation Generalize?
CMU × UC San Diego × Meta
系统性拆解「生成式推荐(GR)凭什么比 item-ID 模型强」这个广为流传的假设。把每条测试样本按所需能力划成「记忆 vs 泛化」两类,发现 GR(TIGER)在泛化子集赢、item-ID(SASRec)在记忆子集赢;进一步用 token 级 prefix n-gram 透镜揭示 GR 的「泛化」很大程度上其实是 semantic-ID 前缀上的「记忆」。最后用一个免训练的 MSP 指示器做记忆感知自适应集成,把两种范式的长板拼起来。
核心思路
行业里一个被反复引用但很少被严格验证的假设是:生成式推荐(GR,如 TIGER)之所以打过传统 item-ID 模型(如 SASRec),是因为它「泛化能力更强」。但以往的证据都停留在「整体 NDCG 更高」这种表面对比,没人说清楚到底是哪一类样本被 GR 做对了。
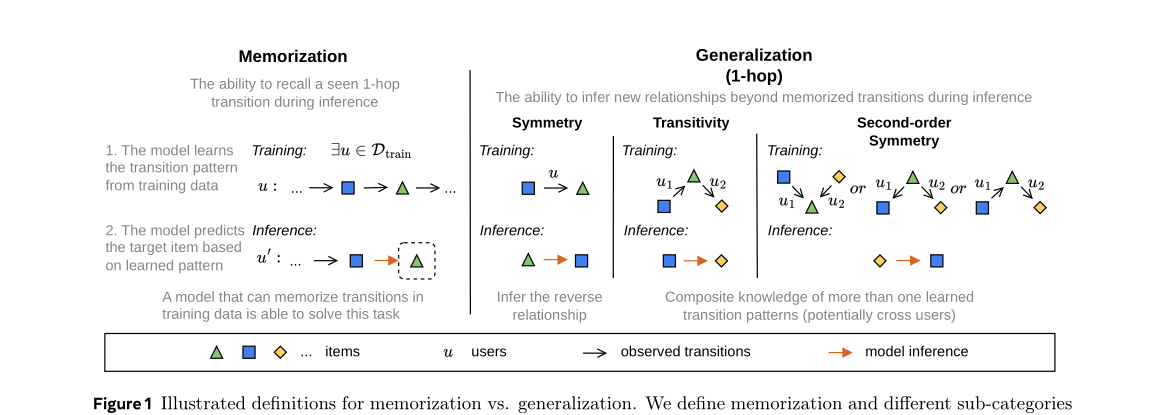
这篇论文做的事情是把「整体性能」这个黑箱拆开。它的关键动作是:不看单个 target item 冷不冷门,而是看「item transition(从历史 item 到 target item 的有向转移)」在训练集里有没有被观测过。基于此把每条测试样本归类:
- 记忆类(Memorization):要预测的 1-hop 转移
[i_{t-1} → i_t]在训练集里出现过(不管在哪个用户身上) → 只靠死记训练数据就能做对。 - 泛化类(Generalization):该转移没被直接观测过,但可以从已观测的转移组合/推断出来(传递性、对称性、二阶对称、可替代性)。
- 未分类(Uncategorized):既非记忆也非泛化,多半是含未见 item / 更高阶模式 / 本质不可预测的样本。
三条核心结论:
- SASRec 善记、TIGER 善推:GR 在泛化子集稳定领先(部分数据集 +50%~+58%),item-ID 在记忆子集领先(部分数据集 SASRec 比 TIGER 高 35%~44%)。
- item 级泛化 ≈ token 级记忆:把视角从 item 转移降到 semantic-ID 的 prefix n-gram 转移上,大量被判为 item 级「泛化」的样本,其实在 token 前缀层面是「记忆」——这解释了 GR 泛化能力的来源,也解释了它为什么反而记不住具体 item。
- 两种范式互补:用一个免训练的 MSP(最大 softmax 概率)指示器估计样本「有多像记忆类」,按样本自适应加权融合 SASRec 与 TIGER,稳定优于两个单模型与固定权重融合。
整体实现思路
整篇论文是一个「分析框架 + 机制解释 + 落地方法」三段式:
- 第 2 节(定义):给出顺序推荐的形式化,把「item transition」作为研究单位,定义记忆类、三种 1-hop 泛化类(传递/对称/二阶对称)、多 hop 泛化(含可替代性 Substitutability),并对每条测试样本打标(可多标,按 Occam’s razor 取最小 hop)。
- 第 3 节(性能拆解):在 7 个公开数据集上,把 TIGER 与 SASRec 的 NDCG@10 按记忆/泛化/未分类子集分别报告 → 得出「SASRec 记、TIGER 推」的核心现象。
- 第 4 节(机制分析):引入 prefix n-gram memorization 概念,把 item 转移降维到 semantic-ID 前缀转移;证明 (a) token 记忆支持度越高 → 泛化越好;(b) token 记忆会「稀释」item 记忆(多个 item 共享同一前缀,概率质量被摊薄);再用 codebook size 做受控实验直接操纵 token 记忆比例验证因果。
- 第 5 节(落地方法):免训练 MSP 指示器 + sigmoid 映射成 per-instance 权重 → 自适应集成 → 在 7 数据集上验证收益。
子模块实现(可复现细节)
形式化与数据打标
- 顺序推荐:用户
u = [i_1,…,i_{t-1}],预测下一个i_t。标准 leave-last-out 切分(最后一个测试、倒数第二验证)。 - item transition:有向对
[i_s → i_t],s < t;hop count = t − s。一条样本(u, i_t)由它包含的所有{[i_s → i_t], i_s ∈ u}集合刻画。 - 记忆类定义:
(u,i_t) ∈ D_mem ⟺ ∃ u' ∈ D_train, [i_{t-1} → i_t] ⊆ u'(1-hop 转移在训练集任意用户出现过)。 - 传递性 Transitivity(非记忆且):
∃ x, ∃ u',u'' ∈ D_train, [i_{t-1}→x] ⊆ u' ∧ [x→i_t] ⊆ u''(经中间 item x 桥接两条观测转移)。 - 对称性 Symmetry:
∃ u' ∈ D_train, [i_t → i_{t-1}] ⊆ u'(反向转移被观测过)。 - 二阶对称 2nd-Order Symmetry:经中间 item x 以非传递方式关联,三种形态之一成立——(1) 共因
[x→i_{t-1}] ∧ [x→i_t];(2) 共果[i_{t-1}→x] ∧ [i_t→x];(3) 反向路径[i_t→x] ∧ [x→i_{t-1}]。 - 可替代性 Substitutability(仅多 hop):
∃ k≥2, ∃ u' ∈ D_train, [i_{t-k}→…→i_t] ⊆ u'。作者论点:「多 hop 记忆」本质是泛化(要绕过无关中间 item、选对多 hop 转移),故单列为泛化类。 - 多 hop 扩展:同一逻辑套到多 hop 转移;一条样本若多 hop 都满足某泛化类,取最小 hop 归类。实验最大 hop = 4。
- 三大类互斥:记忆 / 泛化 / 未分类的占比和 = 100%;但一条样本可同时属于多个泛化子类,故泛化子集占比之和可能 > 「All」。
Prefix N-Gram Memorization(token 级透镜)
这是机制分析的核心创新点。GR 把每个 item tokenize 成共享的 semantic-ID token 序列 tok(i) = [z_1,…,z_L],semantic ID 是**层次化(粗到细)**的,所以前缀转移捕捉了最主要的语义依赖。
- 前缀算子:
pref_n(i) ≜ [z_1,…,z_n](取前 n 个 token)。 - 1-hop prefix n-gram memorization 定义:
(u,i_t)满足,当∃ u' ∈ D_train, ∃ s≥2, [j_{s-1}→j_s] ⊆ u',且pref_n(i_{t-1}) = pref_n(j_{s-1})与pref_n(i_t) = pref_n(j_s)同时成立——即target 转移两端 item 的前 n token 前缀都在训练里出现过,哪怕具体 item 不同。 - k=1 时是「记忆」的松弛版;k>1 时类比「可替代性」。后文统称 token memorization。
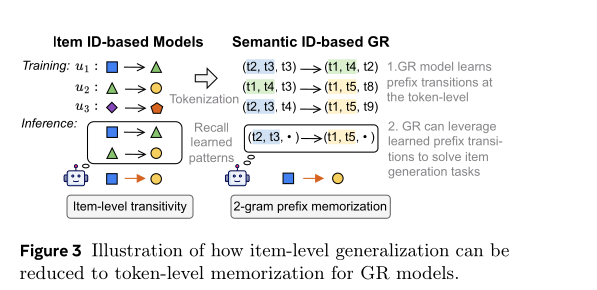
- token 记忆支持度:
C_n(i_{t-k}, i_t) = C(pref_n(i_{t-k}) → pref_n(i_t))(前缀转移在训练集的计数);对一条样本聚合所有 k-hop:C_n(u,i_t) = Σ_{k=1}^K C_n(i_{t-k}, i_t)。
稀释效应的量化(为什么 GR 记不住具体 item)
定义两个经验概率,对转移 i_{t-1}→i_t:
- item 转移概率
ϕ = C(i_{t-1}→i_t) / C(i_{t-1}→·)(在所有从 i_{t-1} 出发的转移里命中 i_t 的比例)。 - prefix 转移概率
ψ = C(pref_n(i_{t-1})→pref_n(i_t)) / C(pref_n(i_{t-1})→·)。
机制:SASRec 直接优化具体 i_{t-1}→i_t;TIGER 通过被很多 item 共享的前缀转移来预测,概率质量摊到一堆同前缀 item 上 → 高 ϕ 但低 ψ 的样本上 TIGER 显著掉点(ΔNDCG 为负);只有 ψ 也高(token 记忆对齐)时 TIGER 才在 item 记忆上追平甚至反超 SASRec。
受控实验:用 codebook size 操纵 token 记忆比例
直觉:codebook 越小(越稠密)→ 前缀越容易被多 item 共享 → token 记忆样本比例越高。
- 设置 SID 长度
L ∈ {2,3,4,5}(含 1 个 identifier token),每个 L 配两个 codebook size V;固定推荐模型规模、匹配每个 L 内的训练算力预算(估到记忆与泛化指标在验证集都不再上升的收敛点)。 - 只在同一 L 内比较(不同 L 难度不同、过长 SID 有优化问题),控制变量干净。
- 量化:小 V 的 token 记忆比例显著更高(如 L=4, V=64 时 n=4 比例 7.68% / n=2 比例 46.26%;V=1024 时 n=2 降到 21.34%)。
自适应集成(落地方法)
- 挑战:第 2.2 节的记忆判据需要 target item,推理时拿不到。
- MSP 置信度指示器:用 item-ID 模型(SASRec)预测分布的最大 softmax 概率当记忆似然代理(记忆类样本更靠近训练分布、ID 模型预测更自信):
s_Conf(u) = max_{j∈I} P_ID(i_t=j | u)。 - 权重映射:
α(u) = sigmoid(−q · (s_Conf(u) − τ)),q, τ为超参。α(u) 是赋给 SASRec(记忆侧)的权重,最终分数按 α 融合两个 base 模型。 - 超参搜索:
q ∈ {1,5,9,13},τ ∈ {0,0.1,…,0.5};固定权重基线α_static ∈ {0,0.1,…,1.0}。验证集调参。
实验设置与结果
数据集(7 个公开):Amazon-2014 的 Sports / Beauty;Amazon-2023 的 Science(Industrial&Scientific)/ Music / Office;Steam;Yelp。规模从 2.2 万用户(Beauty)到 22.3 万用户(Office),稀疏度均 >99.8%,平均序列长 812.5。
模型:TIGER(GR 范式,256×3 semantic ID 量化 + 1 个 identifier token)vs SASRec(传统 item-ID)。公平性处理:SASRec 用 cross-entropy loss、全量 item 当负样本(follow Liu et al. 2025a),而非原 TIGER 论文的单负采样。学习率搜 {1e-3, 3e-3},最多 150 epoch + early stopping,验证集最优 checkpoint 测试。指标:NDCG@10(拆解分析)、N@10/R@10(集成)。
主结果 1:记忆/泛化性能拆解(NDCG@10,节选)
| 数据集 | 模型 | Mem.(记忆) | 泛化 All(各子类汇总趋势) |
|---|---|---|---|
| Sports | SASRec | .2816 | 弱于 TIGER |
| Sports | TIGER | .1656 | 更强(泛化整体 +39.8%) |
| Beauty | SASRec | .3793 | 弱于 TIGER |
| Beauty | TIGER | .2456 | 更强(泛化 +56.7%) |
| Office | SASRec | .2405 | 弱于 TIGER |
| Office | TIGER | .2719 | 更强(泛化 +58.8%) |
| Yelp | SASRec | .2487 | — |
| Yelp | TIGER | .1402 | 记忆 −43.6% |
关键 takeaway:
- TIGER 在记忆子集普遍弱于 SASRec(Yelp −43.6%、Sports −41.2%、Beauty −35.2%,其余相当);在泛化子集稳定强于 SASRec。
- 两模型在记忆子集的绝对分都远高于泛化子集 → 泛化本身就难。两模型在未分类子集都接近 0 → 验证了打标合理性(未分类确实难预测)。
- 泛化子类难度:可替代性 & 对称性(单条训练样本即可归纳)> 传递性 & 二阶对称(需组合多条样本)。
- hop 越大性能单调下降;低 hop 时 SASRec 偶尔反超 TIGER,但 hop 增大后 SASRec 掉得更快,尤其在传递/二阶对称这种难类 → SASRec 主要在局部上下文泛化,TIGER 长 hop 更鲁棒。
- 数据占比:所有数据集里记忆样本占比都远小于泛化样本(纯记忆的天花板有限);泛化里大多需组合多条训练样本(单样本可推的可替代性/对称性只占小头);未分类一致 <10%。
主结果 2:token 记忆机制验证
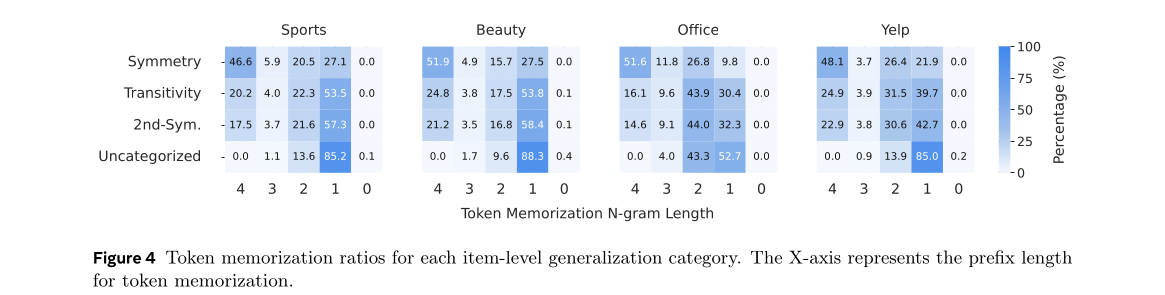
- item 泛化常归约为 token 记忆:跨数据集,>99% 的测试样本至少满足 1-gram 前缀记忆;平均 >5% 的 item 级泛化转移(对称/传递/二阶对称)可被 3-hop 前缀记忆解释(见 Fig 4 热力图)。对称类有更高的 4-gram 记忆比例(与可替代性重叠);传递/二阶对称多归约到短前缀(2~3 gram),前缀支持弱 → 任务更难;未分类几乎只剩 1-gram 记忆(最弱支持)。
- token 记忆支持度 ↑ → 泛化 ↑:有前缀支持的样本 NDCG@10 显著高于无支持样本;TIGER 相对 SASRec 的增益随支持计数 C_n 和前缀长 n 增大而增大。
- token 记忆稀释 item 记忆:高 ϕ 低 ψ 区域 TIGER ΔNDCG 显著为负;ψ 高时 TIGER 可反超 SASRec。
- 受控实验:小 codebook(更稠密、token 记忆比例更高)平均把泛化提升 +10.24%(相对),同时记忆下降 −7.62%(相对),跨所有测试 codebook size 一致。且大 V 时泛化性能早峰后退化(过拟合 item-specific 噪声转移),小 V 时泛化稳定或持续上升 → 稠密 tokenization 有数据级正则化效应。
主结果 3:自适应集成(N@10 / R@10)
| 指标 | 方法 | Sports | Beauty | Science | Music | Office | Steam | Yelp |
|---|---|---|---|---|---|---|---|---|
| N@10 | SASRec | .0253 | .0436 | .0209 | .0291 | .0190 | .1525 | .0321 |
| N@10 | TIGER | .0237 | .0383 | .0243 | .0323 | .0254 | .1551 | .0257 |
| N@10 | Fixed-weight | .0291 | .0471 | .0260 | .0343 | .0261 | .1579 | .0351 |
| N@10 | Adaptive | .0296 | .0476 | .0261 | .0344 | .0264 | .1579 | .0352 |
| R@10 | Fixed-weight | .0530 | .0838 | .0483 | .0635 | .0456 | .2008 | .0630 |
| R@10 | Adaptive | .0537 | .0841 | .0485 | .0638 | .0461 | .2008 | .0637 |
- 自适应集成在几乎所有数据集 / 指标上优于两个单模型与固定权重融合 → 实证两范式互补。
- MSP 指示器有效性验证:指示器值越大,记忆类样本占比单调上升;且随指示器值增大出现 TIGER↔SASRec 性能交叉(低值 TIGER 赢、高值 SASRec 赢),与假设一致。
- 收益在交叉效应越强的数据集越明显——每个 base 模型在各自擅长域优势越大,记忆感知指示器越能利用这种专长。
思考与可参考价值
局限:
- 只对比了 TIGER vs SASRec 两个代表模型,未覆盖工业级 GR(OneRec/PLUM/HSTU 这类)或更复杂 tokenizer;结论是否在十亿参数 / 长序列场景成立未验证。
- 「记忆 vs 泛化」的打标依赖 1-hop 转移精确匹配 + 最大 hop=4 的窗口,本质是基于共现统计的代理,未做反事实因果验证(作者也明确说反事实记忆太贵)。
- 自适应集成只是后处理 ensemble,需要同时部署两个模型,推理成本翻倍;MSP 指示器只用了 item-ID 模型的置信度,没用 GR 侧信号。
- semantic ID 配置固定在 256×3,稀释效应的结论与具体 tokenizer / codebook 强相关。
对电商 / 搜推 / Agent 的可借鉴点:
- 「转移级」而非「item 级」的难度刻画是个很实用的诊断工具。在电商场景可以直接把线上样本按「这个 query→item / item→item 转移在训练集见没见过」拆开看离线指标,定位到底是模型记不住热门链路、还是推不出长尾组合,比单看整体 AUC/NDCG 信息量大得多。
- 稠密 codebook = 数据级正则这个发现可落地:当 semantic ID 泛化掉点/过拟合时,缩小 codebook size 提高前缀共享率,可能比加显式正则更直接;反之业务若更吃「记住爆款具体转移」,反而该用更大 codebook(更稀疏、更接近 item-ID)。这给 semantic ID 的容量配置提供了「记忆 vs 泛化」的旋钮直觉。
- **稀释效应(ϕ 高 ψ 低掉点)**提醒:GR 在高频具体转移上会被「同前缀邻居」摊薄概率,工业场景里热门商品的精确召回可能反被 semantic ID 拖累——可以考虑对高 ϕ 样本保留 item-ID 通路(正是本文集成做的事)。
- 免训练 MSP 自适应集成思路轻量、易迁移:用一个便宜模型的置信度当「路由器」,按样本在「记忆专家(ID 模型)」与「泛化专家(GR 模型)」间软路由,工程上比训练一个 gating 网络省事,且收益集中在两专家分化大的数据集——这对「冷启 vs 高频」并存的电商流量天然友好。
- 对 Agent / LLM4Rec:本文「item 级泛化 ≈ token 级记忆」的拆解方法论,可推广到任何 tokenize-then-generate 的系统——评估一个生成式系统「真泛化」还是「token 拼接式记忆」,值得在自家 semantic ID / action tokenizer 上做同款 prefix n-gram 审计。