HLLM: Enhancing Sequential Recommendations via Hierarchical Large Language Models for Item and User Modeling
ByteDance
用两层非共享 LLM 做序列推荐:Item LLM 把商品文本压成一个 [ITEM] token 的 embedding,User LLM 把这串 item embedding 当输入序列做 next-item 预测。把"文本进文本出"的低效 LLM4Rec 改成"embedding 进 embedding 出",序列长度回到 ID 模型量级,复杂度大降;并系统回答了预训练权重有没有用、要不要微调、能不能 scale 三个问题。
核心思路
主流序列推荐是 ID-based(SASRec/HSTU 等):item/user 转 ID 查 embedding 表,模型小、靠 embedding 参数撑容量,冷启差、表达浅。直接把 LLM 套进推荐又有两条死路:(1) 把用户行为历史摊成纯文本喂 LLM,序列极长,self-attention 是 O(L²),同样时间跨度的行为 LLM 需要的 token 数远多于 ID 模型;(2) 推一个 item 要生成多个文本 token、多次 forward,serving 极慢。结果就是现有 LLM4Rec 相比传统模型只有”微弱提升”。
HLLM 的核心是分层解耦 + 表征化:
- Item LLM:只负责把单个商品的文本描述(title/tag/description 拼成一句话 + 固定 prompt + 末尾追加特殊 token
[ITEM])压成一个 embedding(取[ITEM]位最后一层 hidden state)。这一步把”长文本”压成”一个向量”。 - User LLM:输入是用户历史交互对应的 item embedding 序列
{E1,...,En}(不是文本 token,而是 Item LLM 产出的向量),输出位置 i 预测下一个 item 的 embeddingE'_{i+1},做 next-item prediction。
这样用户序列长度就回落到 ID 模型的量级(n 个 item = n 个 token),把 O(L²) 里的 L 从”文本 token 数”砍到”行为数”。两个 LLM 参数不共享、都可训练。
论文同时把三个被回避的问题摆上台面并用实验回答:预训练权重对推荐到底有没有价值(有,且和预训练 token 数正相关);要不要面向推荐目标微调(必须,冻结任一侧都崩);LLM 在推荐里能不能 scale(能,1B→7B 持续涨,数据 0.1M→8M 持续涨,无瓶颈)。
整体实现思路
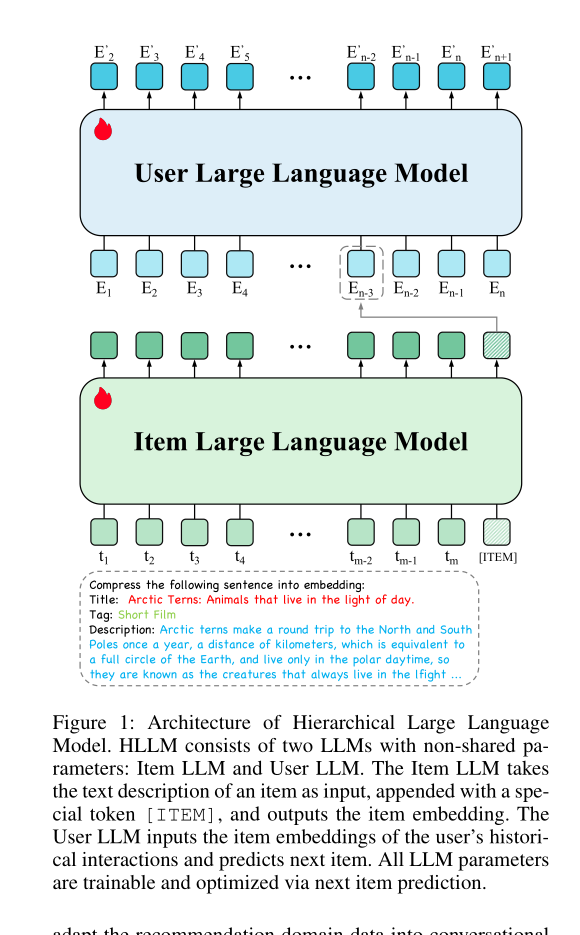
问题定义:给定用户 u 的按时间排序历史交互 U={I1,...,In},预测下一个 item I_{n+1}。每个 item 有 ID 和文本(title/tag 等),但 HLLM 只用文本(ID 仅在兼容性实验里作为补充特征)。
整体两段式:
- Item 侧:把 item I 的文本属性 flatten 成句子 T,前面拼固定 prompt(“Compress the following sentence into embedding:”),过 tokenizer 后末尾加
[ITEM],输入 Item LLM 得{t1,...,tm,[ITEM]},最后一层[ITEM]位的 hidden state 即 item embedding。 - User 侧:把
U经 Item LLM 转成特征序列{E1,...,En},喂 User LLM,位置 i 输出E'_{i+1}应等于E_{i+1}。因为输入输出都是 embedding(不是词),所以丢掉预训练 LLM 的 word embedding 层,保留其余全部预训练权重。
面向推荐目标训练分两类,架构通用、只换 loss:
- 生成式推荐(Generative,离线用):next-item prediction + InfoNCE。沿用 HSTU(Zhai et al. 2024)的检索/排序训练-serving 范式,差别只是骨干换成带预训练权重的 LLM、输入特征从 ID 换成文本-LLM 特征。
- 判别式推荐(Discriminative,在线 A/B 用):判断 (用户序列 U, 目标 item I_tgt) 是否点击/喜欢/购买,二分类 BCE。两种融合变体(早融/晚融)。
子模块实现(可复现细节)
Item LLM(特征抽取器)
- 输入:固定 prompt + flatten 文本(title/tag/description),tokenizer 后追加
[ITEM]。每个 item 文本长度截断 max=256 token。 - 输出:
[ITEM]位最后一层 hidden state,作为 item embedding。 - 抽取方式消融(Table 10):
[ITEM]token 优于 mean pooling(R@5 3.484 vs 3.386;N@5 2.319 vs 2.257)。直接拿 next-token 预训练的 LLM 做 mean-pooling 特征抽取器效果差,必须微调。 - 文本丰富度/长度消融(Table 9):文本内容影响巨大。只给 Tag(无 Title/Description)几乎崩(R@5=0.082);逐步加 Title、Description,长度从 64→256,R@5 从 3.52→3.755,N@5 从 2.348→2.513。越丰富越长,item 区分度越好。
User LLM(兴趣建模器)
- 输入:item embedding 序列;丢弃 word embedding 层,保留其余预训练权重。
- 输出:每个位置预测下一个 item embedding。
- 输入特征消融(Table 12, Pixel1M):
Item ID(查表 embedding)R@5=4.105;LLM Emb(文本特征)5.201,显著更好;LLM Emb + Item ID反而略降(5.154),说明 ID 在文本已充分描述时无增量;LLM Emb + Timestamp大涨到 5.779,时间戳是文本无法覆盖的互补信息。 - 序列长度(Table 11, Pixel1M):10→50 仅微涨(学术集用户序列本身短);工业集(Table 13)200→1000,AUC 0.7429→0.7458 稳定涨,长序列才显威力。
时间戳编码(Algorithm 1,可直接抄)
把 timestamp 拆成 year/month/day/hour/minute/second 6 个分量,各自 nn.Embedding(vocab 分别 2100/13/32/24/60/60,dim=512),concat 成 512×6 再过一个 MLP 投到 user_dim=2048,与 item LLM embedding sum pooling 后送 User LLM。time_num=4 精度到小时、=6 到秒。
损失函数
- 生成式 InfoNCE(式1):对 User LLM 输出序列里每个预测
E'_{j,i},正样本是对应真实E_{j,i},负样本从数据集中(排除当前用户序列)随机采。s 为带可学习温度的相似度函数。 - 判别式 BCE(式2):
L_cls = -(y·log(x)+(1-y)·log(1-x))。 - 联合(式3):next-item 作辅助 loss:
L_dis = λ·L_gen + L_cls,λ 控制辅助权重,经验上能进一步提点。
判别式两变体
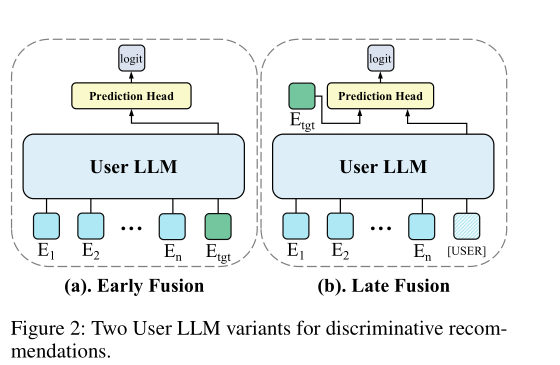
- Early Fusion:目标 item embedding
E_tgt接到用户序列末尾 → User LLM 出高阶交叉特征 → 预测头出 logit。效果好(user 与 target 深度交互),但每个候选都要重算 User LLM,难以同时跑大量候选。 - Late Fusion:序列末尾加
[USER]token 抽与目标无关的用户特征,用户特征 + 目标 item 一起进预测头。效率高(同一用户特征被所有候选复用),但通常掉点。在线 A/B 选 Late Fusion。
模型配置
- HLLM-1B:Item 与 User LLM 都用 TinyLlama-1.1B。
- HLLM-7B:都用 Baichuan2-7B。
- lr=1e-4;PixelRec batch=512、max seq=10、正负比 1:5632;Books batch=128、max seq=50、负样本 512。HLLM 只训 5 epoch(baseline 训 50/200 epoch)。
- 公平对比实现:SASRec-1B(把网络换成 TinyLlama-1.1B)、HSTU-1B(同 hidden/层数但去掉传统 FFN,仅 462M 参数)。
实验设置与结果
数据集:PixelRec 三个子集(200K/1M/8M)+ Amazon Book Reviews(Books),leave-one-out 切分,指标 Recall@K / NDCG@K。
| 数据集 | #User | #Item | #Interaction |
|---|---|---|---|
| Pixel200K | 200,000 | 96,282 | 3,965,656 |
| Pixel1M | 1,001,822 | 100,541 | 19,886,579 |
| Pixel8M | 8,886,078 | 407,082 | 158,488,652 |
| Books | 694,898 | 686,624 | 10,053,086 |
Baseline:ID-based SASRec、HSTU;文本-based LEARN。
RQ1 预训练 + 微调(Pixel200K, HLLM-1B)
预训练权重对 Item 和 User LLM 都有用(Table 2):
| Item LLM | User LLM | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|---|
| Scratch | Scratch | 3.330 | 5.063 | 2.199 | 2.755 |
| Scratch | Pre-trained | 3.556 | 5.416 | 2.371 | 2.969 |
| Pre-trained | Scratch | 3.521 | 5.331 | 2.358 | 2.940 |
| Pre-trained | Pre-trained | 3.755 | 5.581 | 2.513 | 3.100 |
预训练 token 数越多越好(Table 3):0T→3T,R@5 3.330→3.755,且与常识推理 CSR 分(46→53)正相关。但 1T+chat(在对话数据上 SFT)略掉点——世界知识主要来自预训练,对话 SFT 加的是指令跟随能力,对推荐无益。
微调不可省(Table 4):冻结任一侧都崩。冻 Item LLM(mean pooling 作特征)R@5=0.588,冻 User LLM R@5=1.619,都不如 SASRec-1B(1.973);全可学才 3.755。结论:next-token 预训练的 LLM 不能直接当推荐特征抽取器,必须面向推荐目标全微调。
RQ2 Scaling(Pixel200K / Books / Pixel8M / 工业集)
- Item 模型放大(Table 5,User 固定 SASRec):BERT-Base 110M R@5=2.576 → BERT-Large 340M 3.032 → TinyLlama 1.1B 3.484。
- User 模型放大(Table 6,Item 固定 TinyLlama):SASRec 4M 3.484 → Llama-2L 0.1B 3.494 → TinyLlama 1.1B 3.521。
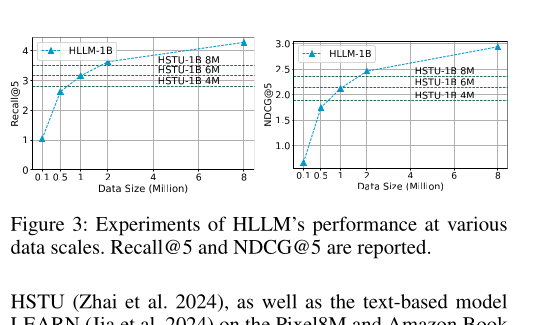
- 数据量 scaling(Figure 3,Pixel8M 采样 0.1M→8M):持续涨,无瓶颈;HLLM-1B 只需 ID 模型 1/6~1/4 的数据量即可追平。
- 工业集(Table 14,AUC):Item×User = 1B×1B 0.7458 → 1B×7B 0.7498 → 7B×1B 0.7517 → 7B×7B 0.7533,双侧放大都涨。
RQ3 vs SOTA(Table 7,关键数字)
| 数据集 | 方法 | R@10 | R@200 | N@10 | N@200 | Impv.(avg) |
|---|---|---|---|---|---|---|
| Pixel8M | HSTU* | 4.848 | 18.327 | 2.752 | 5.135 | +0.0% |
| Pixel8M | HSTU-1B* | 5.120 | 19.393 | 2.879 | 5.411 | +5.37% |
| Pixel8M | SASRec-1B* | 5.142 | 19.044 | 2.915 | 5.383 | +4.83% |
| Pixel8M | HLLM-1B | 6.129 | 21.179 | 3.539 | 6.221 | +22.93% |
| Books | SASRec | 3.06 | 14.31 | 1.64 | 3.62 | +0.0% |
| Books | LEARN | 4.07 | 18.74 | 2.24 | 4.83 | +34.42% |
| Books | HSTU-large | 4.78 | 19.08 | 2.62 | 5.17 | +47.80% |
| Books | HLLM-1B | 6.97 | 24.78 | 3.98 | 7.16 | +108.68% |
| Books | HLLM-1B†(大负样本 28k/bs512) | 9.28 | 27.22 | 5.65 | 8.89 | +166.42% |
| Books | HLLM-7B† | 9.39 | 27.59 | 5.69 | 8.99 | +169.58% |
要点:HLLM 在所有指标全面领先;ID 模型放大几乎不涨(SASRec-1B 在 Books 甚至全面下降),而 HLLM 1B→7B 仍持续涨。增大负样本数/batch(†:512/128→28k/512),HSTU-large 的 R@200 只 +0.76,HLLM-1B +2.44。
RQ4 效率
- 训练数据效率:HLLM 只需 ID 模型 1/6~1/4 数据量追平。
- Item caching(Table 8, Pixel8M):先在 >10 长度序列上预训 HLLM(截到第 10 位防泄漏,覆盖 3M 用户),再冻 Item LLM、只微调 User LLM。HLLM-1B_cache R@5=3.585 > HSTU-1B 3.501,仍超 ID 模型;全微调 HLLM-1B 4.278 更高。因工业场景用户行为量远大于 item 量,缓存 item embedding 后训练/serving 成本可与 ID 模型持平。
- 在线三阶段 + 离线缓存(Figure 3 文中):item embedding 在 item 创建时算好,user embedding 每天只为前一天有活跃的用户更新,在线推理时延几乎不变。
在线 A/B(抖音排序)
- 工业集:抖音 3 年日志构造 3000 万样本(用户历史点击序列 + 目标 item + 点击 label),判别式 + Late Fusion。
- 三阶段训练:Stage I 端到端训全部参数(序列截到 150 加速);Stage II 用 Stage I 的 Item LLM 离线编码全量 item 存储,只训 User LLM,序列从 150 扩到 1000;Stage III 冻结 HLLM,抽全量 user 特征 + item embedding + 其他特征喂在线推荐模型训练。
- 排序任务关键指标 +0.705%。
思考与可参考价值
对电商/搜推的可借鉴点:
-
“文本→单 embedding”是把 LLM 塞进序列推荐的关键工程取舍。把 item 文本压成一个
[ITEM]token 向量,让用户序列长度回落到行为数级别,是 HLLM 能在工业落地的根本——比”行为摊成长文本”省掉一个量级的 attention 开销。电商商品有丰富的标题/类目/属性/详情文本,正是 Item LLM 的理想输入,且 Table 9 证明文本越丰富越长越好,值得把商品结构化属性尽量 flatten 进去。 -
Item caching + 三阶段训练是直接可抄的落地配方。item 数远小于行为数、且 item 内容相对稳定,故 item embedding 离线算好缓存、只在线训 User LLM,serving 时延几乎不变。这套”item 创建时编码 / user 每日增量更新 / 冻结后喂下游模型”的架构对任何想上 LLM4Rec 的团队都是低风险路径。
-
ID 不是必须,但时间戳是强补充。Table 12 显示加 Item ID 反而掉点(文本已覆盖),但加 timestamp 大涨。落地时不必纠结引入 ID embedding,但行为时间、停留时长等”文本覆盖不到的行为信号”应优先补进 User LLM(Algorithm 1 的分量式时间编码可直接用)。
-
微调 > 直接用预训练。结论很硬:冻结 LLM 当现成特征抽取器在推荐上不 work,必须面向推荐目标全微调;对话 SFT 数据甚至有害。想用 LLM 做推荐别只做 prompt/zero-shot,要舍得训。
-
Agent/多目标视角:早融/晚融的权衡(精度 vs 候选复用效率)对 Agent 驱动的排序/重排同样适用——粗排用晚融(用户特征复用),精排小候选集用早融(深度交叉)。
局限:
- 学术集用户序列短,序列长度收益不明显,长序列优势主要在工业集体现,外部复现需自有长序列数据。
- 在线只验证了判别式 Late Fusion 排序 +0.705%,生成式检索的线上收益未报告。
- 7B 已是资源上限,更大规模 scaling、以及多模态(图像/视频 item)扩展未触及(Pixel 本是图像集,但这里只用文本)。
- Item LLM 全量重编码成本高,依赖 item caching 才能落地,新 item 冷启时仍需实时编码。
- 负样本数/batch 对结果影响极大(†设置带来巨大增益),公平对比时需对齐该配置。