Unleashing the Native Recommendation Potential: LLM-Based Generative Recommendation via Structured Term Identifiers
Kuaishou (快手)
生成式推荐的 item identifier 之争给出第三条路:不用 raw title(会幻觉、判别力弱),也不用 Semantic ID(要扩词表 + 对齐训练、跨域不通),而是把每个 item 压成 5 个标准化英文关键词「Term ID」,全部来自 LLM 原生词表。靠「邻域 in-context」生成全局一致 + 局部判别的 TID,再用「item→TID 内化 + 序列预测」多任务 SFT 把开放词空间收敛到语义子空间,配双级弹性 grounding。Amazon 上 in-domain Recall@5 提升 7.8%~30%,跨域平均提升 50%+,有效率/直命中率 >99% 几乎无幻觉,且 K=3000 压缩词表精度只掉 <1%。
核心思路
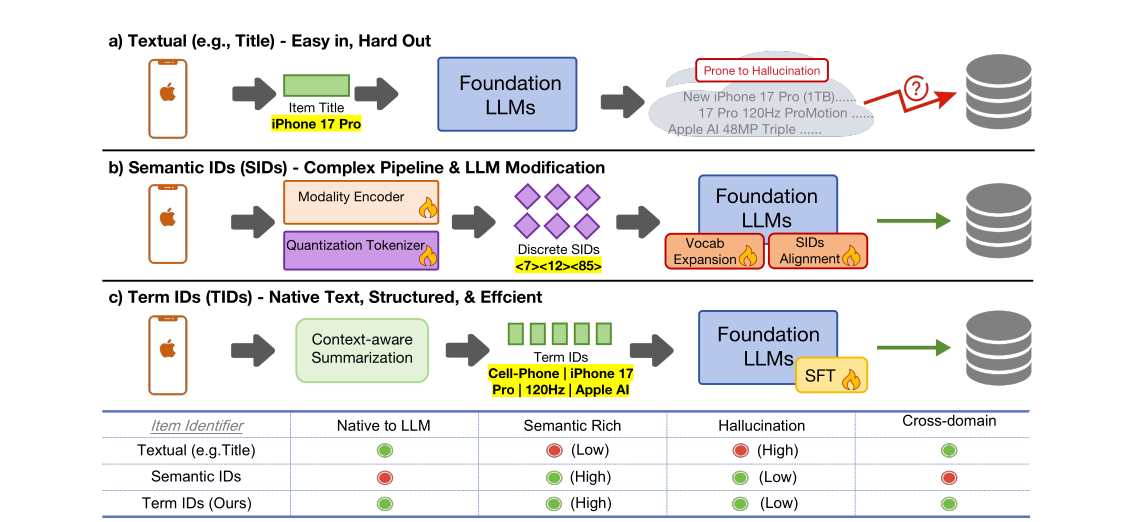
一句话问题: 当用预训练 LLM 做生成式推荐(GR)的 backbone 时,最核心的卡点是 item identifier 怎么设计——既要让 LLM 在参数空间里表示不断涌现的海量 item,又要在自回归生成时把 token 可靠地 ground 回真实 item。现有两条路都有硬伤:
- Textual ID(title / description): 直接用 LLM 原生词表,但 raw title 判别力不足、full description 太长不利于序列建模,且输出空间巨大极易幻觉,常需约束解码 + 固定候选集兜底,称不上真正的生成式。
- Semantic ID(SID): 把 item embedding 量化成离散码
<7><12><85>,但这些数字码不在 LLM 预训练词表里,存在语义鸿沟,要付出昂贵的词表扩展 + 对齐训练;且数字码本身无通用语义,天然 domain-specific,跨域推荐严重失效。
GRLM 的答案: 引入 Term ID(TID)——把每个 item 压成一组语义丰富、标准化的英文关键词(论文固定长度 5,如 perfume | feminine | oriental | woody | calvin-klein)。TID 完全来自 LLM 原生词表,因此天然兼容、语义丰富、无需改架构/扩词表,且因为是自然语言、跨域时不同品类共享词表(“Portable”、“Ergonomic” 当语义桥),实现 zero-effort 知识迁移。
三个关键设计(对应三阶段):
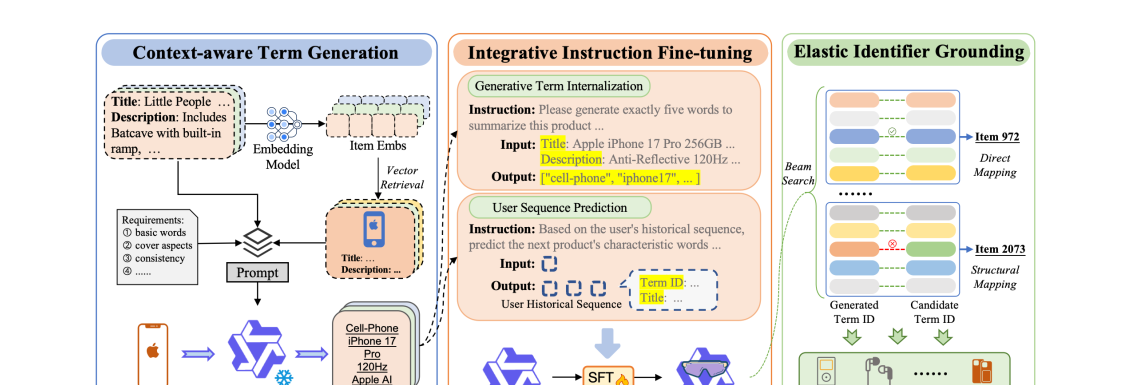
- Context-aware Term Generation (CTG): 不是孤立地给每个 item 生成关键词,而是检索 top-k 相似邻居作为 in-context 参考,让 LLM 对共享属性用一致术语(全局一致,避免 “Cell-Phone” vs “Mobile-Phone” 碎片化)、对独特属性刻意选判别性词(局部判别,避免两个不同 iPhone 都标成 “iPhone”)。
- Integrative Instruction Fine-tuning (IIFT): 多任务 SFT,联合优化「item metadata → TID 内化(GTI)」和「用户行为序列预测」,把 LLM 巨大的开放词空间收敛/蒸馏到一个聚焦的语义子空间。
- Elastic Identifier Grounding (EIG): 推理时双级映射——先精确直映射(Direct Mapping),失败则利用 TID 可分解的结构做结构映射(Structural Mapping),保证近乎 100% 的有效 grounding。
整体实现思路
三阶段流水线,全程围绕 Term ID:
- 阶段 1(CTG,离线一次性): 用冻结的 Qwen3-4B-2507 + Qwen3-Embedding-8B,把每个 item 的 metadata 转成长度 5 的标准化 TID。LLM 参数在此阶段 frozen。
- 阶段 2(IIFT,训练): 对 Qwen3 backbone 做全参数 SFT,两个任务混合:GTI(item metadata → TID)让模型内化 identifier 结构;序列预测(历史 → 下一 item 的 TID)学个性化偏好。
- 阶段 3(EIG,推理): 模型只生成下一 item 的 TID(不生成 title,省推理开销),beam search 出候选 TID 序列,经双级映射落地到真实 item。
子模块实现(可复现细节)
3.1 Context-aware Term Generation (CTG)
目标: 标准化 identifier 时同时满足「相似 item 术语一致(防碎片化)」与「不同 item 保持判别(防语义碰撞)」。孤立生成两者都做不到。
流程:
- 对每个 item
i,聚合其 metadatam_i,用预训练 embedding 模型(Qwen3-Embedding-8B)编码成稠密向量v_i ∈ R^d。 - 计算
i与候选库中所有j的 cosine 相似度,取 top-k 最相似的邻居构成上下文集N_i = {j_1,...,j_k}。 - 构造结构化 prompt
P,把 itemi的 metadata 和邻居{m_j}一起喂给 LLM:
Prompt 设计(附录 Figure 5,可直接复刻): 角色设为 “expert product summarizer”,要求恰好输出 5 个词,约束:
- 词形用 base form(名词/形容词,no -ed/-ing/-s);
- 按重要性排序,内容覆盖 5 个维度:a) 主品类/类型 → b) 关键功能/用途 → c) 显著特征 → d) 目标受众 → e) 独特卖点;
- 提供 TOP 5 相似产品作参考,先找共性用一致术语,再找差异性至少留 1-2 个独特词;
- 输出严格
[word1, word2, word3, word4, word5],无任何额外文本。
设计哲学就是「全局一致 + 局部判别」的平衡:共享属性用标准词,独特属性刻意选判别词。
3.2 Integrative Instruction Fine-tuning (IIFT)
传统方法只做序列预测,会丢失 identifier 的语义 grounding。IIFT 联合优化两任务:
(a) Generative Term Internalization (GTI): 模型直接从 item metadata m_i 生成标准化 T_i,不带 CTG 阶段的邻域上下文。动机是让 LLM 内化生成逻辑,把开放的自然语言输出空间压缩/蒸馏到聚焦的语义子区,建立对 identifier 结构的内在理解。
(b) User Behavior Sequence Prediction(核心推荐任务): 对用户序列 S = {i_1,...,i_n},先把每个 item i_j 表示成 TID 与 raw title 拼接的联合文本序列:
训练为自回归:把第一个 item x_1 当输入 context,后续 {x_2,...,x_n} 拼成输出,最小化输出 token 的 NLL(条件于初始 instruction I):
注意训练时 item 表示含 title(
x_j拼了 TID + title),但推理时只需生成下一 item 的 TIDT_{i_{t+1}}(不生成完整含 title 的x_{t+1}),直接映射回 item,保证高推理效率。
训练超参(附录 A,可复现):
- 全参数 SFT,next-token 目标;
- cosine annealing LR schedule,初始 LR
1e-4,global batch size 128,3 epochs; - scaling 实验各尺寸 LR 单独调:0.6B/1.7B =
2e-4,4B =1e-4,8B =7e-5,14B =5e-5。
3.3 Elastic Identifier Grounding (EIG)
双级检索把生成的 TID 序列映射回推荐 item:
- Direct Mapping: 先在候选库
C里做精确字符串级匹配。模型输出完全对齐某 item 标准 TID 时精度最高。 - Structural Mapping: 若无精确命中,利用 TID 可分解性做结构映射,选使结构得分最大的 item:
t^j_gen 是生成序列第 j 个词,w_j = 1/(j+1) 是衰减权重(靠前的词权重更高,呼应 CTG 里”按重要性排序”)。
实验设置与结果
Backbone: term 生成模型与推荐模型都用 Qwen3-4B-Instruct-2507(CTG 时冻结、IIFT 时全参微调);TID 长度固定 5;推理用 beam search,max generation length = 30。指标 Recall / NDCG @5,@10。
数据集:
- In-domain: Amazon Beauty / Sports / Toys,5-core 过滤 + leave-one-out 划分。
- Cross-domain: 两对 Sports-Clothing(Leisure) 与 Phones-Electronics(Technology),按重叠用户合并两域交互、按时间排序成统一序列,评估时分别预测各域最后一次交互。
| 数据集 | #User | #Item |
|---|---|---|
| Beauty | 22,363 | 12,101 |
| Sports | 35,598 | 18,357 |
| Toys | 19,412 | 11,924 |
| Clothing | 39,387 | 23,033 |
| Phones | 27,879 | 10,429 |
| Electronics | 192,403 | 63,001 |
Baseline: 序列类 SASRec / BERT4Rec;生成类 TIGER / HSTU;LLM 类 OneRec-Think / IDGenRec;跨域专用 TriCDR / LLM4CDSR / GenCDR。
RQ1 主结果(In-domain,Recall/NDCG)
| 数据集 | 指标 | SASRec | TIGER | HSTU | IDGenRec | OneRec-Think | GRLM | 提升 |
|---|---|---|---|---|---|---|---|---|
| Beauty | Recall@5 | 0.0402 | 0.0405 | 0.0424 | 0.0484 | 0.0563 | 0.0607 | +7.82% |
| Beauty | NDCG@10 | 0.0320 | 0.0337 | 0.0353 | 0.0404 | 0.0471 | 0.0506 | +7.43% |
| Sports | Recall@5 | 0.0199 | 0.0215 | 0.0268 | 0.0270 | 0.0288 | 0.0375 | +30.21% |
| Sports | NDCG@10 | 0.0141 | 0.0179 | 0.0226 | 0.0223 | 0.0239 | 0.0313 | +30.96% |
| Toys | Recall@5 | 0.0448 | 0.0337 | 0.0366 | 0.0595 | 0.0579 | 0.0684 | +14.96% |
| Toys | NDCG@10 | 0.0358 | 0.0276 | 0.0309 | 0.0498 | 0.0482 | 0.0561 | +12.65% |
三数据集全指标 SOTA,Recall@5 相对最强 baseline 提升 7.8% / 30.2% / 15.0%。
RQ1 跨域结果(提升更夸张)
| 场景 | 数据集 | 指标 | 最强跨域 baseline (GenCDR) | GRLM | 提升 |
|---|---|---|---|---|---|
| Leisure | Sports | Recall@5 | 0.0274 | 0.0480 | +75.18% |
| Leisure | Clothing | Recall@10 | 0.0265 | 0.0436 | +64.53% |
| Tech | Phones | Recall@5 | 0.0436 | 0.0928 | +112.84% |
| Tech | Phones | NDCG@5 | 0.0411 | 0.0739 | +79.81% |
| Tech | Electronics | Recall@10 | 0.0342 | 0.0529 | +54.68% |
跨域 Recall@K 平均提升 >50%,且 GRLM 不需要任何跨域专用架构或对齐模块(TriCDR/GenCDR 需要)。原因:TID 把 item 映射到统一自然语言语义空间,共享词表当”语义桥”,复用 LLM 预训练世界知识做无缝迁移。
RQ2 消融(in-domain)
| 数据集 | 指标 | w/o CTG | w/o GTI | GRLM |
|---|---|---|---|---|
| Beauty | Recall@5 | 0.0576 | 0.0564 | 0.0607 |
| Sports | Recall@5 | 0.0346 | 0.0361 | 0.0375 |
| Toys | Recall@10 | 0.0857 | 0.0889 | 0.0942 |
去掉 CTG(无邻域上下文)会让生成倾向通用/碎片化词,性能明显下滑;去掉 GTI(无 item→TID 内化任务)说明内化任务对把复杂 metadata 映射进受限 TID 空间很关键,两任务协同保证既学准 item 表征又维持语义空间内的可靠转移。
RQ3 Scaling Law
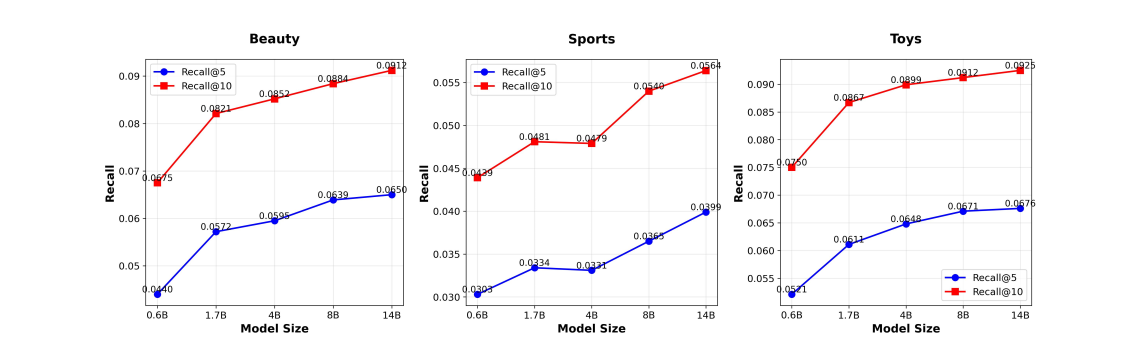
固定 Qwen3-4B-2507 做 term 生成,backbone 换 Qwen3-2504 系列覆盖 0.6B / 1.7B / 4B / 8B / 14B。三数据集 Recall 随参数量稳定提升,符合 LLM scaling law——TID 让更大 LLM 更好地利用其语义推理与开放世界知识。
RQ4 幻觉(关键卖点)
两指标:Valid Rate VR@K(生成 identifier 属于候选库的比例)、Direct Hit Rate DHR@K(EIG 里被精确直映射命中的比例)。
| 数据集 | Beauty | Sports | Toys | Leisure | Technology |
|---|---|---|---|---|---|
| VR@10 | 0.996 | 0.989 | 0.995 | 0.998 | 0.998 |
| DHR@10 | 0.997 | 0.999 | 0.998 | 0.999 | 1.000 |
VR@10 与 DHR@10 全 >99%,说明模型已内化 TID 的结构与语义约束,把输出约束到预定义子空间,几乎消除文本生成式推荐的幻觉瓶颈,且不需约束解码就近 100% 直命中。
附录补充实验
- TID 长度(附录 B / Table 8): 长度 5 vs 7 vs 10——7 与 5 相当,10 反而略降(过长引入冗余噪声、淹没显著特征),叠加推理延迟,经验上选 5 最优权衡。
- 数据可扩展性(附录 D): 合并 10 个 Amazon 子集联合训练,平均 Recall@10=0.0664、NDCG@10=0.0387,相比单数据集训练稳定不掉点(不出现 SID 那种 “id-space crowding”),因为 TID 共享自然语言词表带来跨品类正迁移。
- 语义压缩(附录 D / Table 9): 把 54,255 个原始 term 用 embedding + K-means 压成 K 个 “Core Term”。即便 K=3000(约原始 1/18),性能下降 <1%。证明 GRLM 不依赖记忆细粒度字符串,而是抓高层语义抽象——对超大规模 item 目录的可扩展性极强。
思考与可参考价值
核心洞见: 这篇把”item identifier 该长什么样”的争论推到一个很干净的结论——用 LLM 原生词表里的少量标准化关键词(结构化文本)做 item ID,同时绕开了 SID 的”扩词表 + 对齐训练 + 跨域失效”和 raw title 的”判别力弱 + 幻觉”。关键不是”用文本”,而是用受约束、标准化、可分解、按重要性排序的文本,再配 GTI 内化把开放词空间收敛成语义子空间,幻觉问题就被结构性地解决了。
局限:
- CTG 用的是固定外部 embedding 模型(Qwen3-Embedding-8B)检索邻域,未做 domain-specific 检索优化,TID 判别力还有提升空间。
- 受算力限制只在 Qwen3 上验证,更大 base model 的上限未探。
- 数据集全是 Amazon 离线公开集,无工业线上/真实流量验证(对比 OneRec/OneLoc 这类同组工业系统,这篇偏学术验证)。
- TID 固定长度 5 + 按重要性排序,对”特征极多且都重要”的复杂 item(如组合套装)可能信息损失。
对电商/搜推可借鉴点:
- 跨域/冷启/长尾: TID 的”共享自然语言词表当语义桥”是电商多品类、多业务线统一表征的现成思路——不用为每个域单独训 SID,common term(“Portable”/“Ergonomic”)天然做正迁移。这点对电商跨类目召回、新品冷启动直接可用。
- 可解释 + 可干预: TID 是人类可读关键词(
perfume | feminine | oriental | woody | calvin-klein),推荐链路天然透明,便于业务侧审计、做属性级 boost/降权、甚至给运营看为什么推这个。比<216><32>这种 SID 友好太多。 - 词表压缩落地: K-means 把 54k term 压到 3k Core Term 精度几乎不掉,给”有界输出词表 + beam search 可控”提供了工程上限保证——电商 item 量级巨大时,固定小词表 + 结构映射 grounding 是可落地的。
- CTG 的 prompt 范式可直接复用: 附录 Figure 5 的”恰好 5 词 + base form + 5 维度排序 + 邻域一致性 + 独特性”prompt 是个通用的”item → 结构化标签”蒸馏模板,可迁移到任何需要把商品 metadata 压成标准标签的场景(标签体系构建、特征工程、检索召回字段)。
- 训练范式: “identifier 内化任务 + 序列预测任务”多任务联合,比单纯序列预测更稳——对自研 LLM4Rec 的 SFT 阶段是个低成本可加的辅助任务。
与同组工作的关系: 作者来自快手(含 Kun Gai、Guorui Zhou、Ruiming Tang),与 OneRec / OneLoc / OpenOneRec 同源。GRLM 可视为对”GR 中 SID vs 文本 identifier”路线的一次学术性再思考,方向与工业系统互补——把 native-vocab term ID 这条路探通后,有潜力反哺工业 GR pipeline 的 identifier 设计。