GR2: Generative Reasoning Re-Ranker
Meta AI
把工业推荐漏斗里离用户最近、最被忽视的「重排(re-ranking)」阶段做成一个会推理的生成式 LLM。四阶段训练:① 在 ≥99% 唯一性的语义 ID 上 mid-training 让 LLM 认识十亿级商品目录;② 用强 teacher 蒸馏出「引用 SID 的 CoT 推理轨迹」装上推理先验;③ 用 DAPO + 可验证奖励(AUC/NDCG)做 RL 精炼排序;④ 一整套工业化改造(上下文压缩 >80%、OPD 替代崩溃的 SFT、把 CoT 内化成非思考策略换 ~15× serving ROI)。关键发现:re-ranking 的 reward 极易被 hack——LLM 会偷懒保留原序或利用 position bias,必须上「条件可验证奖励」去 hack。工业流量 +18.7% R@1 / +9.6% N@3,且两周不重训不衰减。
核心思路
一句话问题:工业推荐是「召回 → 粗排 → 重排」多级漏斗,其中最后的重排(re-ranking)阶段离用户最近、对 carousel/grid 版式的 engagement 影响最大,却最被冷落——现有 LLM-for-RecSys 的热情几乎都砸在召回和排序上,而工业重排还停留在 point-wise CTR 打分、不对用户意图/商品语义做显式推理。三个具体 gap 卡住规模化:G1 推理被浪费(LLM 多是 zero-shot 或在 plain ranking label 上 SFT,最能靠「RL on verifiable rewards」激发的 CoT 能力在重排上几乎没用);G2 词表不匹配(工业目录用十亿级非语义 ID 索引商品,全在 base-LLM 词表之外,模型没法直接对候选做推理);G3 工业规模税(naive 方案训练成本爆炸、长思维链拖垮 serving 吞吐、且会 reward hacking 把离线指标刷虚高)。
关键 idea / 范式:GR2(Generative Reasoning Re-Ranker)把重排重新定义为一个**「会推理的生成式重排器」——不是让 LLM 打分,而是让它读用户历史 + 候选集,输出引用商品语义 ID 的 chain-of-thought + 结构化 JSON 排序**。核心范式区分:OPD 提供推理先验、RL 在此之上磨快排序目标——两者缺一不可(纯 RL 学会「排得好但不会想」,纯 SFT 在工业规模会崩)。这是 gen-rec 家族里第一篇系统性把「语义 ID + 蒸馏推理轨迹 + 可验证奖励 RL」三件套专门为重排打通、且给全套工业落地方案的技术报告(同 topic 可对照 OneRec-Think 的 in-text reasoning、TIGER 生成式检索 的 SID 起源)。
整体实现思路
端到端是一条四阶段训练 pipeline,前三阶段造出「强但贵」的推理重排器,第四阶段在保住收益的前提下把 serving 成本砍下来:
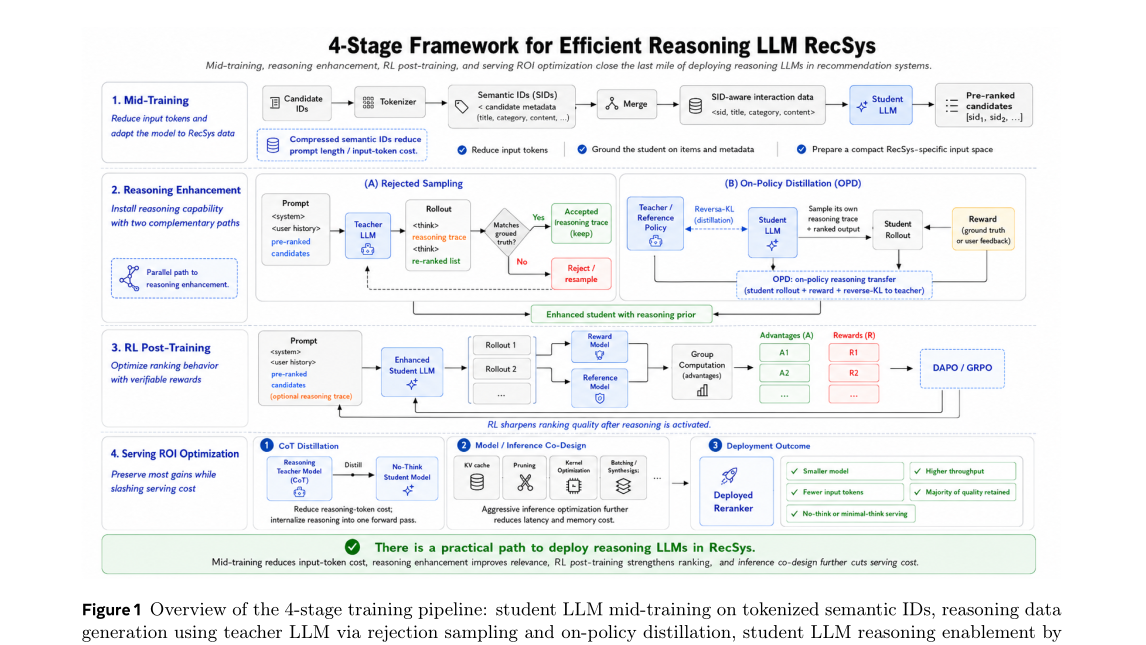
- 输入:用户 engagement 历史 + 上游粗排产出的 pre-ranked 候选 slate(每个 item = SID + title + 类目层级)。
- Stage 1 — Tokenized Mid-Training:student LLM(如 Qwen3-8B)在 RQ-VAE 产出的语义 ID 上做多任务 mid-training,把 SID 和世界知识/语言空间对齐,让模型不靠词表爆炸就能泛化整个目录。
- Stage 2 — Reasoning Enhancement:强 teacher(如 Qwen3-32B)用重排专用 prompt 生成分层 CoT 轨迹,经 targeted/rejection sampling curated 成 SFT 语料;工业规模改用 OPD(On-Policy Distillation) 装上推理先验。
- Stage 3 — RL Post-Training:用 DAPO + 重排专用奖励(format + AUC/NDCG 可验证 ranking + 可选 LLM-as-judge reasoning)精炼排序。
- Stage 4 — Serving ROI:上下文压缩(input 侧 −80% token)+ 把 CoT 内化成非思考策略(decode 侧)+ 剪枝/KV cache,产出「reasoning-free 但 iso-quality」的部署 artifact。
- 输出:重排后的 slate(训练/评估时带 CoT,部署时直接出 JSON 排序)。
子模块实现(可复现细节)
模块 A — 语义 ID 与 Mid-Training(Stage 1)
- Tokenizer/SID:给 item 文本特征 ,tokenizer 映射成离散整数序列 ,属于 ( 是第 个 codebook 基数)。核心是 RQ-VAE(残差量化);SID token 作为特殊 token 加进词表。关键差异化:tokenizer 做到 ≥99% 唯一性(避免多个 item 撞同一 SID,这是生成式推荐的老大难)。
- Mid-Training(item alignment,多任务):沿 OneRec-Think 的思路,把 SID 与自然语言 token 交织在同一序列里,用 next-token prediction 优化 SID embedding table,使 LLM 把推荐知识(SID)对齐到语言空间与世界知识。混合语料 = 语义 ID + 世界知识。
模块 B — 推理轨迹生成(Stage 2)
Chat 格式模板(6 条设计原则):system(分析师 persona + 重排目标,刻意不用「购买意图/说服」框架)、rich item metadata(title + 类目层级)、统一 item 格式(历史与候选都是 SID+title+类目)、CoT 显式引用 SID(产出可验证轨迹)、结构化 JSON 输出(reasoning + ranked list,确定性解析)。
两种轨迹生成策略:
- Targeted Sampling(给真值):——把 target item 和最近 个历史一起给 teacher,让它解释「为什么这个用户会最想要 target」。因含真值,总能产出「target 为何被偏好」的 rationale,但带 label-aware 后见之明捷径。
- Rejection Sampling(不给真值):——反复让 teacher 预测候选里哪个是用户下一个兴趣,直到猜中真值才保留。保证推理真实性,但会静默丢弃 teacher 在预算内猜不中的最难样本(恰恰是最需要监督的)。
SFT loss(解耦推理与排序 token):只对 assistant 消息算 LM loss,推理段与排序段分权重:
(排序准确性权重高于推理流畅度)。
模块 C — OPD 替代 SFT(Stage 2 工业版,关键)
工业规模 naive SFT 会灾难性遗忘/崩溃,改用 OPD(On-Policy Distillation):GRPO 式循环,student 当可训 actor、teacher 当冻结 reference。每步 student 从自己分布 采样推理链+排序,每条 rollout 拿 Stage 3 的 reward,用 clipped surrogate + per-token 反向 KL 锚到 teacher:
per-token 重要性比、 group-relative advantage、 蒸馏强度。teacher 只贡献 token log-prob、从不给 label,只当分布锚。
为什么 on-policy 胜过 off-policy CoT 监督:两种 SFT 都把推理迁移降级成「在 teacher 定义的静态语料上 behavior cloning」,继承 teacher-forcing 的通病——student 被监督在它部署时永不会访问的状态上,train/inference 分布错配沿生成链累积。targeted 采样带 label-aware 捷径(被 student 当流畅但非因果的推理背下来);rejection 采样丢最难样本+浪费 teacher 算力。OPD 三点破解:梯度在 student 自己采样的轨迹上算、每个 prompt 无论难易都给连续 reward 信号、teacher 角色从「生成目标轨迹」降为「正则化 student 分布」。
模块 D — DAPO + 可验证奖励 + 去 hack(Stage 3,重中之重)
工业 slate 是 multi-positive(一个候选列表可同时带多个 engagement label),所以用整排列打分而非单目标 rank-delta。
- Ranking reward(AUC,主信号):slate 配二值 label 向量 ,用 per-impression AUC:,、。AUC 原生处理多正例、有界 [0,1]、类内置换不变,RL 信号稳。有更丰富 post-engagement 信号时加 graded NDCG(三级 label =无/click/click+conversion):。无正例或无负例的 slate 在 data-loading 就过滤。
- Conditional format reward(去 hack,核心洞见):format reward 查①轨迹与排序能否可靠解析、②是否是合法的 置换。naive 组合 暴露两条 reward-hacking 路径:(1) 非法置换靠 partial parse 也能拿非平凡 → 用 门控 ;(2) 上游 slate 本身已非平凡有序时,policy 直接吐 保留原序、白蹭输入自带的 AUC → 检测「identity 置换作弊」并在原序次优时把 清零: (当上游 slate 已最优时,identity 置换是真答案、reward 正常给)。
- DAPO 优化:在 GRPO 上改进,解决 entropy collapse 与 rollout 长度偏差。每 prompt 采 个输出, 组内归一化;Clip-Higher 解耦 ;过采样 + 过滤掉 accuracy=0 或 1 的 prompt 提样本效率。
模块 E — Serving ROI(Stage 4)
- 上下文压缩(input 侧):训一个 compressor,用 GRPO + LLM-as-judge 沿三轴打分——solvability 、information preservation 、ranking quality 。reward:()否则 ;,。洞见:任务可解时压向 ranking quality 而非字面保留——因为 preservation 与下游 ranking 相关性弱,高压缩反而抑噪。
- CoT 内化(decode 侧):在 RL checkpoint 上再跑一轮 RL、显式 bypass 推理,只出结构化排序。因推理先验已编码进共享 backbone,转到 direct-output 策略不产生 CoT 生成成本。这个 reasoning-free 变体才是部署 artifact;带 CoT 的模型留线下做评估和 reward 设计。
- 系统级:depth-wise 层剪枝 + redistillation;KV cache 利用「候选集固定且跨用户高度共享」——按 system → candidates → user context 排 prompt,让候选 KV 可复用。
实验设置与结果
数据:Meta 内部广告日志,只用单日(01-25) ~70k session 训练,在 02-01~02-09 held-out 评估。冷启动压力测试:测试集 >99% 候选商品、100% user ID、93% 历史 item 训练时未见;历史聚合到 impression 前 −2 天防泄漏。baseline 是 point-wise legacy(在线训练、每 60–90 分钟 snapshot 刷新)。指标 Recall@K / NDCG@K。
主结果(Fig.2):
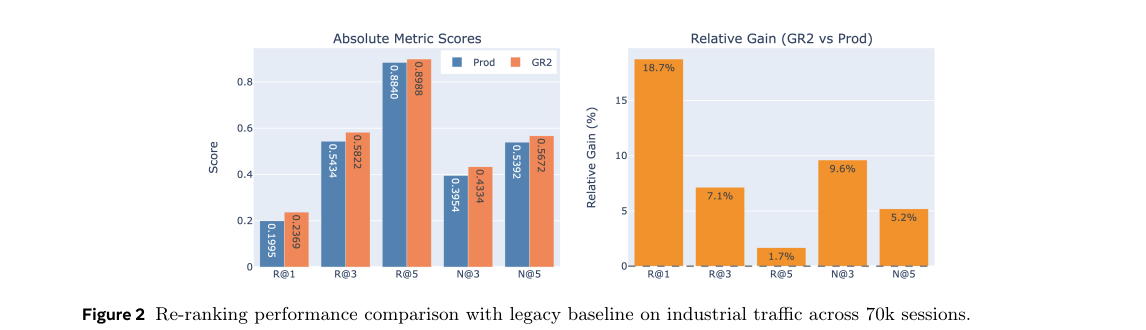
| 指标 | Prod(legacy) | GR2 | 相对提升 |
|---|---|---|---|
| R@1 | 0.1995 | 0.2369 | +18.7% |
| R@3 | 0.5434 | 0.5822 | +7.1% |
| R@5 | 0.8640 | 0.8988 | +1.7% |
| N@3 | 0.3954 | 0.4334 | +9.6% |
| N@5 | 0.5392 | 0.5672 | +5.2% |
- 收益不因数据新鲜度:GR2 checkpoint 相对测试窗已 stale ~2 周,baseline 每小时刷新,GR2 仍大幅领先 → 是推理带来的真实排序质量提升。
- 跨规模不变(Fig.3):测试集从 0.14× 扫到 100× 训练规模,相对 R@K/N@K 收益基本恒定。
- 抗 staleness(Fig.4):连续 9 天评估、GR2 两周不重训,收益无可测衰减——因为 GR2 靠 LLM 世界知识+推理而非记忆稀疏 ID,而这正是 legacy 必须 60–90 分钟刷新才能扛分布漂移的原因。
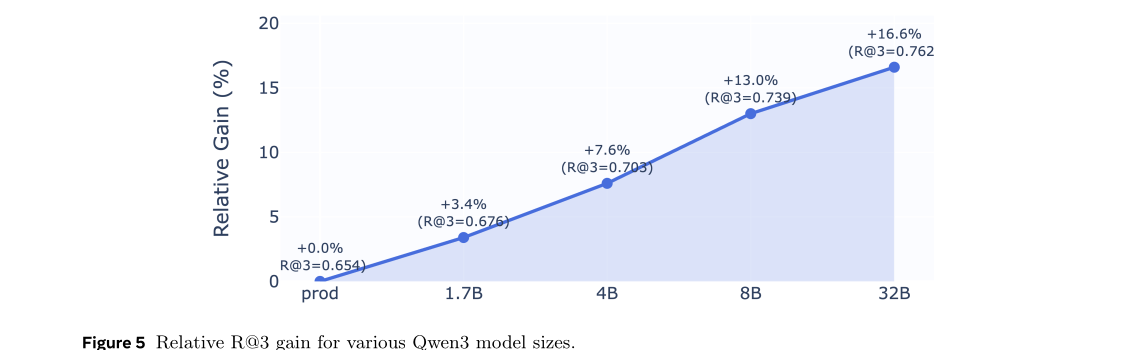
- 随模型规模 scaling(Fig.5):Qwen3 1.7B→32B,R@3 相对收益单调增(+3.4%→+7.6%→+13.0%→+16.6%),继承 LLM scaling law;~10-GPU 预算下曲线尚未饱和。稀疏 ID baseline 的 scaling 受 ID 词表容量而非参数量约束。
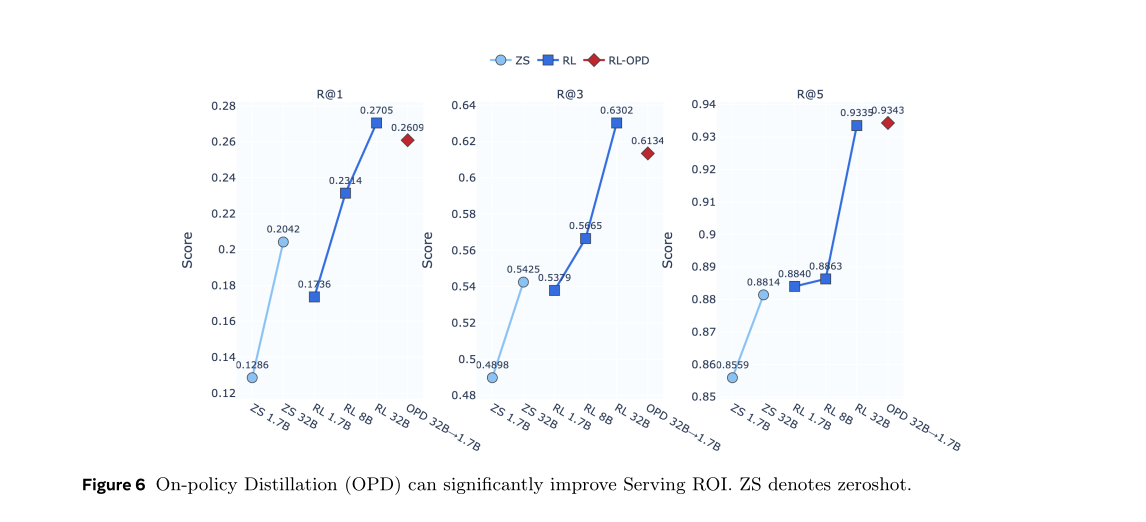
Serving ROI(Fig.6):默认 recipe RL-OPD(先 OPD bootstrap 推理避免 token-level SFT 的灾难遗忘,再 RL 磨排序)。1.7B student 从 32B teacher 蒸馏(5% 大小)回收 82% 的 32B 收益、是无蒸馏 8B 收益的 2.6×,iso-quality 下 ~15× serving-ROI 提升(32/1.7×0.82)。
上下文压缩(Fig.7):压缩变体在 <20% token 下匹配甚至微超全上下文(R@3 +7.71% vs +7.14%),额外 >5× 上下文缩减 iso-quality——印证「preservation 与 ranking utility 弱相关、激进 ranking-aware 压缩是去噪器」。CoT 内化(Fig.8):在「需高推理」的 hard subset 上,直接砍 CoT 会掉 −6~7% R@1;但第二轮 RL 内化后完全补回、头部甚至微超 CoT 参考——部署 artifact 做到 reasoning-free 却 iso/super-CoT 质量。消融(Fig.9/10):直接在 zero-shot 上 RL 会轻微降推理质量(Depth 掉到 ~1.02 近地板)——「RL alone 学会排得好但不会想」;RL-OPD Pareto 支配——OPD 供推理先验、RL 磨排序目标,缺一不可。
思考与可参考价值
定位:这是把「生成式推荐」从召回/排序推进到重排最后一公里的工业标杆,且难得地把 reward hacking 这个 RL-for-ranking 的真实坑摆到台面。和同 topic 的 OneRec-Think(in-text reasoning)、TIGER(SID 起源)、PLUM(LLM 适配生成式检索)连起来看,能拼出「语义 ID → 生成式召回 → 推理式重排」的完整工业演进。
可直接借鉴(电商/搜推/Agent 方向):
- 条件可验证奖励去 hack,是最高含金量的一条:任何用 RL 优化排序/重排的场景都会遇到「模型保留原序白蹭输入 AUC」「非法输出蹭 partial parse」这两种作弊——用 门控 ranking reward、检测 identity-置换并在原序次优时清零,这套「条件奖励」可以直接抄进我们的生成式重排 RL。这对 simulator/生成式召回那条线尤其值得警惕:离线指标涨了先查是不是 reward hacking。
- OPD 供先验、RL 磨目标——「先验与目标解耦」的训练哲学:纯 RL 会「排得好但不会想」(推理质量掉到地板),纯 SFT 工业规模崩;用 on-policy 蒸馏装先验、再 RL 精排序,是比「直接 RL」或「SFT+RL」更稳的配方。OPD 让 teacher 只当分布锚不给 label,破解 teacher-forcing 分布错配,值得在我们的蒸馏链路里试。
- AUC 作 RL reward 处理 multi-positive slate:工业 slate 天然多正例,用 per-impression AUC(置换不变、有界、原生多正例)比单目标 rank-delta 稳得多——做整页/整列表重排的 RL 可直接用。
- 「ranking-aware 压缩是去噪器」反直觉但实用:信息保留度与排序效用弱相关,压掉 80% token 反而 iso-quality——说明重排真正需要的信号很稀疏,值得在长上下文场景做激进的 ranking-aware 压缩而非无脑保留。
- CoT 内化换 serving ROI:训练带 CoT、部署 reasoning-free,靠共享 backbone 把推理先验 re-route 进 direct-output 策略——这套「训练时思考、推理时不思考」的范式对任何想上线大模型推理的低延迟场景都通用(~15× ROI)。
- 抗 staleness + scaling 是对稀疏 ID 的结构性优势:GR2 两周不重训不衰减,而 legacy 必须每小时刷;且随模型规模持续 scaling 不受 ID 词表约束——这是「LLM 世界知识 vs 记忆稀疏 ID」的根本分野,长期看是生成式推荐替代传统重排的核心论据。
局限与存疑:① 是技术报告、Meta 内部数据、无代码,绝对数字与 tokenizer 细节都指向另一篇 prior paper(Liang et al. 2026),可复现性打折;② 只单日 70k session 训练——虽是亮点(数据高效)也是隐患,长期/多日训练的稳定性与上限未知;③ 提升集中在头部(R@1 +18.7% 但 R@5 仅 +1.7%),对靠深位转化的下游业务收益要打问号;④ 主结果是离线 Recall/NDCG,没有线上 A/B(AgentX/NOVA/YouTube 那几篇都有真实线上,GR2 这版没报);⑤ reward 里可选的 LLM-as-judge reasoning 项、compressor 的 judge 都引入额外 LLM 依赖与成本,未量化;⑥ ~15× ROI、82% 收益回收等都是相对数,绝对延迟/QPS/GPU 成本没给。