Farewell to Item IDs: Unlocking the Scaling Potential of Large Ranking Models via Semantic Tokens
ByteDance
用「语义 token」彻底替代排序模型里的 item ID,解决 ID 冷启动 / 退役导致的稀疏 embedding 分布漂移,从而打通 dense 参数的 scaling law。TRM 三件套——协同感知多模态表征、Gen/Mem 双 token 混合分词、判别+生成联合训练——在字节个性化搜索上离线 QAUC +0.85%、稀疏存储 -33%,且 dense 参数越大相对 ID baseline 优势越大;线上活跃天数 +0.26%、换 query 率 -0.75%。
核心思路
工业级大排序模型(LRM)的主流范式是「item ID + 大稀疏 embedding 表」:每个 item 当成独立类别符号,映射到一个可学 embedding。问题在于 item 的生灭速度极快——新 ID 持续涌入(冷启动,embedding 没学好)、老 ID 不断退役(知识被擦除)。这导致 ID 特征分布在训练中剧烈漂移,dense 网络参数难以稳定学习,最终 dense 参数 scaling 不动(图 1 里作者用 norm variance 度量分布漂移:100M→1.2B 时 ID embedding 的 norm variance 从 1.76 飙到 1.91,而 token embedding 仅 0.78→1.56,更平稳)。
作者的核心主张:用「语义 token」替代 item ID。语义 token 来自一个结构化、封闭、平滑的集合(RQ-Kmeans 量化得到的离散码),分布稳定 → dense 参数的 scaling exponent β 更大 → 更陡峭的 scaling law。
但作者诚实地指出:朴素地把现有语义 token(TIGER/OneRec/SemID)塞进排序模型会立刻掉点。他们诊断出三个根因,并对应给出三个模块,组成 TRM(Token-based Recommendation Model)框架:
- 用户行为域缺失:现有语义 token 只用 item 的图像/文本多模态信息做残差聚类,忽略了「用户行为域」这个和视觉/语言结构完全不同的信号。→ 协同感知多模态表征。
- 记忆能力被牺牲:粗粒度聚类换来了泛化,但丢了 item 的「组合知识」(“蛋糕”+“蜡烛”≈“生日”,但单独哪个 token 都学不到”生日”),导致高频老 item 掉点。→ Gen/Mem 双 token 混合分词。
- token 序列内部结构信息被忽略:判别式建模把序列里每个 token 一视同仁,丢了 token 间的层级/顺序结构。→ 判别 + 生成联合优化。
整体实现思路
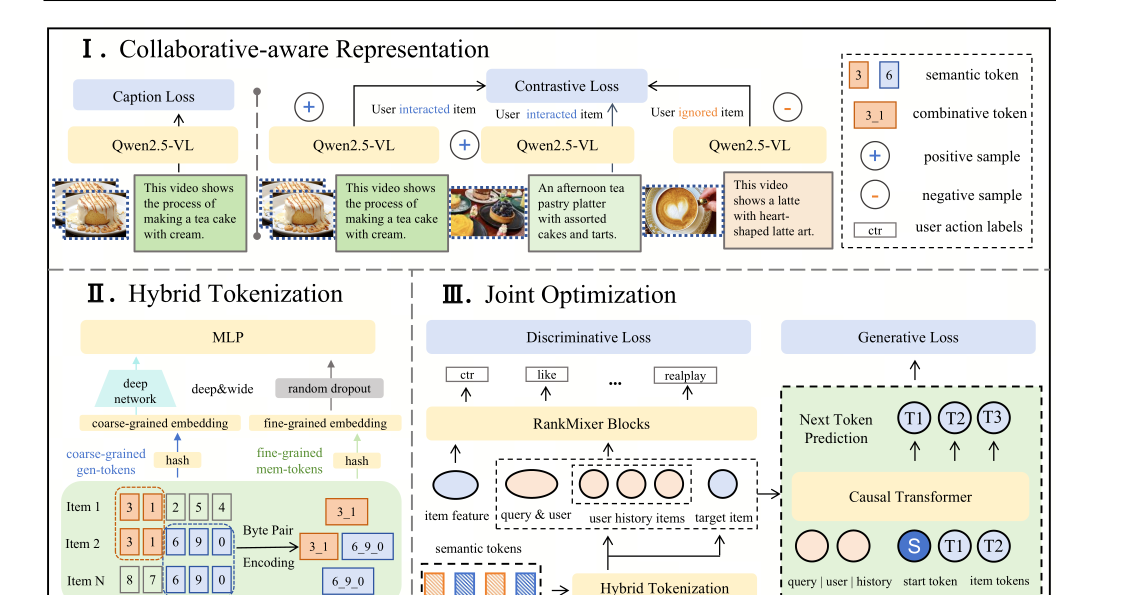
TRM 把「item 建模 → 表征离散化 → 排序优化」重构成一条统一流水线(图 2):
- 协同感知多模态表征:两阶段对齐,先做短视频域内 caption 微调注入领域知识,再用用户协同信号(query-item 正反馈对、item-item 高频共点击对)做对比学习对齐,产出既懂语义又懂行为的 dense item 向量。
- 混合分词:对上一步的向量做 RQ-Kmeans 残差量化得到粗粒度 gen-tokens(泛化);再用 BPE 在 token 序列上挖高频 k-gram 组合,生成细粒度 mem-tokens(记忆);二者经 Wide&Deep 融合成 hybrid token(deep 侧吃 gen-token 并加随机 dropout,wide 侧吃 mem-token)。
- 联合优化:排序模型(RankMixer)完全跑在语义 token 上,不再有 item ID。判别目标用 BCE 预测 ctr/like/real-play;生成目标用 NTP(next-token prediction)在 query+user 上下文上自回归生成正反馈 item 的 gen-token 序列,借此显式利用 token 序列的结构信息。
子模块实现(可复现细节)
1. 协同感知多模态表征(Collaborative-aware Representation)
Stage-1 域内 captioning:item = 视觉帧 + 文本元数据(title、ASR 语音转文、OCR 图转文、描述),喂进 MLLM(基座为 Qwen2.5-VL),自回归生成 caption。数据来自真实曝光日志。损失为标准 NTP:
L_cap = − E_{(V,T)} Σ_{k=1}^{|T|} log P(t_k | t_{<k}, V; θ)
其中 V 为视觉输入,T = t₁..t_{|T|} 为目标 caption。
Stage-2 协同对齐:取 MLLM 最后一层 token 表征做 mean pooling 得到单一 dense 向量:
h = (1/N) Σ_{i=1}^{N} z_i
构造两类正样本对:(a) 来自正反馈的 query–item 对;(b) 高频共点击的 item–item 对。对二者做对比学习(in-batch 负采样,余弦相似度,温度 τ):
L_align = − E_{(a,b)∈P} log [ exp(sim(h_a,h_b)/τ) / Σ_{b'∈B} exp(sim(h_a,h_{b'})/τ) ]
总目标:L_rep = L_cap + λ_align · L_align。
- 实测用 2M item-item 对 + 其多模态信息做协同对齐。
2. 混合分词(Hybrid Tokenization,generalization–memorization trade-off)
Gen-tokens(泛化):RQ-Kmeans 残差量化,把 item 表征投影成 token 序列 s=[s₁,…,sₙ]。
- 配置:5 层 codebook,每层 4096 个 embedding → 共 20480 个 token。
为什么 gen-token 不够:残差量化是粗粒度聚类,语义不足;token 的简单聚合(sum/concat)无法替代语义的「组合」。如图 2 中 AUC gain vs item 寿命曲线所示,纯语义 token 对新 item / 低曝光 item 有增益,但随着 item 曝光频次/寿命增加性能持续退化甚至转负——丢了 item 特异性记忆。这也是为什么 OneRec/OneSearch 等生成式方法实践中还要挂一个 ID-based reward 系统。
Mem-tokens(记忆):把每个 gen-token 当作描述 item 的「子词」,用 BPE 在 token 序列上动态合并高频组合,生成新 token ID 来保留细粒度组合知识。
- 配置:BPE 最多生成 2×10⁷ 个 token,相对 item ID 集合(1.3×10¹⁰)可忽略 → 这是稀疏存储下降 33% 的来源。
- gen-token 与 mem-token 走不同 embedding 模块(哈希系统)。
融合:Wide&Deep —— deep 侧输入 gen-token(加随机 dropout 防过拟合),wide 侧输入 mem-token,输出 hybrid token embedding 作为模型输入。
3. 判别 + 生成联合优化(Joint Optimization)
排序模型输入三部分:query 特征 X_Q、item 特征 X_I(多模态信息 + hybrid token)、user 特征 X_U(交互历史)。
判别目标(BCE,预测 ctr/like/real-play 等):
L_d = E_{(X^i_{Q,U,I}, Y^i)} BCE(Y^i, P(Ŷ | X^i_{Q,U,I}, θ_d))
生成目标(仅对正反馈样本 Y^i=1,用 query+user 自回归生成 item 的 gen-token 序列):
L_g = E_{(X^i_{Q,U}, Y^i)} [Y^i=1] · Σ_{j=1}^{L} CE(s^i_j, P(ŝ_j | X^i_{Q,U}, s^i_{<j}, θ_g))
其中 s^i_j 是 item 的第 j 层 gen-token,L 为 gen-token 长度。
总损失:L = L_d + λ · L_g,λ=0.1。
实现细节:
- X_Q、X_U 各投影成 N_q = N_u = 2 个 context token。
- 用 4 层 Causal Transformer 做生成预测。
- 采用 semi-causal mask:context token 之间互相可见,后续 start token 和 semantic token 走因果遮罩。
- 消融显示(表 6):NTP loss 能完全替代 Positional Encoding 的作用——单加 PE 收益极小(AUC +0.02%),NTP+PE 时 PE 的收益反而消失,说明 NTP 注入的结构信息更充分。
实验设置与结果
数据:大规模视频搜索-排序数据集(字节个性化搜索),三方面:Items(帧/标题/音频/caption)、Queries&Users(query 文本 + 历史交互)、Interactions(每个 query 下用户对每个 item 是否正反馈)。 Baseline:ID-based(DCN-v2、DHEN、WuKong、Pure Transformer、RankMixer);token-based(TIGER-token、OneRec-token、SemID,均用其语义 token 替代 RankMixer 的 item ID,网络超参对齐)。ID baseline 起点是 7M 的 DLRM-MLP。 指标:AUC、QAUC(query 级 AUC);CTR + Real-Play(观看 >10s 记为 1);效率看 dense/sparse 参数与 FLOPs(bs=4096)。
主结果(相对 7M DLRM-MLP 的增益)
| 模型 | CTR AUC | CTR QAUC | RealPlay AUC | RealPlay QAUC | Dense | Sparse | FLOPs |
|---|---|---|---|---|---|---|---|
| DLRM-MLP(基准) | 0.8662 | 0.8826 | 0.8413 | 0.8604 | 7M | 7.52T | 0.13T |
| RankMixer (ID) | +0.58% | +0.48% | +0.76% | +0.63% | 335M | 7.52T | 13.20T |
| WuKong (ID) | +0.44% | +0.38% | +0.59% | +0.45% | 355M | 7.52T | 18.96T |
| Tiger-token | +0.45% | +0.40% | +0.58% | +0.45% | 338M | 5.06T | 13.89T |
| OneRec-token | +0.53% | +0.45% | +0.64% | +0.54% | 342M | 5.06T | 13.98T |
| SEMID | +0.56% | +0.47% | +0.75% | +0.61% | 345M | 5.08T | 14.23T |
| TRM-Pure Transformer | +0.61% | +0.53% | +0.81% | +0.68% | 341M | 5.07T | 12.17T |
| TRM-RankMixer | +0.65% | +0.54% | +0.85% | +0.70% | 352M | 5.07T | 14.66T |
- 稀疏参数 7.52T → 5.07T(-32.6%),同时性能更优。
- TRM-Pure Transformer(纯 transformer、无任何特征交叉模块)也很能打,FLOPs 最低,暗示「全 token 架构」可行。
Scaling Law(关键卖点)
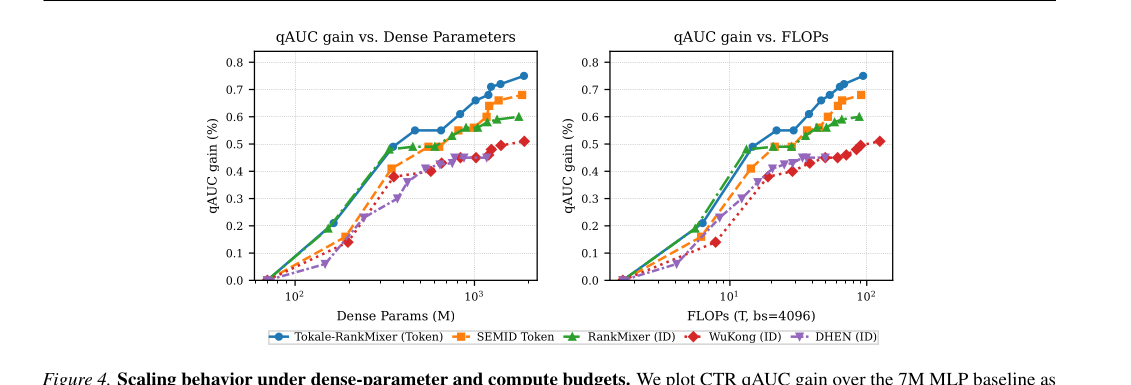
dense 网络放大时,TRM-RankMixer 相对 ID baseline 的优势越拉越大:
- 最大规模:TRM-RankMixer 在 1888M 达 +0.75% qAUC,SEMID 在 1843M 为 +0.68%,ID-RankMixer 在 1768M 仅 +0.60%。
- ID 强基线明显饱和:WuKong 即便放大到 ~1.9B(124.64T FLOPs)也仅 +0.55%;DHEN 在 1.17B(49.75T FLOPs)就停在 +0.42%。
- 相对增益从 +0.54% 一路涨到 +0.85%,验证 token 化让 dense 容量被更有效利用。
消融
| 消融项 | CTR AUC | CTR QAUC |
|---|---|---|
| 完整 TRM | — | — |
| w/o 协同对齐 | -0.05% | -0.03% |
| w/o 混合分词 | -0.09% | -0.07% |
| w/o 辅助 NTP | -0.05% | -0.05% |
- 混合分词贡献最大,印证「平衡泛化与记忆」是关键。
- Mem-token 数量(图 5,相对仅 gen-token):对所有寿命 item 都有增益,但更利于「记忆」——新 item(<1 天)增益 +0.06%,老 item(>7 天)增益 +0.11%;数量 5M→10M 收益明显,15M→20M 趋于饱和(老 item 仅再 +0.02%)。
- BPE vs 其他 n-gram(表 5,相对 1-gram):BPE +0.09% AUC > Prefix-ngram(SemID 用) +0.05% > 2-gram +0.02%,BPE 的动态合并机制更能抓组合表征。
- NTP loss 来源验证(表 3):NTP 仅带来 1.7% dense 参数 / 0.5% FLOPs 增量,但去掉 NTP loss 后 QAUC 从 +0.05% 掉到 +0.01%——增益来自生成目标本身而非额外参数。
线上 A/B(TRM-RankMixer-352M 替换 7M DLRM)
| 指标 | Overall | Low-Active | Mid-Active | High-Active |
|---|---|---|---|---|
| Search Active Days ↑ | +0.26% | +0.27% | +0.26% | +0.22% |
| Change Query Ratio ↓ | -0.75% | -0.81% | -0.68% | -0.69% |
| Strict CTR ↑ | +0.39% | +0.36% | +0.31% | +0.40% |
| Like ↑ | +1.51% | +1.83% | +1.21% | +1.20% |
| Comment ↑ | +1.80% | +2.02% | +1.69% | +1.59% |
全指标显著(p<0.05),各活跃度人群普涨。15 名真人对 462 个 query page 做双盲 SbS:item 质量 +0.86%、query-item 相关性 +0.34%、内容满意度 +0.92%。
理论(附录 A.1,简述)
基于 scaling law L(N) ≈ L_∞ + A·N^(−β),作者把指数 β 解释为 Bayes-最优 CTR logit 在语义隐空间上的平滑度 s 与有效维度 d_eff 的函数:β ≈ 2s/(2s+d_eff)。RQ-VAE 量化只会在 BCE loss 下贡献一个 N 无关的 floor 平移(命题 A.1:0 ≤ Δ_quant ≤ L_η·δ_s),不改变 tower 的 scaling exponent。而 token 化通过「语义参数共享」让表征集中在更低复杂度子空间、谱衰减更快(更小 d_eff、更大有效 s),于是 β_tok > β_id——这就是 token 曲线更陡的理论解释。
思考与可参考价值
对电商/搜推可借鉴:
- ID 退役/冷启是 scaling 的真瓶颈:把「dense 参数 scaling 不动」归因到稀疏 ID 分布漂移,并用 norm variance 量化,这个诊断角度对所有想把排序模型做大的团队都通用。电商场景 SKU 生灭比短视频更剧烈,结论迁移性强。
- Gen/Mem 双 token 是务实折中:纯语义 ID(TIGER/OneRec)在高频老 item 上掉点是公认痛点,本文用 BPE 挖高频 k-gram 组合补「记忆」,且 mem-token 总量(2×10⁷)相对 ID 集(1.3×10¹⁰)极小——稀疏存储 -33% 同时不掉记忆,这个 trade-off 设计可直接抄。Wide(mem)&Deep(gen)+deep 侧 dropout 的工程拼法很轻量。
- NTP 辅助损失能替代 PE:用生成目标显式建模 token 序列结构,比手工 Positional Encoding 更有效,且只加 ~1.7% 参数。对已有判别式排序模型是低成本增量。
- 协同信号要进 tokenizer:只用图文多模态做语义 ID 会丢行为结构,必须把 query-item / item-item 协同对喂进表征对齐——这点和「视频 caption 取数」类工作可串联:caption 是 stage-1,stage-2 才是关键差异。
局限 / 存疑:
- 全文未给出代码,离线增益绝对值偏小(CTR AUC +0.65%),需自有大规模日志才能复现协同对齐与混合分词。
- 图表存在笔误(图 4 图例 “Tokale-RankMixer” 应为 TRM;正文 “Meta-token” 与表中 SEMID 混用),细节以表格数字为准。
- mem-token 用哈希 embedding,2×10⁷ 量级下哈希冲突对长尾组合的影响未讨论;BPE 词表如何随时间更新(新组合涌现)也未交代,工业落地需补增量更新策略。
- 生成目标只在正反馈样本上算,负反馈/多目标如何融进生成侧仍是开放问题。