Diffusion-GR2: Diffusion Generative Reasoning Re-ranker
Meta AI × UNC Chapel Hill
把「生成式推理重排器」的解码范式从自回归(AR)逐 token 换成块扩散(block-diffusion)并行解码——一次前向可提交多个 reasoning/answer token,在长推理链的场景下拿到 2.4–3.5× 吞吐。难点是并行解码会打开两个精度 gap:结构 gap(答案位并行独立打分→出现重复/漏项/越界 ID 的非法排列)和分布 gap(在固定 teacher 轨迹上微调是 off-policy)。Diffusion-GR2 用「转换微调 CFT(把 AR 的合法排列能力迁移进扩散解码器) + on-policy 蒸馏 OPD(在自己解码的轨迹上用 AR teacher 做逐 token 稠密监督) + RL」三段闭环,在 Amazon Beauty 上恢复到与 AR 近乎持平的排序精度。
核心思路
生成式推理重排器(reasoning re-ranker)在推荐链路最后一级,把用户历史 和检索器给出的 top- 候选列表 喂进 LLM,先生成一段 chain-of-thought 把「为什么这样排」讲清楚,再吐出候选的一个排列(permutation)作为最终排序。推理本身正是它精度高的原因(把决策 ground 在 item 语义与用户意图上),但也是它慢的原因:自回归(AR)解码器每生成一个 reasoning token 就要跑一次串行前向,而推理链长度远大于它最终产出的排序(本文 prompt ≈2200 token、reasoning ≈130 token、答案只有 个 ID)。在「每个 impression 都要过一遍模型」的生产重排场景,这个串行成本是硬约束。
块扩散语言模型(block-diffusion LM)给了一条出路:不再左到右逐 token 走,而是一次预测一个 block 内所有被 mask 的位置、在几步去噪里把最自信的位置逐步 commit,因此串行步数 。但把一个 AR 重排器朴素地换成扩散解码器会打开两个精度 gap:
- 结构 gap(structural):答案位是并行去噪、独立打分的,没有任何机制保证提交的 ID 恰好构成 的排列 → 解码器频繁吐出非法排序(重复 ID / 漏候选 / 越界 ID),而 AR 靠「一次提交一个、mask 掉已用 ID」天然避免。
- 分布 gap(distributional):在固定 teacher 轨迹上微调,相对模型自己在推理时的解码分布是 off-policy,留下残差精度差。
Diffusion-GR2 的贡献就是:在保住块扩散提速的前提下,用「转换微调 CFT → on-policy 蒸馏 OPD → RL」三段式闭环,逐一补齐这两个 gap,把精度恢复到与 AR teacher(GR2)近乎持平。
整体实现思路
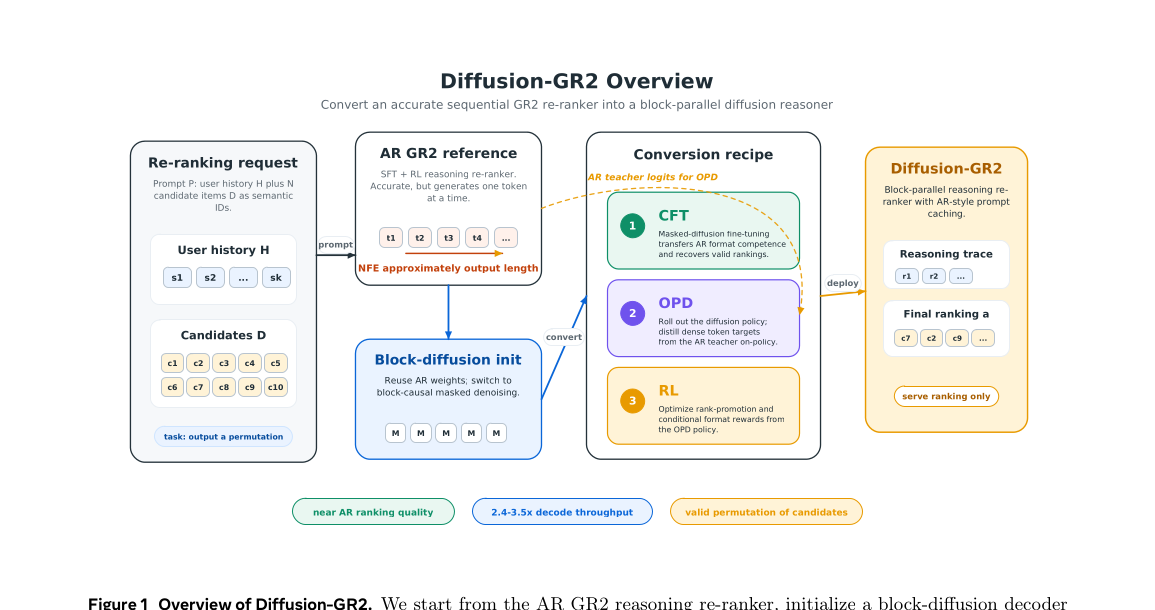
端到端 pipeline(对应上图三段 conversion recipe):
-
起点 = 训好的 AR GR2 重排器。它是 Qwen3-8B 经两阶段后训练得到:SFT(在 teacher LLM 生成、rejection-sampling 过滤的高质量推理链上学 SID-grounded 推理 + 排序,reasoning 与 answer token 的 LM loss 解耦加权)→ RL(用 rank-promotion + 条件 format reward,DAPO 优化)。这个 SFT+RL 模型是我们要恢复的精度上界。
-
权重无损转换(Block-diffusion init):把 AR 重排器的 transformer 张量一对一复制,只改配置(block size、mask token、block-causal 注意力 pattern)。所有对并行解码的适配都留给后续微调,转换这一步不训练。
-
CFT(转换微调):把 AR 初始化的扩散模型在重排数据上用 masked-diffusion 目标微调,把 AR 的「合法排列」格式能力迁移进扩散解码器 → 补结构 gap,且不需要外挂 constrained decoder。
-
OPD(on-policy 蒸馏):让转换后的 student 在自己真实的块扩散解码分布下 rollout 轨迹,冻结的 AR teacher 在这些自采样轨迹上提供逐 token 稠密监督(forward KL)→ 补分布 gap。
-
RL:在 OPD 得到的健康 on-policy 策略之上,用 rank-promotion reward + TraceRL 式 trajectory-replay GRPO/DAPO 直接优化排序指标,收尾最后一点残差。
输出是一个保持 GR2 重排接口不变、但把串行解码成本换成块并行去噪的重排器。核心的推理侧设计(block-causal 注意力 + KV cache 复用 + confidence-threshold 并行提交)见下节。
子模块实现(可复现细节)
模块 0 — 问题设定与符号
- 输入:用户购买历史 与检索器给的预排候选 ,。每个 item 用 semantic identifier(SID) 表示——RQ-VAE 量化出的 4-token ID(TIGER 协议)。
- 输出:,其中 是 reasoning 链, 是答案—— 个候选 ID 的一个排列。
- 重排器是条件分布 ,prompt 用 chat 模板渲染(expert system role + SID-grounded item 的 title/category + 结构化输出规格),复用 GR2 模板。
模块 1 — 块扩散解码器与推理加速(结构 + 提速的根)
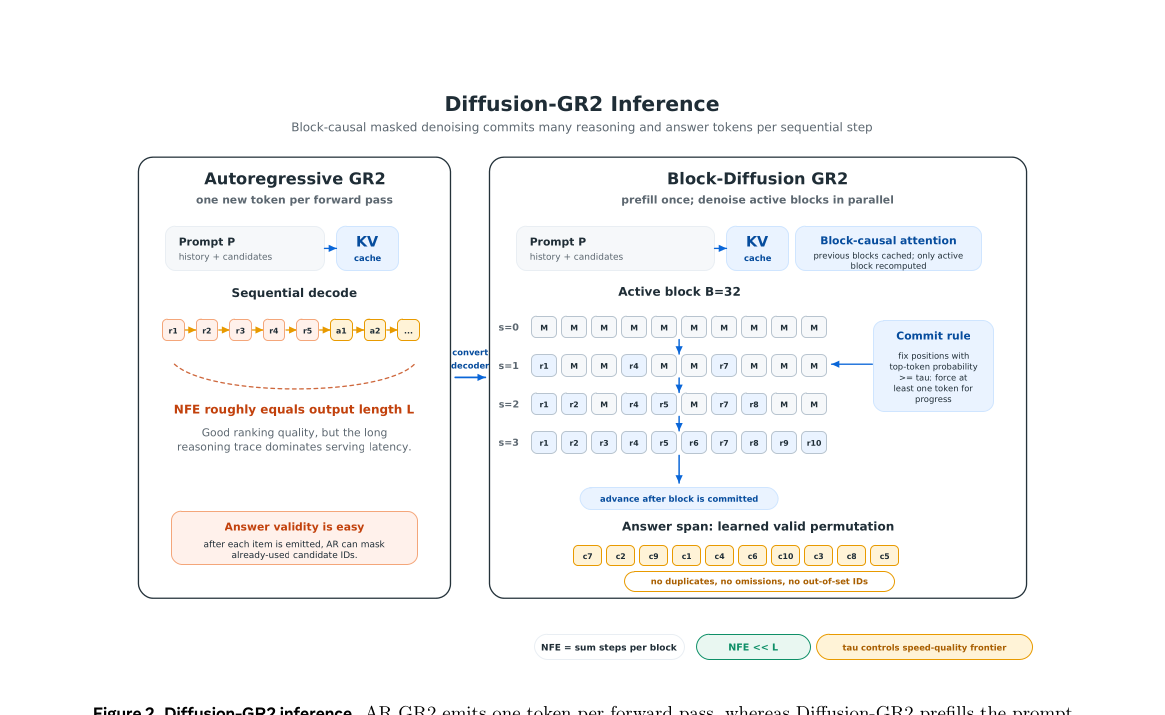
结构:response 切成固定大小 的连续 block(本文 )。注意力 block 内双向、block 间因果——block 的位置能看到本 block 全部位置 + 所有更早已提交(clean)block 的 context,但看不到后面的 block。解码逐 block 推进,block 内被 mask 的位置在几步内并行去噪,一个 block 全 commit 后才前进到下一个。 退化成普通 AR 左到右解码——正是我们对比的 speed baseline。
去噪与提交规则:设 是全 mask 的答案画布, 是第 步去噪后的状态。第 步模型对每个被 mask 位置输出词表 上的位置分布 ,提交规则 选出要固定的位置:
具体是 confidence-threshold 提交:每步把「top-token 概率 」的位置全部 commit(再加一个强制 arg-max 保证至少提交一个、防止卡死),其余重新 mask 留到后续步。于是一个 位置的 block 通常远少于 步就解完。填满长度 的 span 所需串行前向次数(NFE):
调 speed-quality frontier: 高 → 每步提交更少更自信的 token(接近 AR、质量高); 低 → 每步提交更多(更快,直到 parsing 崩掉)。
为什么选 block diffusion 而非全双向扩散(LLaDA/Dream):block 间因果结构是能做 KV cache 的前提——block 不看后续 block,所以 prompt 和已提交 block 的 K/V 在整个解码期间固定、可缓存复用(和 AR 一样),每步只对小的 active block 重算注意力。全双向扩散每步都要 attend 整条序列(含 prompt),无法缓存,而本文 prompt 平均 ≈2200 token vs 短答案——每步重编码 prompt 的代价恰恰是承受不起的。所以选块扩散:牺牲一点注意力灵活性,换回 AR 式 prefill 摊销 + 答案多 token 并行提交。
模块 2 — CFT:转换微调,补结构 gap
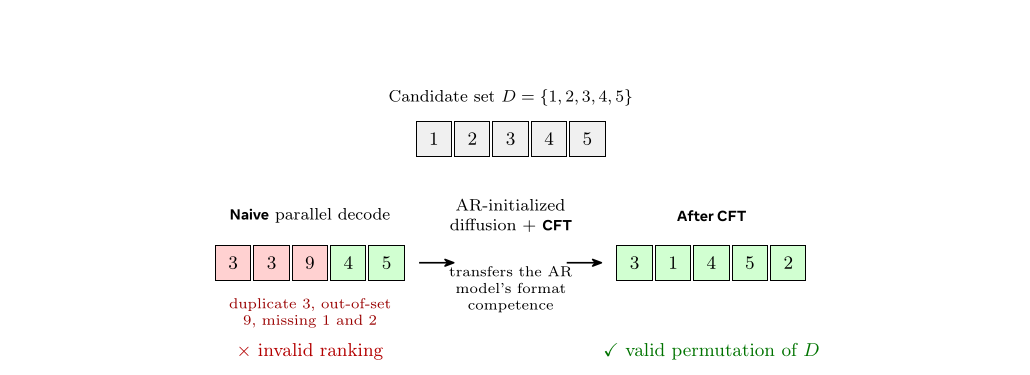
问题(结构 gap 三种失败模式):答案是已知集合的排列、位置高度耦合,但扩散并行提交、独立打分,没机制保证是排列 →
- Duplicates:同一候选 ID 在两个 rank 都被提交;
- Omissions:某候选从未出现在答案里;
- Out-of-set:提交了一个语法合法、但不在本 query 候选集里的 ID。
朴素解码下这几乎必然发生(下文实验:valid-JSON rate 仅 0.001)。
方案(不外挂 constrained decoder):一个自然的修法是推理时挂一个把答案 logits mask 到候选集的 constrained decoder,但那是「外部机械」、且不改模型学到的顺序。本文走原生路线——从转换本身恢复合法性:扩散模型是从 AR GR2 初始化的,而 AR 靠左到右 mask 天然产出 的合法排列;于是在重排数据上用 masked-diffusion 目标微调 assistant message(reasoning 与 answer token loss 解耦加权,同 GR2),就把「输出良构排序」这个能力迁移进扩散解码器。CFT 后模型自己就能把答案 span 去噪成 的合法排列,无需 task-specific constrained decoder,且恢复回转换损失的大部分精度。
- IO:输入 prompt + 部分去噪的 answer canvas;输出每个 mask 位的词表分布。
- 超参:Conversion FT epochs = 3;block size ;eval 去噪步数 = 64。
模块 3 — OPD:on-policy 蒸馏,补分布 gap
问题(分布 gap):CFT 在固定轨迹(teacher reasoning 链 + ground-truth 答案)上训,是 off-policy;推理时模型解码的是自己的轨迹(去噪顺序、部分解码 context、自己的 commit)——训练时没见过,逐步小偏差沿轨迹累积(即 teacher-forcing 的 exposure bias)。标准解法是让训练 on-policy:在学生自己的 rollout 上监督(DAgger / GKD 思路)。
方案:转换后的 student 在其真实块扩散解码分布下采样轨迹 ,冻结的 AR teacher 在恰好这些 committed token 上给稠密逐 token 目标分布。为让两分布可比,对 teacher 与 student 都施加 AR token-shift 对齐,让扩散 student 在自己的解码 context 上对齐 AR 的 next-token 分布。对每个 committed 位置 最小化 forward KL:
因为监督算在模型自己的输出上,训练分布 = 评测分布,直接打分布 gap;且稠密逐 token 目标比单个排序标量给优化器多得多的信号。teacher 是 SFT+RL 的 AR 重排器,所以 OPD 把 student 拉回 teacher 的精度。
- 超参(Appendix A/C):每 prompt 采 条 on-policy 轨迹;teacher logits 每轨迹算一次并缓存;常数 lr ;每 optimizer step 128 prompts;单 epoch;Beauty 上约 1.5k step 收敛。
- 一个变体(备用):改从「同一扩散模型但更高解码 compute(更多去噪步/更少并行)」蒸馏,就把 OPD 变成 latency lever(教快解码模仿慢解码),本文 parity 结果不依赖它。
模块 4 — RL:直接优化排序指标,收尾残差
Reward(复用 GR2,RLVR 范式、可校验而非学习的偏好模型):rank-promotion reward 量化 ground-truth target 被重排提升了多少:
其中 、 分别是 target 在预排列表和重排后列表里的 rank。再加条件 format reward :只有当重排严格提升 target 的 rank(或本就 top-1 被保持在 rank 1)时才给,避免奖励「保序退化」。总 reward ,。
优化(TraceRL 式 trajectory-level GRPO/DAPO):对每 prompt 采 条轨迹一组。不用单次 mean-field 前向打分,而是回放每条 rollout 记录的去噪轨迹:对每个 committed 位置 ,重建它被提交那一去噪步的 masked canvas,在模型推理时的 block-causal 注意力 + AR token-shift 下打分,得到重要性比 。因转换后模型产出合法排列, 在几乎每条 rollout 上都良定义;非法/溢出 rollout 给 reward 但保留在组内,只丢弃 reward 方差为 0 的组(normalized advantage 未定义):
其中 是组内归一化 advantage。
- 超参(Appendix B/C):group size ;clip ;format 权重 ;从 OPD checkpoint 初始化;RL 跑 600 step,lr 。
- 关键经验:RL 在 OPD 之上最有效——OPD 提供健康、on-distribution、非退化的策略起点;headline recipe 是 OPD → RL(先稠密 on-policy 蒸馏恢复主体,再 RL 直接优化指标收尾)。
实验设置与结果
数据集:Amazon Review Beauty,TIGER 协议(5-core 过滤、时间序、leave-one-out 划分)。每 item = 4-token RQ-VAE SID。检索器给 top-10 候选,重排器重排以提升 ground-truth。测试集 用户。
| Dataset | #Users | #Items | Avg. Seq. Len. |
|---|---|---|---|
| Beauty | 22,363 | 12,101 | 8.87 |
指标:Recall@K(K∈{1,3})、NDCG@3(单相关 item,IDCG=1,log2 折扣);效率报 decode 吞吐(tok/s)@ reasoning 输出长度(≈130 token),单张 H100-80G + torch.compile。所有系统同 Qwen3-8B backbone。
Q1 — 恢复转换精度 gap(quality-preserving 解码,):
| Method | Recall@1 | Recall@3 | NDCG@3 |
|---|---|---|---|
| Pre-rank floor (retriever) | 0.2811 | 0.5591 | 0.4401 |
| AR GR2 (reference) | 0.2960 | 0.5651 | 0.4497 |
| Diffusion-GR2, naive (no CFT) | 0.2811 | 0.5591 | 0.4401 |
| Diffusion-GR2 +CFT | 0.2930 | 0.5651 | 0.4497 |
| Diffusion-GR2 +CFT +OPD | 0.2944 | 0.5658 | 0.4497 |
| Diffusion-GR2 +CFT +OPD → RL | 0.2951 | 0.5671 | 0.4517 |
读法:朴素解码只有 ≈0.1% query 吐出合法排序(valid-JSON rate 0.001)、从不重排,非法输出全部 fallback 到检索器序 → 精度塌回 pre-rank floor(0.2811),丢掉全部重排收益。CFT 恢复大部分 gap(Recall@1 0.2930,距 AR 仅 0.0030);OPD 再收(0.2944,距 AR 0.0016);OPD→RL 补最后一点到 0.2951,与 AR teacher 基本持平。更深的 Recall@3/NDCG@3 上,CFT 后就已追平 teacher,后续阶段反超(OPD→RL 拿到全表最高的 Recall@3 0.5671、NDCG@3 0.4517)——RL 在 top-3 里重分配概率而不只盯 top-1。注意这条带很窄:AR teacher 只比 pre-rank floor 高 0.0149 Recall@1,模型处于近饱和 regime,OPD 已近 parity。
Q2 — 精度-延迟 frontier(block size 32,扫 ):
| Decoding | Recall@1 | Throughput (tok/s) | Speedup |
|---|---|---|---|
| AR GR2 | 0.2960 | 71 | 1.0× |
| Diffusion-GR2 (τ=0.9) | 0.2950 | 172 | 2.4× |
| Diffusion-GR2 (τ=0.6) | 0.2942 | 234 | 3.3× |
| Diffusion-GR2 (τ=0.4) | 0.2936 | 246 | 3.5× |
AR 串行 71 tok/s;Diffusion-GR2 并行到 172–246 tok/s,即 2.4–3.5×。 保持 valid-JSON rate=1.0、Recall@1 0.2950@2.4×; 到 3.3×; parsing 开始降。加速随输出长度增长(AR 每 token 付一次串行前向)、随输入长度基本持平——收益来自并行解码而非 prefill,正好利好主导重排延迟的长推理链。
Q3 — 推理质量(LLM-as-judge,50 对盲评):
| Reasoning axis | AR GR2 | Diffusion-GR2 |
|---|---|---|
| History grounding (1–5) | 4.50 | 4.34 |
| Internal consistency (1–5) | 4.94 | 4.94 |
| Logical flow (1–5) | 4.54 | 4.40 |
| Identifier correctness (0/1) | 1.00 | 1.00 |
Diffusion-GR2 每个轴都紧贴 AR;盲配对偏好 AR 17 / Diffusion-GR2 9 / tie 24,100% parse、无 ID 混淆——不是靠退化 filler 凑排序,推理质量无系统性下降。
消融小结(两个 gap 各自贡献):结构 gap 由 CFT 补,是恢复精度的大头(naive 0.2811 → +CFT 0.2930,占回收的绝大部分,且把 valid-JSON 从 0.001 拉到可用);分布 gap 由 OPD 补(+0.0014 到 0.2944,在自采样轨迹上直接纠 off-policy);RL 收尾(→0.2951 并在 top-3 反超)。
思考与可参考价值
局限:① 只在单个学术数据集(Amazon Beauty)、单 backbone(Qwen3-8B)、 短候选上验证,未在工业级大候选/大流量线上做 A/B;② 这条精度带极窄(AR 仅比 floor 高 0.0149 Recall@1),near-parity 的说服力部分来自任务本身天花板低,长候选/难任务上两个 gap 是否同样好补是未知数;③ 提速 2.4–3.5× 是在 reasoning≈130 token、prompt≈2200 token 的特定 operating point 测的,随 降到 0.4 已接近 parsing 崩边界,工业 serving 的 batch/并发下能否复现待验证;④ OPD 需在线 rollout + teacher 逐 token 打分,训练成本不低(虽用 KV cache 缓存 teacher logits)。
对电商/搜推可迁移的点:
- 生成式重排的推理加速对工业 serving 有直接意义:推理式重排的延迟瓶颈就是「长 CoT × AR 逐 token 串行」,而 block-diffusion 的加速恰好随输出长度放大——正是重排延迟的主导项。对「每个 impression 都要过一遍推理重排」的电商精排/重排,这条 AR→块扩散的转换配方给出了一个保精度、砍延迟的可落地模板,不必为提速牺牲让模型准确的那段推理。
- 结构约束的原生化:把「输出必须是合法排列/合法集合」的硬约束通过从 AR 初始化 + CFT 迁移内化进解码器,而非外挂 constrained decoder。这个思路对任何「结构化输出 + 并行解码」的场景(多目标排序、集合选择、结构化生成推荐位)都通用——用一个已经会产出合法结构的 AR 模型当种子,把合法性迁移进快解码器。
- On-policy 蒸馏纠 off-policy:任何「拿 teacher 固定轨迹训 student、但 student 推理时走自己分布」的蒸馏都有 exposure bias。OPD 的做法(在 student 自采样轨迹上用 teacher 做稠密逐 token 监督 + token-shift 对齐)是通用的 off-policy 修正范式,可迁到搜推里的策略蒸馏、快慢模型对齐。
- OPD→RL 的顺序经验:RL 从「健康 on-distribution 起点」出发比冷启更有效——对工业 RLVR 排序调优是一条实用先验:先把策略蒸到 on-policy 健康态,再上 RL 直接优化线上指标(rank-promotion + 条件 format reward 防保序退化)。
- 顺带的加速路线(Next Steps):AR verifier + 块扩散 draft 的 speculative decoding(draft 可以「鲁莽地快」,AR 做最终质量门),以及 pivot-aligned 自适应 block size——对追求极致 serving 延迟的电商重排是值得跟进的方向。