CoNRec: Context-Discerning Negative Recommendation with LLMs
Alibaba Inc. × Fudan University (阿里 × 复旦)
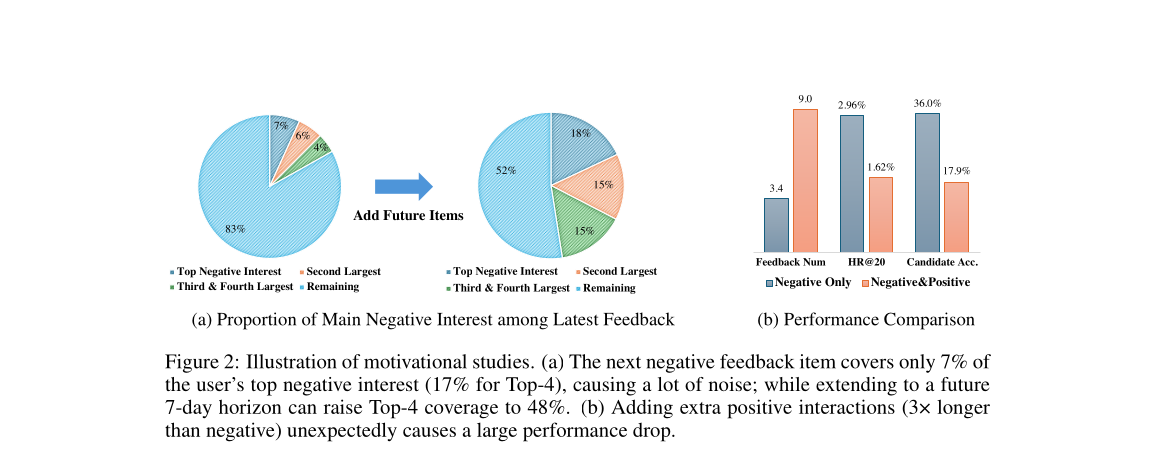
第一个用 LLM 直接「生成式建模用户负向兴趣」的工作(不是把负反馈当辅助信号去增强正推荐,而是离线生成「用户最可能不喜欢的 item 集合」做过滤)。三个核心洞察 + 对策:(1) 负反馈极稀疏、被正序列淹没 → 用 hierarchical Semantic ID 压缩上下文 + Item-Level Alignment(四选一对比任务)让 LLM 先学会「什么 item 会招致负反馈」;(2) next-negative-item 目标被系统曝光顺序污染(只覆盖用户真实 top-1 负兴趣的 7%)→ 把 GT 从「下一个」扩到「未来 7 天 + Swing 协同负 item」,top-4 覆盖率从 17% 升到 64%;(3) 加正序列反而掉 45% → Progressive GRPO 课程式从短到长喂上下文 + reward 同时奖励「与未来负反馈相似」并惩罚「与未来正反馈相似」。淘宝工业数据上 HR@20 +11.5%、长尾 item +24.9%、模拟在线 Candidate Acc. 翻倍(0.29→0.70)。
核心思路
平台越来越重视用户「不喜欢」的表达(淘宝/拼多多/TikTok Shop/YouTube 都有 dislike 按钮),负反馈率已成为和 CTR/GMV 同等重要的用户体验指标。但学界几乎都把负反馈当成辅助信号去增强正推荐,极少有人直接对负向兴趣建模。CoNRec 是第一个用 LLM 做这件事的工作,定位是离线生成「用户最可能给负反馈的 item 集合」,在线时把召排候选 reconstruct 成 embedding,跟这个集合算最大相似度超阈值就过滤掉——既绕开了 LLM 在线推理延迟,又比传统「整类目硬屏蔽」的规则方法精细得多。
把正推荐方法直接搬到负反馈场景会踩三个坑,全篇设计都在解这三个:
- 负推荐不是正推荐的反转。「没有正反馈」通常意味着中性(neutral)而非 dislike,两者中间隔着大片中性空间,所以不能简单把正模型取反。
- 负反馈极稀疏,会被正序列淹没。正序列长度通常是负序列的 5 倍以上,模型注意力被正序列主导,真正该被强调的稀疏负信号被忽略。论文实测:用 LC-Rec 同时喂正负反馈,HR@20 比只喂负反馈掉 45%,模拟在线候选准确率掉 50%(Fig 2b)。
- next-negative-item 目标本身被系统污染。被多次负反馈的 item 早被系统永久过滤、不会再曝光,所以「下一个负反馈 item」更多由系统曝光机制决定、而非用户真实负兴趣。实测只有 7% 的 next 负反馈对应用户 top-1 负兴趣,top-4 也只有 17%(Fig 2a),噪声极大;而扩到未来 7 天,top-1 升到 18%、top-4 升到 48%。
整体实现思路
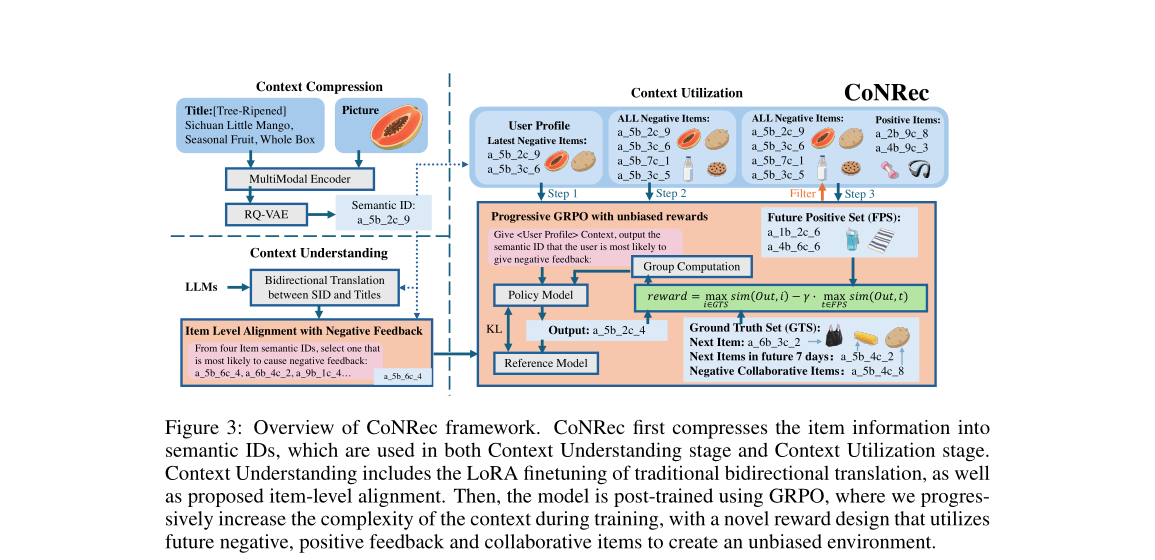
CoNRec 分三个阶段串行(见架构图),全部围绕「让 LLM 辨别负反馈上下文」这一目标:
- Context Compression(上下文压缩):多模态 encoder(title+image,CLIP 风格)→ RQ-VAE → 把每个 item 压成 3 层 hierarchical Semantic ID(如
a_5 b_2 c_9),取代冗长易幻觉的商品标题。 - Context Understanding(上下文理解,LoRA SFT):先做传统的 SID↔title 双向翻译让 LLM 把离散 SID 和语义对齐;再做新提出的 Item-Level Alignment——一个「四选一」对比任务,只看 item 语义不喂用户历史序列,让模型学会「哪个 item 会招致负反馈」。
- Context Utilization(上下文利用,Progressive GRPO):课程学习式地从短到长喂上下文(仅 3 天负序列 → 全部负序列 → 负+正序列),配无偏 reward(奖励与未来负反馈相似、惩罚与未来正反馈相似),解决「稀疏被淹没」和「next-item 被污染」两个核心问题。
子模块实现(可复现细节)
1. Context Compression:RQ-VAE 出 Semantic ID
多模态输入 x(title+image)经 encoder 得连续表征 X ∈ R^d,再经 RQ-VAE 多级残差量化离散化。第 d 层的残差 R^(d) = X − Σ_{i=1}^{d-1} Z^(i),从该层 codebook C^(d) 里选最近 codeword Z^(d),最终量化表征 X̂ = Σ_{d=1}^{D} Z^(d),decoder 重建 embedding。训练 loss(含 stop-gradient sg[·]):
L = ‖X − X̂‖²₂ + λ · Σ_{d=1}^{D} ( ‖R^(d) − sg[Z^(d)]‖²₂ + ‖sg[R^(d)] − Z^(d)‖²₂ )
第一项重建、后两项分别是 codebook loss(codeword 靠近残差)和 commitment loss(残差靠近 codeword)。codebook 用 EMA 更新。超参:3 层 codebook,每层 8192 维。产出形如 a_5 b_2 c_9 的层次化离散码,天然类似类目层级。
2. Context Understanding:双向翻译 + Item-Level Alignment
底座 LLM 用 Qwen3-14B。两步 LoRA SFT(W' = W + ΔW = W + BA,A∈R^{r×d}、B∈R^{d×r}、r≪d):
- 双向翻译:SID↔title 互译,让 LLM 把离散码和文本语义关联。语料 1000 万对常用 SID-标题对。
- Item-Level Alignment(本文新提出):作者论点是「让 item 不可取的因素,并不是让 item 有吸引力因素的简单反面,中间大片是中性的」,所以双向翻译不够。构造四选一对比任务——prompt 给「某用户对 A 点了『不感兴趣』、同时购买了 B/C/D(都用 SID 表示),从 4 个候选 SID 里选出最可能是负向 item A 的那个」。这个任务只看 item 语义、不喂用户 profile / 历史序列,所以上下文短、训练快。正确选项 = 在用户历史负反馈列表里出现 >3 次的 item;3 个干扰项 = 从用户历史购买序列随机抽。构造 400 万条样本。
3. Context Utilization:Progressive GRPO + 无偏 reward
GRPO 目标(DeepSeekMath 同款):给上下文 c,旧策略 π_θold 采样 G 个候选 {y_i},算 reward {r_i},组内归一化得 advantage:
A_{i,t} = ( r_i − mean({r_i}) ) / std({r_i})
loss 含 clip 的 PPO ratio 项 + −β · D_KL(π_θ ‖ π_ref)。
Progressive(课程式)三阶段——上下文从简单到复杂逐步增长,通过调 β 保证每阶段不掉点:
| 阶段 | 喂入上下文 |
|---|---|
| Stage 1 | 仅最近 3 天负反馈序列 |
| Stage 2 | 全部负反馈序列 |
| Stage 3 | 负反馈 + 正反馈序列 |
此外,早期阶段的模型被用来给后期阶段做数据清洗:如果生成的 item 跟「未来会收到正反馈的 item」过于相似,就对这类样本做数据增强。
无偏 reward(核心创新)——把「下一个 item」目标扩成「未来 items」,构造两个集合:
- Ground Truth Set (GTS):未来 7 天内的负反馈 item + 用 Swing 算法挖出的高协同负 item(从负反馈数据里算 item-item 协同)。Swing 公式(
I(u)为用户 u 的负反馈 item 集,Id(x)是阈值函数x>5才算):
Swi(i,j) = Σ_{u∈U(i)∩U(j)} Σ_{v∈U(i)∩U(j), v≠u}
           1/((|I(u)|+α₁)^θ (|I(v)|+α₁)^θ) · Id(|U(i)∩U(j)|)/(|I(u)∩I(v)|+α₂) · 1/√N_j
加上协同 item 后,top-1 负兴趣覆盖率达 25%、top-4 达 64%(vs. 原始 next-item 的 7%/17%)。
- Future Positive Set (FPS):未来会收到正反馈的 item,作为惩罚项。
把所有 SID 经 codebook 映回 embedding,reward = 奖励与 GTS 的最大相似度、惩罚与 FPS 的最大相似度(γ 为惩罚权重):
reward = max_{i∈GTS} sim(Out, i) − γ · max_{t∈FPS} sim(Out, t)
训练数据量:Progressive GRPO 前先用 20 万样本做 warm-up SFT,之后每阶段 10 万样本做 post-training。
4. 工业离线应用
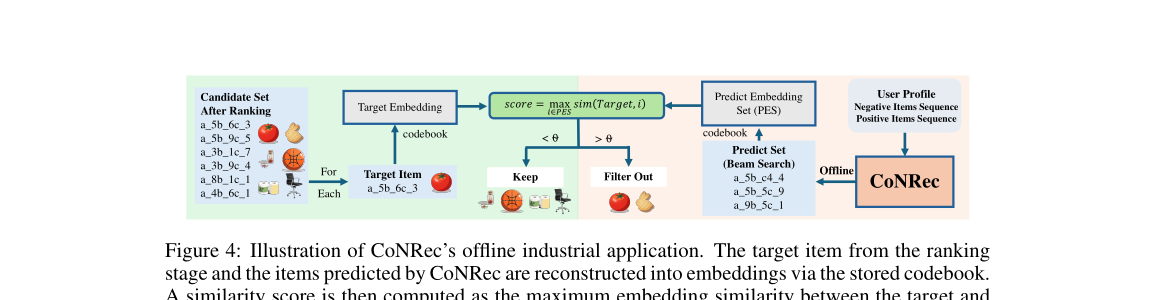
CoNRec 离线 beam search 生成 Predict Set;在线时把召排阶段的 target item 和预测 item 都用存好的 codebook reconstruct 成 embedding,算最大相似度 score = max_{i∈PES} sim(Target, i),超阈值 θ 就 Filter Out、否则 Keep。全程不需要 LLM 在线推理。
实验设置与结果
数据:淘宝真实工业级用户行为日志。负反馈做了语义清洗——只保留与「兴趣」相关的负反馈(不想看该商品/该类目/该店铺、对商品图不适),剔除「看过买过/低价骗点击/疑似假货/疑似 AI 图」等非兴趣类负反馈(那些归用户疲劳/规则机制管)。
评测指标(作者特意弃用 NDCG,因负反馈场景排序相关性无定义):
- HR@20:对 next 负反馈的 top-20 命中率(传统、有偏)。
- FHR@20:对未来 7 天负反馈的 top-20 命中率(本文主推、更泛化)。
- LUF@20 / LIF@20:长尾用户(<3 条负反馈,占 20% 数据)/ 长尾 item(<5 条负反馈,占 12%)上的 FHR@20——LLM 增量上线最看重的冷启场景。
- Candidate Acc.:20 选 1(1 真负反馈 + 19 个当天曝光干扰项),最贴近在线部署。
主结果(Table 1),CoNRec vs. 五类 baseline:
| Model | HR@20 | FHR@20 | LUF@20 | LIF@20 | Cand. Acc. |
|---|---|---|---|---|---|
| SASRec | 0.0180 | 0.0262 | 0.0169 | 0.0280 | N/A |
| BERT4Rec | 0.0186 | 0.0260 | 0.0173 | 0.0311 | N/A |
| FDSA (含特征) | 0.0284 | 0.0374 | 0.0232 | 0.0362 | N/A |
| TIGER (Semantic ID) | 0.0264 | 0.0388 | 0.0232 | 0.0360 | N/A |
| InstructRec (title LLM) | N/A | N/A | N/A | N/A | 0.3453 |
| LC-Rec (Neg.&Pos.) | 0.0159 | 0.0381 | 0.0199 | 0.0351 | 0.1333 |
| LC-Rec (Neg. Only) | 0.0296 | 0.0385 | 0.0258 | 0.0397 | 0.2892 |
| CoNRec | 0.0330 | 0.0441 | 0.0297 | 0.0496 | 0.6950 |
| Improv. | +11.5% | +13.7% | +15.1% | +24.9% | +101.3% |
关键观察:LC-Rec 同时喂正负反馈(0.0159)比只喂负反馈(0.0296)HR@20 掉近一半,印证「正序列淹没」问题;CoNRec 在最有价值的冷启场景上长尾 item +24.9%;模拟在线的 Candidate Acc. 从 0.29 翻倍到 0.70(是次优 InstructRec 0.35 的 2 倍)。
消融(Table 2,逐行累加):
| 配置 | HR@20 | FHR@20 | LUF@20 | LIF@20 | Cand. Acc. |
|---|---|---|---|---|---|
| baseline(双向翻译) | 0.0286 | 0.0364 | 0.0246 | 0.0382 | 0.2764 |
| + Item Level Alignment | 0.0294 | 0.0382 | 0.0262 | 0.0410 | 0.5088 |
| + Progressive-Context GRPO | 0.0308 | 0.0393 | 0.0262 | 0.0428 | 0.5476 |
| + Negative Future Rewards | 0.0330 | 0.0434 | 0.0268 | 0.0452 | 0.6532 |
| + Positive Future Rewards | 0.0330 | 0.0441 | 0.0297 | 0.0496 | 0.6950 |
亮点:Item-Level Alignment 让 Candidate Acc. 从 0.28 直接跳到 0.51(判别能力大增);扩 GT 到未来负 item + 协同 item 让 HR 系列 +5~10%;最后加未来正反馈惩罚主要显著提升长尾用户 LUF。
Reward 方案对比(Table 4):(a) 只奖励与未来负反馈相似 / (b) 只奖励 >0.6 的高相似 / (c) 奖励负 + 惩罚正(最终选用)/ (d) 双截断 / (e) hit-based(命中 3 级 SID 给 1、2 级 0.1、1 级 0.01)。结论:截断影响很小;加正反馈惩罚显著提升 LUF;(e) 因奖励稀疏收敛慢、效果差。
遗忘率分析(Table 3)——从迁移学习视角,中间任务(Item-Level Alignment,高置信低噪声)被遗忘越多说明目标任务噪声越大:
| Task | Acc. | Forget Rate |
|---|---|---|
| Item Level Alignment | 0.755 | N/A |
| Traditional PNI SFT | 0.518 | 31.4% |
| Traditional GRPO | 0.540 | 28.5% |
| CoNRec | 0.652 | 13.6% |
CoNRec 遗忘率最低,反向证明其 next-items reward 设计大幅降低了任务噪声。
Backbone 泛化(Table 5):TBStars007-13B / Qwen3-8B / Qwen3-14B 上 CoNRec 一致优于 LC-Rec(FHR@20 分别 0.0439/0.0410/0.0441),Qwen3-14B 略优。
思考与可参考价值
局限:作者自陈对「完全没有历史负反馈、只有正反馈」的用户效果差(冷启的冷启),正在尝试用 Item-Level Alignment 的对比学习 + 调 GRPO 正反馈惩罚来缓解。另外全文是离线指标 + 模拟在线(Candidate Acc.),没有真实 A/B;Swing 协同、未来 7 天窗口等多处超参(α₁,α₂,θ,γ,β,θ阈值)未给具体值,复现需调。
对电商/搜推可借鉴点:
- 「负反馈不是正反馈取反」这个判断很重要。中间隔着大片中性空间,所以专门设计 Item-Level Alignment 这种「正负对比、四选一」的判别预热任务,而不是简单复用正推荐目标——这个思路可直接迁移到任何「负向/疲劳/审美不适」过滤建模。
- 「next-item 目标被系统曝光污染」的量化诊断(7%/17% 覆盖率)非常有说服力,并给出可操作解法:把 GT 从「下一个」扩到「未来 N 天 + 协同邻居」。这对所有受 feedback-loop 偏置困扰的序列推荐/重排都有参考价值——不只是负反馈,正反馈侧同样适用(作者也强调 FHR 是更泛化的指标)。
- Progressive GRPO 解「长正序列淹没短负序列」:用课程学习从短到长喂上下文 + 调
β守住每阶段不掉点,是一个轻量、可落地的多源信号融合范式;「用前一阶段模型给后一阶段清洗数据」也是很实用的工程技巧。 - 离线生成 + embedding 相似度过滤的部署架构绕开了 LLM 在线延迟,非常适合「LLM 做增量冷启增强、不替换主链路」的工业现实——这是 LLM4Rec 真正能在大流量场景落地的务实路径。
- 遗忘率作为「目标任务噪声」的诊断代理指标是个新颖、低成本的可观测手段,可用来对比不同训练目标/reward 设计的数据质量。