Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations
Google DeepMind × Google
工业排序模型普遍用「随机哈希 video ID」做 item 表征,记忆力强但完全无法泛化到新/长尾 item。本文用 RQ-VAE 把冻结的内容 embedding 量化成层次化离散的 Semantic ID(SID),再用 SentencePiece(SPM) 把 SID 序列切成变长子词去哈希进 embedding 表,从而在 YouTube 十亿级语料的实时排序模型里替换掉 video ID,在不掉整体质量的前提下显著提升冷启动/长尾泛化。关键证据是 SPM-SID 在大 embedding 表下全面优于 N-gram,并能自适应减少头部 item 的 lookup 数。
核心思路
工业级推荐排序模型(这里是 YouTube「下一个看什么」的多任务排序模型)普遍把每个 item 表示成一个随机哈希的 video ID:每个 video 有一个无意义的随机串,经哈希映射到一个 O(10M) 桶的大 embedding 表里。这种做法记忆力极强(能快速学到单个 item 的质量),但有一个根本缺陷:
随机哈希让语义相似的 item 之间没有任何参数共享。新 item / 长尾 item 因为数据稀疏学不好,而且 item 语料是十亿级、幂律分布、动态演化的——随机哈希在分布漂移下完全无法泛化。
一个自然的替代是直接用预训练多模态 item encoder 产出的内容 embedding(content embedding)做特征。但作者在 YouTube 上实测发现:直接拿冻结内容 embedding 替换 video ID 会显著掉质量(Section 4.2),因为排序模型严重依赖 ID embedding 表带来的记忆能力,把可学的大表换成固定 dense 特征就丢了记忆力。端到端训练视频 encoder(VideoRec/Ni et al. 2023)虽能替换 ID,但带来 10–50x 的算力开销,生产不可行。
本文的解法是借用 TIGER(Rajput et al. 2023)的 Semantic ID (SID):用 RQ-VAE 把冻结内容 embedding 量化成一串层次化、序列化、紧凑的离散 code(如 (1,4,6,2))。SID 同时具备两个关键性质:
- 层次性:高层 code 表示粗概念、低层 code 表示细概念,prefix 越长概念越细 → 可用不同长度 prefix 控制泛化粒度;
- 序列性:一串 code 天然像 LLM 里的 token 序列,可以借用子词切分(SentencePiece)。
SID 让「语义相似 item 共享 code(受控的有意义碰撞)」取代「随机碰撞」,从而在保留可学 embedding 表(记忆力)的同时获得泛化力。本文的真正贡献不是 SID 本身(来自 TIGER),而是如何把紧凑的 SID 序列适配进资源受限、低延迟的生产排序模型——核心是把 SID 序列哈希成子词。
整体实现思路
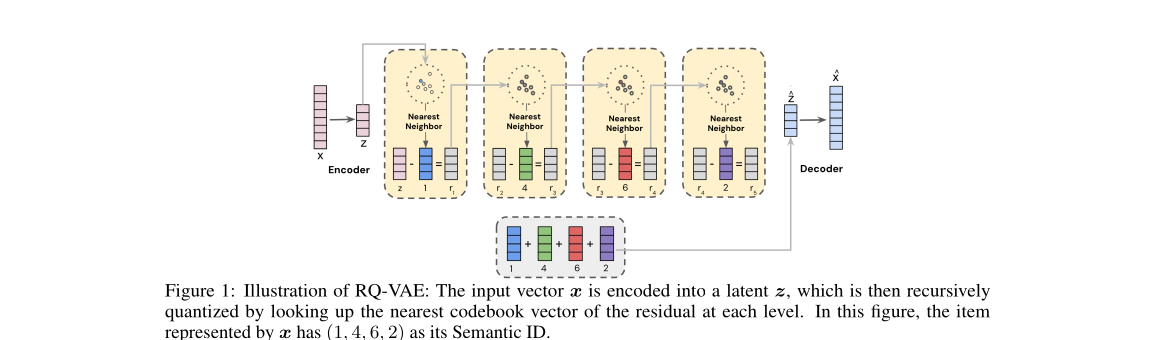
两阶段,且 Stage 1 训完即冻结:
- Stage 1 — 把内容 embedding 压缩成离散 SID:用 RQ-VAE(残差量化 VAE)对每个 video 的 2048-d 内容 embedding 做 L 级残差量化,得到长度 L=8 的 code 序列。训完冻结 RQ-VAE,之后只用它的 encoder 给所有(含新)video 产 SID。压缩是为了能高效表示用户历史——每个历史 item 只需存几个整数而非高维向量。
- Stage 2 — 用 SID 训排序模型:用冻结 RQ-VAE 把每个 item 映射成 SID,再为 SID 学 embedding(与排序模型其余部分联合训练)。排序模型在最近日志数据上顺序训练(sequential training)。
一个关键设计争议是「冻结 RQ-VAE 会不会随时间过期」——新 video 可能不在 RQ-VAE 的训练分布里。作者在 Appendix A.2 用相隔 6 个月数据训的 RQ-VAEv0/v1 做对照,发现下游排序质量基本一致,说明 video 的语义 token 空间随时间稳定,冻结是安全的。
子模块实现(可复现细节)
RQ-VAE:从内容 embedding 生成 SID(Fig 1)
三个联合训练组件:
- Encoder E:把内容 embedding x ∈ R^D 映射到 latent z ∈ R^{D’};
- 残差量化器:L 级,每级一个 codebook C_l = {e^l_k}{k=1}^K,e^l_k ∈ R^{D’}。逐级把残差 r_l 量化到最近的 codebook 向量 e{c_l};第 l 级的 code c_l 就是 SID 的第 l 位;
- Decoder D:把量化后的 latent ẑ 解回内容 embedding 空间 x̂。
损失:L = L_recon + L_rqvae,其中
L_recon = ||x − x̂||²(重建内容 embedding);L_rqvae = Σ_{l=1}^L β·||r_l − sg[e_{c_l}]||² + ||sg[r_l] − e_{c_l}||²,sg 为 stop-gradient。第一项把 codebook 拉向残差(codebook loss),第二项把 encoder 输出(残差)拉向 codebook(commitment loss)。
超参(Appendix A.1):
- 1 层 encoder-decoder,维度 256;
- L = 8 级量化,每级 codebook size K = 2048;
- β = 0.25;
- 在随机采样的 impressed video 上训到重建 loss 稳定(约 10s of millions steps);
- 抗 codebook collapse:每步把未使用的 codebook 向量重置为 batch 内随机采样 video 的内容 embedding(Zeghidour et al. 2021 的技巧),显著提升 codebook 利用率。
内容 embedding 来源:video encoder 是以 VideoBERT 为 backbone 的 transformer,输入音频+视觉特征,输出 2048-d 表征(捕捉视频的 topicality),按 Lee et al. 2020 训练。
SID 在排序中的表征:N-gram vs SPM(核心适配)
对 item v,RQ-VAE 给出 SID (c^v_1, ..., c^v_L)。适配的核心是把这串 code 切成子词,每个子词哈希到一个可学 embedding。两种切法:
(1) N-gram-based:把 SID code 按长度 N 分组成子词,每个子词配一个可学 embedding,item 表征 = 所有子词 embedding 求和(sum)。
- Unigram(N=1):L 个子词
(c^v_1),...,(c^v_L); - Bigram(N=2,不重叠):L/2 个子词
(c^v_1,c^v_2),...; - 每个 N-gram 分组学独立的 embedding 表,因每个 code cardinality 为 K,该表有 K^N 行。所以 Unigram-SID 表共 8×K 行,Bigram-SID 表共 4×K² 行。
- 局限:(a) 固定分组无法适配 SID 语料的实际分布,表利用稀疏;(b) 行数随 N 指数增长,内存爆炸 → 实验只用 N ≤ 2。
(2) SPM-based(本文主推):用 SentencePiece(Kudo 2018) 在 impressed item 的分布上动态学 SID 子词。
- 变长子词:频繁共现的 code 自动合并成一个子词,罕见共现的回退到 unigram;
- 学单一 embedding 表,每行对应一个变长子词;
- 在固定 embedding 表 size 约束下自适应构造子词词表 → 在泛化与记忆之间取得平衡。
- 给定固定表大小,SPM 动态生成子词、每个映射到唯一表项,最优化表征效率。
评测指标定义
- 顺序训练在前 N 天数据,用第 (N+1) 天数据测 CTR AUC(整体泛化 / 分布漂移能力);
- 进一步只切第 (N+1) 天新引入的 item,记为 CTR/1D AUC(冷启动泛化能力);
- 生产标准:CTR AUC 变化 0.1% 即视为显著。
实验设置与结果
排序模型:YouTube 生产多任务排序模型(Zhao 2019 / Tang 2023),给定当前观看 video + 用户历史,排序下一个 video。基线用随机哈希 video ID 表示三个关键特征:用户 watch history、watch video、候选 video。O(10M) 哈希桶承载 O(100M) video。
对比方法:
- Random Hashing(随机哈希 ID 基线,相对它算 % 提升,基准为 8K 表);
- Dense Input(直接用 raw 内容 embedding;另加 1.5x / 2x 层数变体做公平对比);
- Unigram-SID / Bigram-SID(N-gram,sum 聚合);
- SPM-SID。
两种 setting:(a) 不用 user history(只用 current + candidate video 两个特征,Fig 2);(b) 用 user history(Fig 3)。因为给历史里每个 video 存内容 embedding 极耗资源,Dense Input 只在 setting (a) 可比。
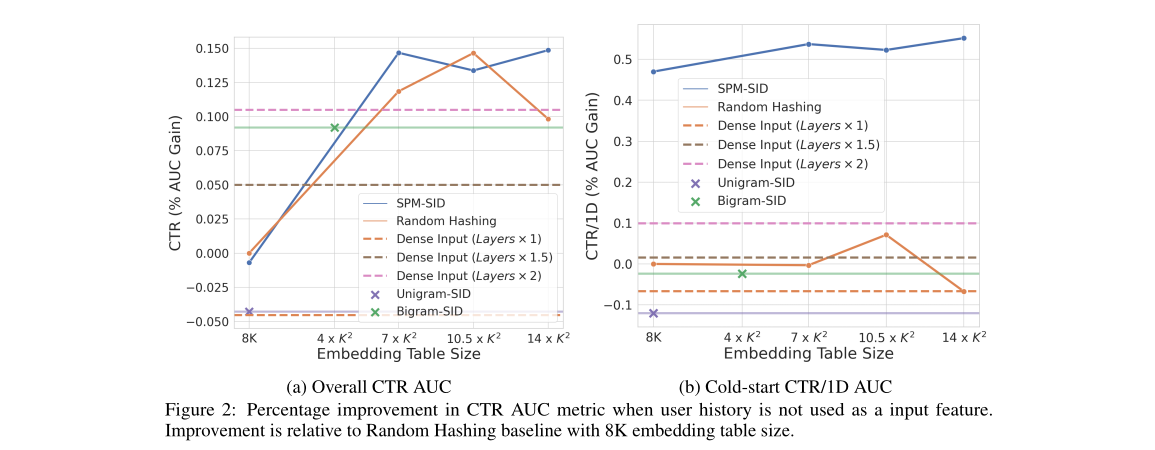
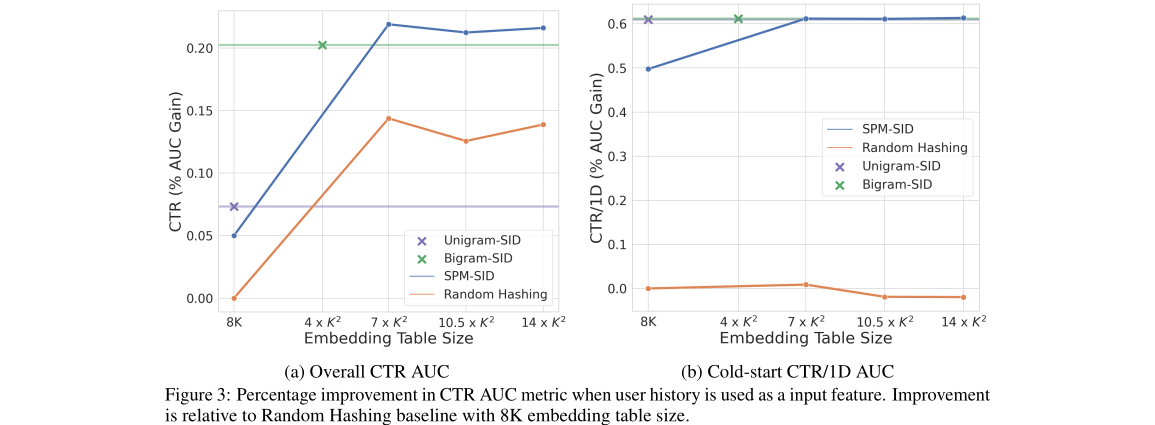
关键结论(百分比相对 Random Hashing-8K):
| 现象 | 结论 |
|---|---|
| Dense Input(不改架构) | 整体 CTR 差于 ID 基线——印证排序模型重度依赖 ID 表的记忆力 |
| Dense Input + 1.5x / 2x 层 | 层越多记忆/泛化都越好(2x > 1.5x),但 serving 成本大涨,不可行 |
| Unigram/Bigram-SID(无 history,Fig 2) | 整体 CTR 差于随机哈希——训练内容有偏导致表利用稀疏 |
| Unigram/Bigram-SID(有 history,Fig 3) | 优于随机哈希——历史 video 内容更多样,表利用更均匀 |
| SPM-SID(大 embedding 表) | 全面优于 N-gram,尤其 CTR/1D(冷启动)提升明显 |
| SPM-SID(小表 8×K 或 4×K²) | 略逊于 N-gram——小表下 SPM 词表太小,捕捉不到复杂语义关系 |
| 综合 | 大规模生产模型必然用大表 → SPM-SID 最有利;Bigram-SID 与 SPM-SID 均显著超随机哈希 |
效率(Fig 4):N-gram 用固定 lookup 数(Unigram=8,Bigram=4)。SPM-SID 给定固定表 size 动态生成子词,对头部/常见 video 动态减少 lookup 数,而平均 lookup 数与 N-gram 持平——既高效又可扩展。
SID 的层次性验证(Appendix A.4,Table 1):
| 共享 prefix 长度 | 内容空间平均两两余弦相似度 | 典型 sub-trie 大小(25–75 分位) |
|---|---|---|
| 1 | 0.41 | 150,000–450,000 |
| 2 | 0.68 | 20–150 |
| 3 | 0.91 | 1–5 |
| 4 | 0.97 | 1 |
prefix 越长 → 相似度越高、sub-trie 越小,证明 SID prefix 表示越来越细的概念。Fig 6/7 给出 sports / food vlogging 的真实 sub-trie 层次示例。
稳定性(Appendix A.2):相隔 6 个月数据训的 RQ-VAEv0/v1,下游 SID-3Bigram-sum 排序质量基本一致(Fig 5),说明语义 token 空间随时间稳定,冻结 RQ-VAE 可长期使用。
思考与可参考价值
这篇是「Semantic ID 落地工业排序」的最早系统性案例之一(v2, 2024-05),价值不在算法新颖性(RQ-VAE/SID 来自 TIGER),而在把生成式检索里的 SID 搬进资源受限、实时低延迟的排序场景时踩出的工程结论:
- 直接用 dense 内容 embedding 替换 ID 会掉质量——这是反直觉但极其重要的工业事实:排序模型的核心竞争力是大 embedding 表的记忆力,盲目上”内容特征”会丢记忆。SID 的意义是「保留可学大表 + 注入语义碰撞」,鱼和熊掌兼得。
- SPM > N-gram,但仅在大表下——把 LLM 的子词切分思想迁移到 SID 序列是这篇最巧的点。变长子词让头部 item 用更少 lookup、长尾自动回退 unigram,自适应平衡记忆与泛化。这对电商/搜推里「item ID 稀疏 + 头部幂律」高度同构。
- user history 是 SID 起效的前提——N-gram-SID 在无 history 时甚至差于随机哈希(表利用稀疏),有 history 时才翻盘。提示:内容化 item 表征要起效,依赖输入侧有足够多样的 item 覆盖来均匀使用表。
局限:
- 全篇是 YouTube 单一私有系统的 case study,无公开数据集/代码,绝对数字也只给相对 % 和定性图,不可直接复现;
- RQ-VAE 冻结的稳定性只验证了 6 个月窗口、且 video topicality 较稳定,电商场景品类/流行度漂移更快,冻结风险需重新评估;
- 没有和「端到端 VideoRec」「多重哈希」等更强基线的并列定量对比,只有定性论述。
对电商/搜推/Agent 的可借鉴点:
- 商品 ID → 内容 SID:把商品多模态 embedding(图文+类目+属性)量化成层次 SID,可让同类/相似 SKU 共享参数,缓解新品/长尾冷启动;prefix 天然对应类目层级,可做粒度可控的召回/排序特征。
- SPM 子词哈希是一个轻量且即插即用的 trick:在固定 embedding 预算下,用商品 SID 共现分布学变长子词,比固定 N-gram 更省 lookup、更适配长尾,工程改造成本低(不动主模型,只改特征侧)。
- 两阶段冻结范式对生产友好:SID 生成器离线训一次冻结,在线只查表,避免端到端视频 encoder 的 10–50x 算力;新品来了直接过冻结 encoder 出 SID,无需重训主模型。