APAO: Bridging the Training-Inference Gap in Generative Recommendation via Adaptive Prefix-Aware Optimization
清华大学 DCST × 清华 AIR × 泉城实验室
指出生成式推荐一个被系统性忽略的错配:训练用 CE(teacher-forcing,只约束「总分」这一个标量),推理用 beam search(每一步都做 top-K 剪枝)。这两者是不同的成功条件——full-sorting 只要求「累计总分进 top-K」,允许中间步用后面的 token 补偿;beam search 要求「每一个前缀都进 top-K」,是一条合取约束链,任意一步失守则整个 item 永久出局。CE 从未因「掉出 beam」被惩罚过,于是全局 Top-20 里有 16% 在解码中途被剪掉。APAO 把这条前缀级约束显式写进训练目标:给每个前缀长度加 pointwise / pairwise 排序损失,再用 KKT 闭式解的自适应权重把优化压力动态压到「当前最弱的前缀」上(beam 成败由最短板决定)。理论上证明它是 beam search recall 的下界代理,且 pointwise 变体与 CE 同复杂度、零额外 forward。TIGER/Llama 双骨干四数据集全面提升(Llama 上 Recall@10 最高 +13.39%),微信公众号平台线上 A/B pCTR +0.9%。
核心思路
一句话问题:生成式推荐(GR)把 item 切成 T 个离散 token(RQ-VAE / RQ-K-means 语义码),训练时用 cross-entropy + teacher-forcing,推理时用 beam search。但这两个阶段要求的成功条件根本不是同一件事——训练目标从未包含「不许掉出 beam」这条约束。
关键 idea:把 beam search 的前缀级排序约束显式补进训练损失,并且自适应地把优化火力集中在当前最弱的那个前缀上。
这里的概念区分是全文的地基,值得先讲清楚。设目标 item 的 token 序列为 ,token 级得分 。
全空间排序(理想视角)——如果对全库 item 逐个算分再排序(Full Sorting),命中条件只看最终累计分:
I_Full(y) = 1[ rank_Y( S(y|x) ) ≤ K ], S(y|x) = Σ_{t=1..T} log P(y^t | y^<t, x)
这是一个标量条件。中间某个 prefix 概率很低没关系,只要后面的 token 能补回来,item 依然能被召回。
Beam search(真实视角)——每一步只保留 top-K 前缀,成功条件变成一条合取约束链:
I_Beam(y) = Π_{t=1..T} 1[ rank_t( S_t(y^{1:t}) ) ≤ K ], S_t(y^{1:t}) = Σ_{j=1..t} log P(y^j | y^<j, x)
不一致的本质:CE 优化的是「平均 token 似然」,允许步与步之间做 trade-off;beam search 要求所有 step-wise 约束同时满足,对任何一个中间步的失败零容忍。而模型在 teacher-forcing 下训练,从来没有因为「掉出 beam」而被惩罚过,自然学不会抵抗剪枝。
这不是纸面推演。下图 (c) 是实测:用 Full-Sorting 算出的全局 Top-20 item,经过 4 步 beam 解码后,baseline 只剩 83.94% 存活——约 1/6 的正确答案是在解码中途被剪掉的,而不是模型算不准。同时 (b) 说明为什么不能简单放弃 beam search 改用全库排序:Yelp 上 Full Sorting 比 beam search 慢 52.648 倍,工业上不可行。
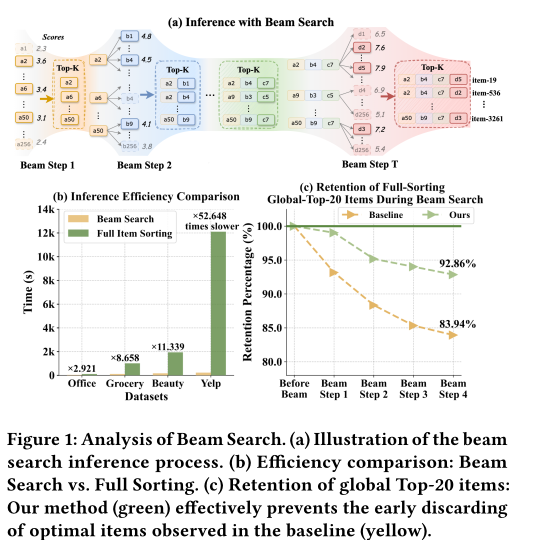
所以作者选择训练侧解法而非推理侧:改 beam search 管线(如放大 beam、加 rerank)都要付线上延迟,而改损失函数推理零成本。
整体实现思路
端到端 pipeline 非常轻——它不改模型结构、不改数据、不改推理,只改损失函数:
- 输入:用户历史 (截断到最近 20 个 item)+ 目标 item 的 T 个语义码 token ;pairwise 变体额外采 N 个负 item。
- 一次 forward:拿到全部 T 个位置的 logits (和标准 CE 训练完全一样的那一次)。
- 算 T 个前缀损失:对每个前缀长度 ,直接复用同一批 logits 算 (pointwise 或 pairwise)——不需要任何额外 forward pass,这是复杂度不涨的根本原因。
- 自适应加权:用上一步的权重 和当前各前缀损失,按闭式解做一次乘性更新,得到 (detach,不回传梯度)。
- 合成总损失:,反传更新 。
- 推理:原样的 beam search,一行代码都不用改。
统一目标(Eq. 11):
L_unified = L_CE + β · Σ_{m=1..T} w_m · L_m
控制前缀约束与 token 似然的权衡;剩下两个问题就是 取什么形式(§4.2)、 怎么定(§4.3)。
子模块实现(可复现细节)
模块 A — Prefix-aware Pointwise Loss
动机:既然 beam 在每个深度都要排序,那就在每个深度都给一份监督。
输入/输出:输入 token 级 log-softmax 后的 token_logp(形状 [B, T],只 gather 目标 token);输出 T 个标量损失。
公式(Eq. 12):
L_point(m) = - (1/m) · Σ_{t=1..m} log( exp(z^t_{y^t}) / Σ_{j∈V} exp(z^t_j) ), m ∈ {1..T}
注意两个细节:
- 它是长度归一化的(除以 ),所以不同前缀长度的损失量级可比,加权求和才有意义。
- 时它就退化成 本身。所以 里天然含一份 CE, 实际上是在给「早期前缀」额外加码。
几何解释:pointwise 相当于对不同解码位置分配不同的优化重心,本质是数据分布克隆,不建模相对序关系——这是它的短板,但换来了零负采样成本。
开销:,与 CE 完全相同。
模块 B — Prefix-aware Pairwise Loss
动机:beam 剪枝本质是排序,pointwise 学不到「正前缀要压过负前缀」这层关系。
输入/输出:输入正 item 前缀 + N 个负 item 截断到同长度 得到的负前缀集合 ;输出 T 个标量损失。
前缀累计分(Eq. 13,注意这里 不 做长度归一化):
S_i^m = Σ_{t=1..m} s_i^t
损失(Eq. 14):
L_pair(m) = - log σ( - log Σ_{j∈N} exp( S^m_{j,-} - S^m_{i,+} ) )
展开就是一个 softmax 形式的对比损失:。
与 S-DPO 的区别(Appendix D,这是最容易混淆的点):两者都是「多负样本 softmax 排序损失」,形似但粒度不同——
- S-DPO 在完整 item 序列级别做一次求和,只比较最终的完整 item;且需要 reference model 算 log-ratio。
- APAO-pairwise 在每一个中间前缀步都做一次,是稠密监督;且不需要 reference model,所以训练反而比 S-DPO 更快(Office 上 163s/epoch vs 199s/epoch)。
开销:,与 S-DPO 同阶。
模块 C — Adaptive Worst-prefix Optimization(全文最巧的一块)
动机: 个 如果当超参调,组合爆炸不可行。更重要的是——由 Eq. 9,任一前缀失守则整条路径出局,所以解码过程的瓶颈是「当前最弱的那个前缀」,优化应该向它倾斜。
最直接的形式是 Hard-Max(Eq. 15):。但用 mini-batch 的瞬时损失去挑 worst 会剧烈抖动。
软化方案(Eq. 16):在单纯形 上做带 KL trust-region 的最大化——
w^(τ+1) = argmax_{w ∈ Δ_T} Σ_m w_m L_m - (1/η) · KL(w ‖ w^(τ))
闭式解(Eq. 17,Appendix A 用 KKT 证明唯一最大值):
w_m^(τ+1) = w_m^(τ) · exp(η · L_m) / Σ_j w_j^(τ) · exp(η · L_j)
这就是一个在对数空间的乘性权重更新(指数梯度上升):损失大的前缀权重指数级上升, 控制变化剧烈程度(越小越平滑)。 初始化为均匀 ,跨 mini-batch 持续演化,并且用 detach() 切断梯度——权重只是标量调度器,不参与反传。
证明要点(Appendix A):目标函数在 上严格凹(线性项 + 严格凹的熵项),KKT 条件充要;由于 时 KL 梯度在边界发散,最优解必在内部,故 ,代入平稳性条件即得上式。
模块 D — 统一训练算法(Algorithm 1,可直接对照实现)
# 初始化:w ← [1/T, ..., 1/T]
for (x, y) in dataloader:
    if mode == 'Pairwise':
        neg = sample_negatives(y, K=100)      # uniform random
        cands = cat([y], neg)                 # [1+N, T]
    else:
        cands = y                             # [1, T]

    logits = model(x, cands)                  # 唯一一次 forward
    L_CE      = cross_entropy(logits_of_y, y)
    L_prefix  = calc_prefix_loss(logits, cands, mode)   # 返回 T 个标量
    w         = adaptive_update(w, L_prefix, eta)       # detach,见模块 C
    L_total   = L_CE + beta * (w * L_prefix).sum()
    L_total.backward(); opt.step()


def calc_prefix_loss(logits, cands, mode):
    log_probs = F.log_softmax(logits, dim=-1)
    token_logp = log_probs.gather(2, cands.unsqueeze(-1)).squeeze(-1)   # [B, T]
    losses = []
    for t in range(1, T + 1):
        if mode == 'Pointwise':
            prefix_logp = token_logp[:, :t].sum(dim=1) / t              # 长度归一化
            loss_t = -prefix_logp.mean()
        else:                                                           # Pairwise
            prefix_score = token_logp[:, :t].sum(dim=1)                 # 不归一化
            pos_score, neg_scores = prefix_score[0], prefix_score[1:]
            pos_exp     = torch.exp(pos_score)
            neg_sum_exp = torch.exp(neg_scores).sum()
            denom       = pos_exp + neg_sum_exp + 1e-12
            loss_t      = -torch.log(pos_exp / denom)
            loss_t      = loss_t.mean()
        losses.append(loss_t)
    return torch.stack(losses)


def adaptive_update(w_last, losses, eta):
    base_loss = losses.detach()                    # 关键:不回传
    w_new = w_last * torch.exp(eta * base_loss)
    return w_new / w_new.sum()
模块 E — 理论保证(Theorem 1)
结论:优化前缀损失 = 优化 beam search 下 recall 指标的下界,因此是排序目标的合理代理。
证明链条(Appendix B,逻辑很干净):
- 由 union bound:,其中 是第 步排序失败事件。
- 定义 。失败意味着至少一个负前缀分数超过正前缀,即 ;由 log-sum-exp 上界 max,得 。
- 引入指数代理 ,得 。
- 又 ,且 ,故:
I_Beam(y) ≥ 1 - Σ_{m=1..T} exp( L_pair(m) )
即最小化前缀 pairwise 损失 = 最大化 beam search 召回的下界。Pointwise 变体的证明同理——把 CE 看作「以全词表非目标 token 为负样本」的 pairwise 损失即可。
实验设置与结果
设置
| 项 | 配置 |
|---|---|
| 数据集 | Office (4,905 用户 / 2,420 item / 53,258 交互 / 0.45%)、Grocery (14,681 / 8,713 / 151,254 / 0.12%)、Beauty (22,363 / 12,101 / 198,502 / 0.07%)、Yelp (30,431 / 20,033 / 316,354 / 0.05%) |
| 预处理 | 五核过滤 + leave-one-out 划分;用户历史截断到最近 20 个 item |
| Tokenizer | Llama-3.1-8B-Instruct 抽语义 embedding → 4 级 RQ-K-means(所以 T=4) |
| 骨干 | TIGER(enc-dec,编/解码器各 4 层、6 头、head dim 64、ReLU)、Llama(8 层 decoder-only);token embedding 128 维,均 ≈0.01B 参数 |
| 训练 | AdamW,lr 5e-4,1% warmup + cosine decay;最多 200 epoch,early stop patience 20;batch 1024(128/卡 × 8 步梯度累积);1× A100-40G |
| 推理 | beam search,beam size = 20 |
| 负采样 | 均匀随机,所有方法统一固定 100 个负样本(保证公平) |
| 超参搜索 | , |
| Baseline | CE、MSL、CE→DPO、CE→DMPO、CE→S-DPO |
| 指标 | Recall@{10,20}、NDCG@{10,20} |
各数据集最优超参(Table 5):TIGER-Pointwise 用 =0.3/0.1/0.1/0.05、=1e-4/5e-5/1e-5/1e-5(Office/Grocery/Beauty/Yelp);Llama 侧 普遍更大(0.3~0.4)。经验区间是 ,大数据集倾向更小的 以求稳定。
主结果(Table 1,节选 Recall@10)
| 骨干 | 方法 | Office | Grocery | Beauty | Yelp |
|---|---|---|---|---|---|
| TIGER | CE | 0.0608 | 0.0775 | 0.0611 | 0.0384 |
| TIGER | 最强 baseline (S-DPO/MSL) | 0.0638 | 0.0770 | 0.0606 | 0.0389 |
| TIGER | APAO-Pointwise | 0.0667* | 0.0815* | 0.0637* | 0.0411* |
| TIGER | APAO-Pairwise | 0.0671* | 0.0811* | 0.0639* | 0.0412* |
| Llama | CE | 0.0469 | 0.0647 | 0.0516 | 0.0267 |
| Llama | 最强 baseline (S-DPO) | 0.0493 | 0.0682 | 0.0480 | 0.0262 |
| Llama | APAO-Pointwise | 0.0559* | 0.0701 | 0.0564* | 0.0289* |
| Llama | APAO-Pairwise | 0.0557* | 0.0741* | 0.0548* | 0.0287* |
(* 表示对最强 baseline 的单样本 t 检验 )
相对最强 baseline 的最大提升:TIGER 上 +2.50% ~ +6.60%;Llama 上 +5.08% ~ +13.39%(Office R@10 最高)。decoder-only 骨干收益明显更大。
一个值得注意的负面观察:DPO / DMPO 常常比朴素 CE 还差(如 Llama-Beauty R@10:CE 0.0516 → DPO 0.0364)。序列级偏好对齐直接搬到 GR 上并不 work,这反过来印证了「粒度」才是关键。
消融(Beauty + Llama,NDCG@10)
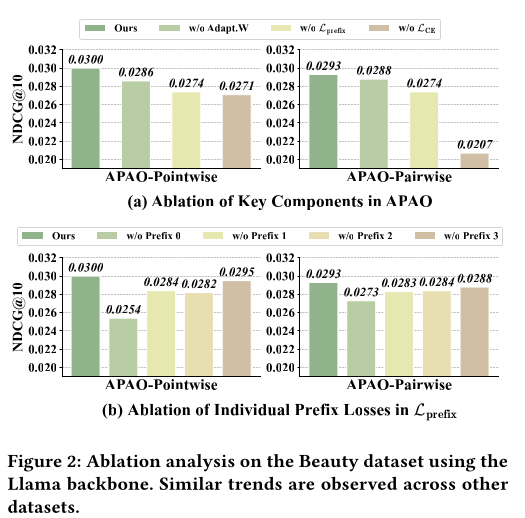
(a) 组件消融:Pointwise 0.0300 → 去自适应权重 0.0286 → 去 0.0274 → 去 0.0271;Pairwise 0.0293 → 0.0288 → 0.0274 → 0.0207(去掉 CE 后 pairwise 崩得最惨,说明纯排序损失缺少似然锚点会失稳)。
(b) 逐前缀消融(信息量最大的一张图):Pointwise 完整 0.0300,去掉 Prefix 0 直接掉到 0.0254(−15.3%),而去掉 Prefix 3 只掉到 0.0295(−1.7%)。越早的前缀越关键,重要性单调递减——第一级语义码一旦排不进 top-K,后面再准也没用。
(c) 加权策略(Figure 3):自适应 > 固定指数衰减 > 均匀。Pointwise Recall@10:Ours 0.0564 / Uniform-W 0.0529 / Decay-W 0.0535。
前缀级验证(RQ3,最直接的因果证据)
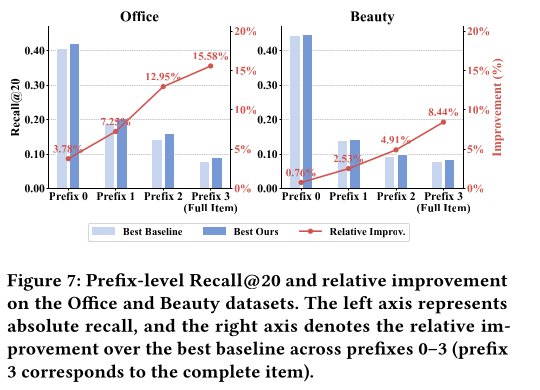
按 4 级语义码逐层看 Recall@20,APAO 在所有前缀深度都超过最强 baseline,且相对提升随前缀变长单调增大:
| Prefix 0 | Prefix 1 | Prefix 2 | Prefix 3 (完整 item) | |
|---|---|---|---|---|
| Office | +3.78% | +7.23% | +12.95% | +15.58% |
| Beauty | +0.76% | +2.53% | +4.91% | +8.44% |
这条递增曲线正是「防止正确 item 被逐步剪掉」的直接体现——beam 展开得越深,累积保住的正确候选越多。
其他分析
- 训练范式(Table 3):1-Stage APAO 在 TIGER 上最优(Office NDCG@10 0.0337 vs 2-Stage S-DPO 0.0321)。有意思的是 Llama 上 2-Stage [CE→] 反而更好(Office 0.0278 > 1-Stage 0.0265,Beauty 0.0308 > 0.0300)。另外把 S-DPO 强行做成 1-stage 会彻底崩(0.0116 / 0.0089),说明 APAO 天然适配单阶段是它自己的性质,不是所有排序损失都能这么用。
- Tokenizer 鲁棒性(Figure 4):换 Suboptimal RQ(10% 码随机扰动)和 OPQ,APAO 依然稳定超 baseline(OPQ 上 0.0290 → 0.0308),不绑定特定 tokenizer。
- Beam size 可扩展性(Figure 6):APAO 在 K=20 时的 NDCG@5 已经追平甚至超过 baseline 在 K=100 时的表现——线上可直接把 beam 砍 5 倍。
- 训练效率(Table 4,TIGER,秒/epoch | 收敛 epoch 数):Pointwise 与 CE 基本持平(Office 15|45 vs 15|45;Beauty 54|83 vs 53|74);Pairwise 全面快于 S-DPO(Office 163|58 vs 199|93,Grocery 456|67 vs 572|106),因为省掉了 reference model 的额外推理。
- 工业落地:APAO-Pointwise 已部署到微信公众号平台推荐系统,对照线上 CE 基线:pCTR +0.9%、图文 CTR +0.706%、人均图文点击 +0.907%、人均图文曝光 +0.205%。
思考与可参考价值
可直接借鉴的点
-
问题的适用面远大于推荐。凡是「训练用 teacher-forcing、推理用受限/剪枝解码」的系统,都存在同一个缺口:SEO 推词生成、query 改写、SID 生成、Agent 的 tool-call 序列生成——只要线上跑 beam search 或 constrained decoding,训练目标里就少了那条前缀级约束。这篇提供的是一个可移植的诊断视角:先去量一下你的「全局 Top-N 在解码中途的存活率」,83.94% 这个数字很可能在你的链路里也成立。
-
Pointwise 变体的 ROI 高到不合理。它就是在已有 logits 上多算 T 个长度归一化的前缀 NLL,加权求和——零额外 forward、零额外显存、代码不到 30 行、推理侧完全不动,却在 Llama 骨干上拿到 5~13% 的相对提升。这种改动值得在任何 GR 链路上先试一次。
-
自适应权重是个通用模板。「乘性更新 + KL trust region → KKT 闭式解」这套东西不限于前缀损失,任何「N 个子损失、想自动聚焦当前最难的那个」的场景都能套(多任务、多目标、多场景联合训练)。相比 GradNorm / 不确定性加权,它的形式简单到只有一行
w *= exp(η·L); w /= w.sum(),且有严格凸优化保证。要注意它优化的是 max(focus on worst),适用前提是「木桶效应」——最短板决定成败。用在「平均值决定成败」的场景就不对了。 -
对 Semantic ID 设计的直接启示。逐前缀消融给出的结论很硬:去掉 Prefix 0 的监督掉 15.3%,去掉 Prefix 3 只掉 1.7%。这意味着粗粒度第一级码的判别力决定整条召回链路的上界。我们在做 SID tokenizer 时,码本层级的容量分配、第一级的可分性度量,应该被当作一等公民而不是均匀对待;同理,如果要给 SID 加辅助监督,优先加在浅层。
-
beam size 砍 5 倍是比指标更实在的收益。K=20 追平 baseline 的 K=100,直接对应线上解码成本降一个量级。对高 QPS 的召回链路,这条可能比 +0.9% pCTR 更值钱。
-
序列级偏好对齐搬到 GR 上会翻车。DPO/DMPO 普遍低于朴素 CE 这个负面结果,比 APAO 自己的正面结果更有警示价值——不要因为 LLM 那边 DPO 好用就直接搬。
局限与存疑
-
T=4 太短,长序列未验证。全部实验都在 4 级 RQ 码上(T=4),前缀只有 4 个。当 T 变大(OneRec 那类更长 SID、或 LLM 直接生成长 item 描述)时,T 个前缀损失的开销、以及权重在 T 维单纯形上的分布是否还稳定,完全没有实验。 式的截断策略也没讨论。
-
负采样是明显的未尽之处。作者自己承认「固定 100 个均匀随机负样本,更好的采样策略留作 future work」。但恰恰在这个方法里,hard negative 在前缀级别有非常明确的语义——就是那些「前缀撞车」的 item(共享前 m 个码却不是目标)。这才是 beam 里真正在竞争的对手,用均匀随机负样本等于放着最相关的信号不用。这是我认为最容易拿到额外收益的方向。
-
训练侧的负前缀分布 ≠ 推理侧的竞争前缀分布。负前缀是从随机负 item 截断得到的,而 beam 里真正竞争的是模型自己打分打上来的 top-K 前缀。所以 APAO 缩小了 gap,但没有消除——它引入了一个更小的、新的 train-inference 分布差。真正闭合需要 on-policy 地采 beam 内前缀(代价是要多跑解码)。
-
自适应权重缺少诊断。 是跨 mini-batch 持续的乘性累积,没有衰减项也没有重置机制。理论上长训练下 可能逐渐塌到某一个前缀上,论文既没给 的演化轨迹图,也没做训练时长与 熵的分析。实际复现时建议监控 的熵。
-
1-Stage 的叙事有点选择性。Table 3 显示 Llama 骨干上 2-Stage 的 CE→ 在两个数据集上都优于 1-Stage(0.0278 vs 0.0265、0.0308 vs 0.0300),但正文强调的是「我们天然适配 1-stage」。更准确的说法是:APAO 两种范式都能用,具体哪个好取决于骨干。
-
线上只验证了 pointwise。+0.9% pCTR 来自 APAO-Pointwise;pairwise 虽然离线常常更好,但 100 负样本的训练开销让它没上线。工业读者要注意这个取舍——离线最优的那个变体未必是能部署的那个。
-
模型规模极小。≈0.01B 参数,与真实工业 GR 模型差几个数量级。前缀级约束的收益是否会随模型变大而被「模型本身就学会了」吃掉,是个开放问题——不过微信那个线上结果多少缓解了这个担忧。