Self-Evolving Recommendation System: End-To-End Autonomous Model Optimization With LLM Agents
Google / YouTube
YouTube 把推荐模型的迭代建模成一个「双层优化」问题——底层照常用 SGD 训模型权重 θ,上层用 LLM Agent 自动搜索元配置 Φ(优化器/架构/奖励函数)去最大化真实北极星指标。落地为「双环双 Agent」:Offline Agent(快内环,用便宜的离线 proxy loss 高频生成假设、Think-Code-Verify 闭环)+ Online Agent(慢外环,用延迟的线上 A/B 北极星指标在五阶段 DAG 状态机里安全验证)。三个专家 persona(Optimizer/Architecture 用 compute_loss,Reward 用 run_sql_query)当 MLE 工程师。最大价值是这是把「Agent 自动迭代推荐系统」真正铺到十亿级 YouTube 流量、且是 AgentX/NOVA 都引用的奠基工作——证明 LLM 能做结构级 + 语义级创新(自己合成出三组件复合奖励、发明 Gated Path 架构),实验吞吐从人工 Θ(1–10)/周提到 Θ(100)/周。
核心思路
一句话问题:工业推荐(YouTube 这种把推荐建模成 RL、最大化长期用户满意度的系统)最高杠杆的改进,不是调 learning rate 这类数值超参,而是结构级 + 语义级的改动——发明新架构层、设计复合奖励函数。作者点出三个非 Agent 不可的挑战:C1 结构设计的不可解(架构搜索空间近乎无限,离散设计选择如 Swish/GELU 激活、DCN/Transformer 交互层,标准 AutoML 没有推理能力去导航开放式设计空间);C2 奖励工程的语义鸿沟(reward 是 RL 推荐里最关键也最难的部分,要把 watch time / survey / retention 等异构信号聚合成逼近「长期满意度」的复合逻辑,这是梯度搜索做不了的推理任务);C3 人驱动迭代的规模上限(每个实验都要人把假设翻译成代码、配 trainer、搭 A/B、看结果,可探索假设数 ∝ 工程师数)。
关键 idea(范式):把推荐模型优化形式化成一个双层优化(bi-level optimization),并把上层交给 LLM Agent:
- 下层(模型训练):照常用 SGD 训练 ranking 模型权重 ,最小化可微 proxy loss:, 是训练日志, 是系统元配置。
- 上层(元配置发现):找最优 使训练出的模型在线指标最大:, 是真实北极星业务指标(延迟、噪声、稀疏), 是系统约束(如训练成本)。 的三类具体例子:Optimizer(,学习率与更新规则如 AdaGrad)、Architecture(,如 DCN 结构)、Reward Definition(,决定训练标签的逻辑)。
这就是「从自动调参(automated tuning)到自主科学发现(autonomous scientific discovery)」的范式转移——传统 AutoML/NAS 只能从预定义菜单里选,而 LLM Agent 能读生产代码、写新模块、重构逻辑。本文把 AI-Scientist / AlphaEvolve / MLE-STAR 那套「科学家 Agent」从学术 benchmark(Kaggle)搬到真实生产生态:噪声反馈环、严格安全护栏、复杂 user-system 交互、严谨 A/B 协议。
定位:这是 AgentX(快手)和 NOVA(腾讯)都引用的奠基工作(YouTube Self-Evolving RecSys)。三篇放一起读能看清「Agentic RecSys」这条线:本文奠定「双环双 Agent + 离线 proxy 漏斗 + 线上北极星验证」范式,AgentX 把它扩成全闭环 + SGPO 自进化,NOVA 则专精「架构级修改」并加 silent-failure 验证。
整体实现思路
系统围绕一个共享上下文(持久知识库 + Experiment Journal 历史试验记录及其指标)解耦成两个同步反馈环:
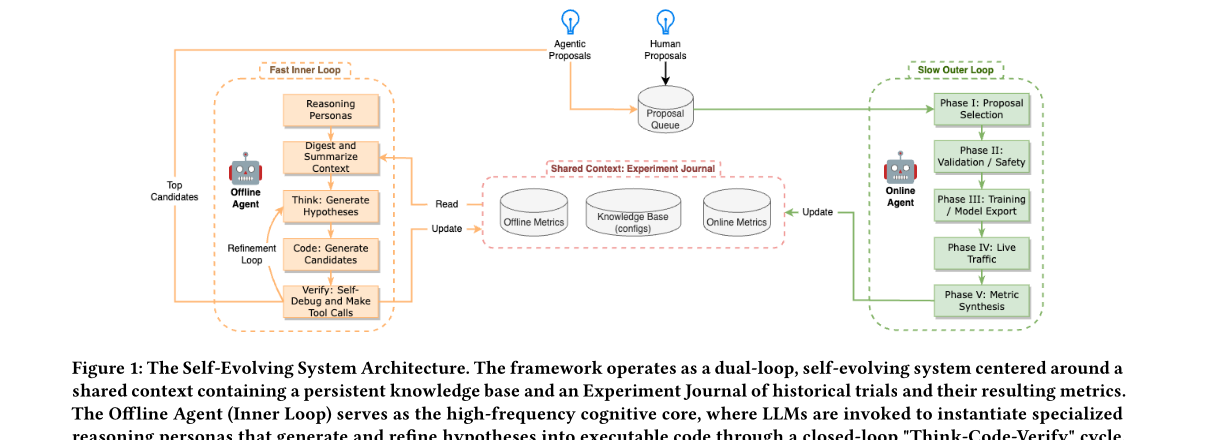
- 输入:基线模型配置 + schema(训练日志)+ Experiment Journal(历史 diff 及离线/在线结果)+ 可选的人类 steering 指令 + 安全护栏。
- Offline Agent(快内环,高频):遍历语义配置空间,用便宜的离线信号高吞吐生成候选、剪枝到最有潜力的一小撮。
- Online Agent(慢外环,低频):把幸存候选放到真实流量上,对延迟的北极星指标 做 A/B 验证。
- 输出:通过五阶段验证的安全模型变更上线,线上北极星指标序列化写回 Experiment Journal,闭环。
用双 Agent 而非单体 Agent 的理由:建立严格的过滤漏斗——昂贵的线上流量只留给已用便宜离线 proxy 证明过统计潜力的候选。
子模块实现(可复现细节)
模块 A — Offline Agent(快内环):Prompt 构造 + 专家 persona + Think-Code-Verify
Prompt 动态构造(模板见下方「附录」)含:① Persona Framing(告诉它是专家 MLE,并按任务给专精身份);② Primary Objectives(按关键指标提案,且明确要求「平衡 exploration / exploitation / innovation」以避免退化成只调小超参);③ Steering Instructions(人在环可选引导);④ Safety Guardrails(如「Metric#3 回退不得超过 +1%」防 reward hacking);⑤ Baseline Config + Schema;⑥ Experiment Journal(结构化历史 diff + 离线/在线结果,让 LLM 从过去失败学习)。
为什么要拆 persona:单一 persona 暴露在全代码库下会被无关 schema 污染、导致「context rot」与幻觉。三个专精 persona:
| Persona | 工具 | 目标 / 选择准则 | 关键细节 |
|---|---|---|---|
| Optimizer | compute_loss | 最小化 ;按 loss 排序 | 改优化器类(Adagrad/RMSprop)及 momentum/batch size;loss 函数不变所以 loss 可比;起异步训练 job |
| Architecture | compute_loss | 同上按 loss 排序 | 解析 Keras/TF 定义、提结构突变;不同于 NAS 选菜单,可写新代码(如自定义 Gating Path、子塔内插 layernorm) |
| Reward | run_sql_query | 不能用 compute_loss——改了 reward 等于改了优化目标本身,不同 reward 定义下的 不可比(“click-only” 天然比 “click+satisfaction” loss 低,因为后者更难学);改用大规模信号/相关性分析,确认新 reward 信号与期望用户行为(如 long dwell time)高相关 | 编辑决定 ground-truth 训练标签的逻辑;跑批量异步分析 query 验证语义质量 |
Think-Code-Verify 闭环(4 步):① Hypothesis Generation(先形成策略,如「模型对 clickbait 过拟合,在 reward 里惩罚短时长点击」)→ ② Code Implementation(把假设翻成精确 code/config diff)→ ③ Refinement by LLM(生成代码交给一个「linter」persona 批判性 review、修语法、对齐 schema)→ ④ Tool Calls(调 compute_loss / run_sql_query 量化候选质量)。只有通过内环的候选才升级到外环。
模块 B — Online Agent(慢外环):五阶段 DAG 状态机
每个提案 在一个有向无环图状态机里流转,保证只有完全验证的模型才影响真实流量:
- Phase I — PROPOSED(提案选择):作为 universal sink,把假设来源与执行解耦。队列接收异构来源——Agent 生成候选(Offline Agent 的 top 幸存者,按离线 loss 或信号相关性排序)+ 人类候选(人工 override / 基线配置)。默认 FIFO,但允许人工重排优先级。
- Phase II — VALIDATED(模型验证,gatekeeper):分配算力前做静态分析——Compilation Check(配置能否解析编译)+ Model Push Evaluation(对基线阈值评估,查数据量是否够学、做 pairwise eval 防漂移)。失败立即「Fast Fail」报错、不付训练成本。
- Phase III — TRAINING(训练 + 模型导出):轮询推理服务器监控模型可用性;状态跃迁严格要求权重成功导出、版本化、push。
- Phase IV — LIVE(最关键,实时实验 + 安全):Traffic Diversion(与实验服务器交互分配统计显著的流量片)+ Duration Management & Safety(维持特定时长以捕获延迟指标,期间持续监控;任一指标越阈值即 abort 实验保护体验)。
- Phase V — COMPLETED(指标合成 + 闭环):不是单纯终止——North Star Retrieval(查实验服务器取最终在线指标 如 watch time)+ Context Synchronization(指标与状态序列化写回 Experiment Journal)。这一步让「离线好但线上差」的负信号回流到 Offline Agent 的未来上下文,避免重蹈覆辙。
整个流程把人从实验关键路径移除:人类只需「提初始研究想法」+「最终 review 实验指标」两步。
实验设置与结果
底层生产模型:YouTube 视频观看页 ranking 的 RL fine-tuning 深度神经网络,训练耗时 Θ(hours)。两阶段评估对齐双 Agent:内环离线验证(证明 LLM 能找到最小化 loss / 高信号相关的候选)+ 外环在线 A/B(证明到达此阶段的候选显著提升北极星指标)。
主结果(Table 1,*=95% 显著):
| 任务 | 发现 | YouTube 级指标 | Surface 级指标 |
|---|---|---|---|
| Optimizer | 切换到 RMSprop | +0.06%* | +0.12%* |
| Optimizer | 训练效率 4× | −0.01% | +0.06% |
| Optimizer | 训练效率 2× | +0.01% | +0.09%* |
| Architecture | Gated Path (GLU) | +0.06%* | +0.14%* |
| Architecture | 激活函数精化 | −0.02% | +0.12%* |
| Reward | 多目标合成 | +0.03%* | +0.13%* |
关键发现:① 算法发现——Agent 自主把 legacy Adagrad 换成 RMSprop(带特定 lr/decay/momentum),离线 loss 显著降、线上双层指标显著升;② 系统效率——通过调 batch size / epoch / 优化器超参,训练延迟先 4× 后 2×、内环容量总共提升 8× 而不损业务指标;③ 结构发现——Architecture persona 探了数百个方案(attention→MoE),提出 Gated Path 架构(类 GLU,给 query embedding 加乘性门按上下文动态抑噪),后续又从 sigmoid 门进化到 GELU + layer norm;④ 语义发现——Reward persona 靠数据分析合成出三组件复合奖励(Active Engagement 活跃参与 + User-Channel Relationship 频道亲和 + Video Quality 视频质量),显著超人工基线——而人工 reward 工程常因找不到关键语义瓶颈而在次优区迭代数月。
实验速度(Table 2):
| 指标 | 人工 workflow | Agent workflow |
|---|---|---|
| 实验吞吐 | Θ(1)–Θ(10) / 周 | Θ(100) / 周 |
| 每实验工程成本 | Θ(1)–Θ(10) 小时/周 | 0 小时/周 |
消融(Figure 2,归一化 z-score loss,越负越好,6 次独立运行 × 各探 70 idea 取均值):
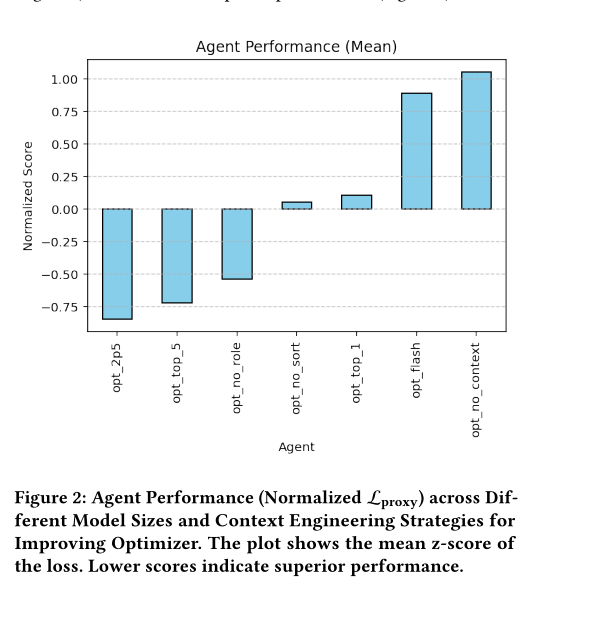
变体定义:opt_2p5(基线,Gemini 2.5 Pro + 专家 persona + 全历史按 loss 排序)、opt_flash(换 2.5 Flash)、opt_no_role(去专家 persona)、opt_no_sort(历史按时间戳而非 loss 排)、opt_top_1/top_5(只给 top1/5 历史)、opt_no_context(无历史)。结论:① 模型推理力——Gemini 2.5 Pro 一致优于 Flash,证明算法发现受益于更大参数 + 深度思考;② 专家 persona framing 显著影响提案相关性与深度;③ 上下文工程——完整且按 loss 排序的历史 > 无历史 > 受限 top-k > 无序历史(opt_no_context 和 opt_flash 最差,z-score 最高)。说明全面且排序的过去结果分布对有效迭代发现至关重要。
Lessons L1–L5:L1 delta vs 全配置(让 Agent 生成对生产文件的 delta 而非全量配置,否则会幻觉省略未改参数/语法错);L2 靠 prompt 强制多样性(不明示则 Agent 偏好安全增量改动、退化成微调超参,必须 prompt「平衡探索/利用/创新」逼它做大跳跃);L3 冷启动问题(Experiment Journal 空时只会提教科书式通用改进,warm start 后显著改善);L4 语义推理 > 数值调参(成熟系统最高杠杆来自结构/语义突变,如 Reward persona 重定义「成功的业务逻辑」,纯数值调参永远做不到);L5 跨 surface 泛化(把同一双 Agent 架构部到另一个特征 schema/数据/配置完全不同的 YouTube surface,几轮内就适配并提升北极星指标,证明它优化的是「发现的过程」而非记住某个数据集)。
思考与可参考价值
定位与三篇对照:本文是 AgentX(快手) 和 NOVA(腾讯) 共同引用的奠基范式。三篇的演进关系很清晰:本文确立「双环双 Agent + 离线 proxy 漏斗 + 线上北极星验证 + Experiment Journal 学习」的骨架;AgentX 把它扩成 brainstorm→开发→评估→SGPO 自进化的全闭环并量化提效;NOVA 收窄到「架构级修改」并补上 silent-failure 验证级联 + 架构梯度。读这三篇等于看「让 Agent 自动迭代推荐系统」从奠基→泛化→精专的完整脉络。
可直接借鉴(电商/搜推/Agent 方向):
- 双层优化 framing 是最值得内化的范式:把「模型训练(θ,照常 SGD)」和「元配置发现(Φ,交给 Agent)」显式分层,让 Agent 不碰梯度只碰「优化器/架构/奖励」这层离散语义决策——这个分层对任何想引入 Agent 自动化的推荐/搜索团队都是清晰的切入点。
- 「快内环便宜 proxy + 慢外环昂贵北极星」的漏斗:核心洞见是用便宜离线信号做高吞吐筛选、把昂贵线上流量留给已证明统计潜力的候选——这套「便宜信号当漏斗、贵信号当裁判」的成本结构可直接套到我们的生成式召回/Push 实验调度上。
- Reward persona 不能用 loss 排序、改用信号相关性——这是非常实用的细节:改了 reward 定义后 loss 不可比(更复杂的标签天然 loss 更高),必须换成「新信号是否与期望行为高相关」的离线验证。任何做多目标奖励/标签工程的人都该记住这条陷阱。
- Experiment Journal = 结构化失败记忆:把每次 diff + 离线/在线结果序列化回流,让 LLM 从过去失败学习;消融证明「全量按效果排序的历史」远胜「无序/截断/无历史」——这和 AgentX 的负结果资产化、NOVA 的 forbidden directions 是同一种「失败知识库」哲学,且本文用消融数字证明了它的价值。
- 工程化细节可直接抄:delta-based 生成(防幻觉省略未改参数)、prompt 强制 exploration/exploitation/innovation 配额(防退化成微调)、五阶段 DAG 里的 Fast-Fail(编译/push 检查在分配算力前做)、护栏写成「Metric#3 ≤ +1%」防 reward hacking。
局限与存疑:① 指标增益绝对值很小(YouTube 级多在 +0.06% 量级,虽统计显著但相对 AgentX/NOVA 报的 +0.5%~+2% 偏弱,且部分项不显著甚至为负如训练效率 4× 的 YouTube 级 −0.01%);② 几乎没有方法细节的定量对比——没有和人工基线在「相同预算下发现质量」的并排数字,Table 1 只列了 Agent 自己的发现;③ 报告偏「成功展示」——只讲成功上线的发现,失败率/silent-failure 率/被 abort 的实验比例完全没报(恰是 NOVA 重点量化的东西);④ Reward 的具体复合公式、Gated Path 的具体结构都用文字含糊带过(出于商业保密),可复现性低;⑤ proxy↔北极星对齐缺口仍靠人设护栏兜底,Agent 本身不保证不 reward hacking;⑥ 强依赖 Gemini 2.5 Pro 级推理力(Flash 明显变差),中小团队复刻成本高。