Ranking Engineer Agent (REA): Autonomous AI Accelerating Meta Ads Ranking Innovation
Meta (Ads Ranking × DevInfra)
把"推荐/广告排序模型的研发实验循环"本身交给一个长周期自治 Agent。REA 不是推荐模型,而是"会做实验的算法工程师 Agent"——自动生成假设(历史经验库 + ML 研究 Agent 双源)、规划三阶段实验(验证→组合→精炼)、异步跑训练(hibernate-and-wake 休眠唤醒,跨数天/数周)、读结果、自调试失败、把经验沉淀进中央 insight 库再迭代。人只在关键决策点审批。6 个模型上首次生产验证:平均精度翻倍、工程效率 5×。
核心思路
一句话问题:广告/推荐排序模型越成熟,“再榨出一点提升”越难,而传统 ML 实验循环——工程师提假设 → 设计实验 → 起训练 → 调失败 → 分析 → 再迭代——一轮要数天到数周,且高度串行、人盯人,成了创新的瓶颈。
关键 idea:把**“做实验这件事本身”自动化**。REA(Ranking Engineer Agent)不是一个新的排序模型,而是一个长周期自治的”算法工程师 Agent”:它替你生成假设、规划实验、异步跑训练、读结果、调失败、沉淀经验、再迭代;人类只在战略决策点(审批计划、确认算力预算、最终拍板)介入。这是推荐/广告系统里”Agent 替人做研发”的范式样本——区别于”Agent 替用户做推荐”(如本 topic 下的 Deep Research for Rec),这里是 Agent 替工程师优化推荐系统。
概念区分:REA 把人类从”实验机械操作”里解放出来去做”创造性与战略思考”——agent 处理迭代机械、人做战略决策与最终批准。
整体实现思路
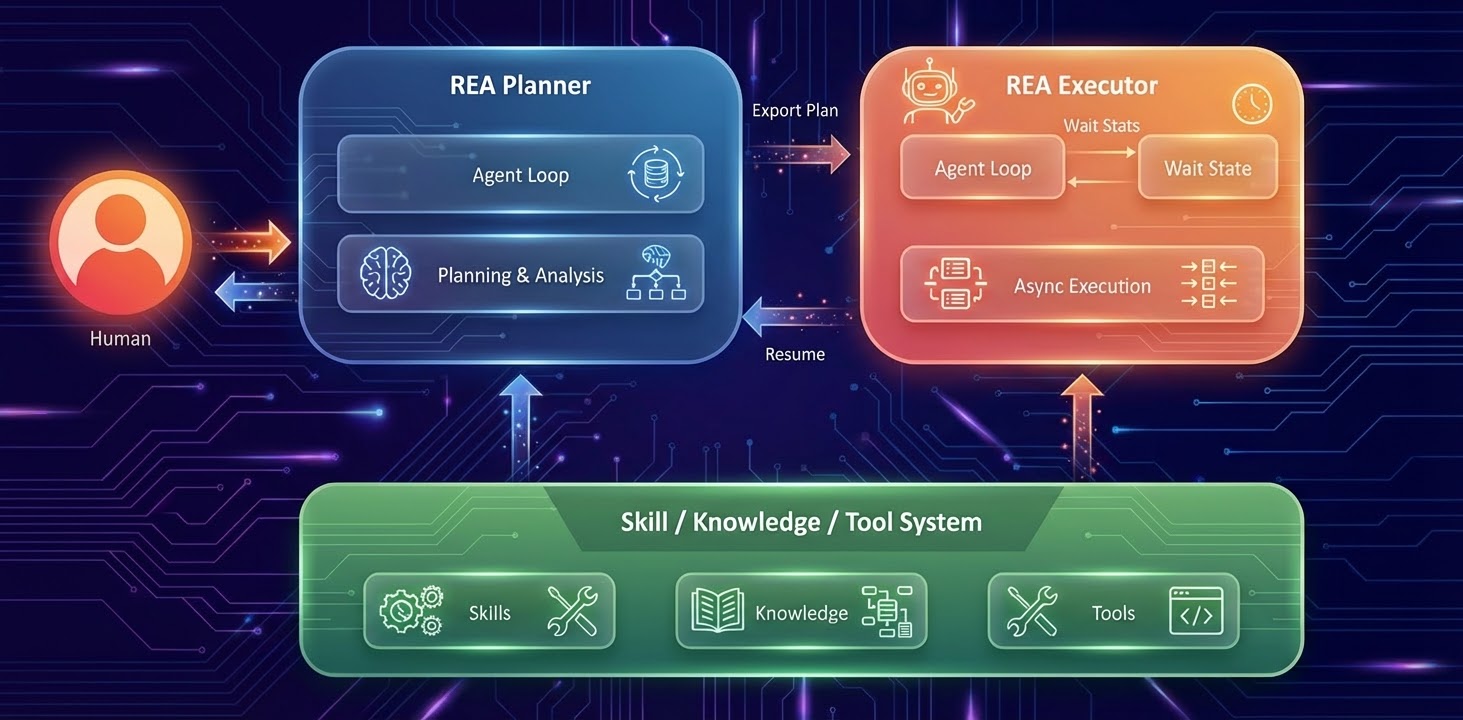
工程师(批准/预算) ⇄ REA Planner ──Export Plan──▶ REA Executor
                       │(假设生成+三阶段规划)        │(异步起训练→休眠→唤醒→读结果→调试)
                       ◀──────── Resume(回传结果驱动下一轮规划) ────────┘
                                          │
                       共享底座:Skill / Knowledge / Tool System
                       (ML 能力 + 历史实验库 + Meta 内部基建:调度器/实验追踪/代码导航)
端到端一轮:假设生成 → 提交计划(含 GPU 成本估算)给工程师审批 → 验证阶段并行跑多假设 → 实验 logger 把结果/指标/配置写入中央 insight 库 → 假设生成器据此提更精细的下一轮假设 → 失败则查 runbook 自处理 → 在预设 guardrail 内自适应推进。整套循环底层跑在 Meta 内部 Agent 框架 Confucius(面向复杂多步推理,强代码生成 + 接内部工具的 SDK)上,且只在 Meta 广告排序代码库内工作(工程师显式授权访问)。
子模块实现
模块 A — REA Planner(规划器)
- 职责:与假设生成器协作,产出详细实验计划;通过”预检清单(preflight checklist)“让工程师显式审批、并预先确认算力预算。
- 构成:Agent Loop + Planning & Analysis 两块(见架构图左)。
- 输出:一份可执行的探索策略(含每条假设、GPU 成本估算),Export 给 Executor。
模块 B — REA Executor(执行器)+ Hibernate-and-Wake
- 职责:通过”Agent Loop + Wait State”管理异步作业——起训练、监控、作业完成后恢复继续,而非全程盯着。
- 核心机制 Hibernate-and-Wake(休眠唤醒):REA 起一个训练作业后,把”等待”委托给后台系统、自身关停以省资源,作业完成时自动从断点唤醒续跑。这是它能跨”数小时~数天”训练、维持多周工作流而无需人盯的关键——解决了”会话绑定的助手撑不过长任务”这一根本矛盾。
模块 C — 双源假设引擎(Dual-Source Hypothesis Engine)
“实验质量上限取决于假设质量”,所以 REA 同时咨询两个系统,再综合出单一来源不会想到的配置:
- 历史洞察库(Historical Insights Database):策展过的过往实验成败仓库,支撑 in-context learning + 模式识别。
- ML 研究 Agent(ML Research Agent):一个 deep-research 组件,调研 baseline 模型配置、结合历史库提出新颖优化策略(前沿 ML 研究 → 落到本任务)。
模块 D — 三阶段规划框架(Three-Phase Planning)
在批准的算力预算内,按”先验证、再组合、后精炼”推进:
- Validation 验证阶段:把来自不同来源的单条假设并行测试,建立质量基线。
- Combination 组合阶段:把有潜力的假设组合,搜协同增益。
- Exploitation 精炼阶段:对最有希望的候选在预算内激进深挖。
模块 E — 失败处理与自适应执行(Resilience)
- 遇到失败先查 runbook(常见失败模式手册),做优先级决策(如排除明确 OOM、或 loss 爆炸等训练不稳信号的作业),并从第一性原理调试初步的基建故障。
- 在预设 guardrail 内自调计划,而不是停下来等人——基建故障/意外错误/次优结果都不升级为人工事件。
模块 F — 持久记忆 / 经验沉淀(Knowledge Accumulation)
Executor 每完成实验,专门的 experiment logger 把结果、关键指标、配置写入中央”假设实验洞察库”;这份持久记忆跨 Agent 全生命周期累积知识——假设生成器据此识别模式、提越来越精细的配置,所以”REA 每迭代一轮就更强”。
结果与治理
生产结果(首次验证,6 个模型):
| 维度 | 结果 |
|---|---|
| 模型精度 | REA 驱动的迭代把平均模型精度较 baseline 翻倍(2×) |
| 工程效率 | 过去”每个模型 2 名工程师” → 现在”3 名工程师覆盖 8 个模型”;早期采用者同样时间内把”模型改进提案”从 1 个提到 5 个(5×) |
| 速度 | 过去需多名工程师数周的复杂架构改进,现可由更小团队在数天内完成 |
安全与治理(Safeguards):
- 工程师经预检清单显式授权访问;预先确认算力预算,到阈值即暂停/停止。
- 预设 guardrail 内自治;关键战略点保留人工监督;结构化失败处理避免例行基建问题升级。
- 隐私、安全、治理被列为持续优先项;REA 仅限广告排序代码库。
相关系统:内部框架 Confucius(arXiv:2512.10398);同门 Agent 系统 KernelEvolve、Zoomer;相关模型 Meta GEM(生成式广告模型)、Andromeda。
思考与可参考价值
定位:这是一篇工程博客(非论文),偏”系统范式 + 生产结果”,缺可复现细节(没有 Confucius 的内部实现、假设生成 prompt、insight 库 schema、训练超参、消融)。读它是为了拿”自治研发 Agent”的架构骨架与工程取舍,不是为了复现数字。
局限(清醒看):
- 结果口径偏软:「平均精度翻倍」「效率 5×」没给绝对指标、对照设计、统计显著性,且”6 个模型首次验证”样本小;blog 性质决定无法证伪。
- 强绑 Meta 内部基建(Confucius / 调度器 / 实验追踪 / 历史库),外部不可复现,迁移成本高。
- 本质是”自动化 AutoML/实验编排 + LLM 假设生成”,单点技术新颖性有限;价值在端到端自治闭环 + 长周期工程化(hibernate-and-wake、guardrail、经验沉淀)。
- 人仍在关键环(审批/预算/拍板),并非全自治;假设质量与”历史库 + 研究 Agent”强相关,冷启动/新架构外推能力未知。
对电商 / 搜推 / Agent 方向可直接借鉴:
- “Agent 优化推荐系统”是与”Agent 做推荐”并列的另一条主线——把排序调参/特征/架构搜索的实验循环交给 Agent,人只审批。和本站 Sortify(自治 LLM 闭环排序调参)思路同源,REA 把它做到了”假设生成→多阶段实验→经验沉淀”的更完整研发链路。
- Hibernate-and-Wake 是任何”要等数小时训练/离线作业”的长周期 Agent 的关键工程模式(委托等待 + 断点续跑),直接可抄到自研实验 Agent。
- 双源假设引擎(历史经验库 + deep-research Agent) 比单源更能产出新颖配置——做自动调参/AutoML 时,“经验回放 + 前沿检索”双通道值得复用。
- 三阶段(验证→组合→精炼) + 预算 guardrail 是把”无界搜索”约束成”可控、可审批、不超预算”的实用编排骨架。
- 经验沉淀进中央 insight 库让 Agent 越跑越强——与 Sortify 的 Memory DB 一致,是自治优化系统的标配。