NOVA: A Verification-Aware Agent Harness for Architecture Evolution in Industrial Recommender Systems
Tencent Inc. (腾讯)
让 Agent 自动「改推荐模型的架构」——不是调超参,而是做跨模块的结构修改(升级 attention、改 logit fusion、移植论文模块)。核心 idea 有两个:① 把架构演进建模成一次「类 SGD 的搜索」,用一个非可微的「架构梯度」(architecture gradient) 聚合上一次修改、验证诊断、指标变化、轨迹记忆来指示下一步往哪改;② 针对「能跑但语义错」的 silent failure,在昂贵训练前用多级验证级联(语义→可执行→离线 AUC→线上)拦截,并把失败模式记成 forbidden directions 反哺梯度——验证不只是过滤器,而是搜索信号本身。L1–L4 任务分级 + AutoRun/Copilot 把高风险任务路由给人。腾讯广告线上实测:L3 论文落地任务 EPR 60%(人类专家 2×+),单次论文落地周期人工耗时缩短 13×,线上 GMV +1.25%/+1.70%/+2.02%、pCVR bias 降 58.8%/66.7%/37.3%。
核心思路
一句话问题:工业推荐模型的提升越来越靠架构演进(RankMixer / TokenMixer-Large / MixFormer 这类更强 backbone 与交互机制),但「改架构」这件事极度依赖专家、难以规模化。已有自动化都不够用:AutoML 只调超参(learning rate / hidden size / embedding dim / layer depth),而真正有效的提升往往需要跨模块的拓扑改动(把 target attention 升级成 Seq-Token + Non-Seq-Token 联合建模、重设计 logit-fusion 路径、把标准残差换成 AttentionRes);通用 LLM coding agent 只优化「代码能跑」,但「能跑」不等于「是个合法的推荐架构」——它可能悄悄删了 sequence mask、把 self-attention 退化成 MLP、改了 logit 融合路径,代码不报错却让 AUC/校准/业务指标变差。作者把这类**「能跑但架构语义错」的候选称为 silent failure(静默失败)**。
关键 idea(两个机制):
- 架构梯度(Architecture Gradient)——把架构演进组织成一次反馈驱动的搜索,类比 SGD 但非可微:用一个结构化更新信号 聚合「上一次修改 + 验证诊断 + 指标变化 + 轨迹记忆」来指示下一步往哪个方向改。
- Silent-failure-aware 验证级联——在昂贵训练之前先查架构语义,把失败诊断反哺成可复用的 forbidden directions。于是验证不只是事后过滤器(post-hoc filter),而是搜索信号本身:一次拒绝不仅干掉当前非法候选,还塑造后续搜索、劝退相似失败模式。
和近邻工作的区别:YouTube 的 Self-Evolving RecSys、AgenticRecTune、Meta 的 Ranking Engineer Agent(REA) 都已证明 Agent 能参与生产模型优化;NOVA 的差异点是聚焦可审计的架构级修改(模型结构 / 特征配置 / 交互模块),且把「训练前的架构语义验证」当成核心并将其诊断喂回架构梯度当 forbidden direction。相对 ProTeGi / TextGrad 的「文本梯度」,NOVA 的架构梯度不是一句独立的文本建议,而是面向「选下一个可行修改」的结构化信号。
整体实现思路
端到端是一个level-aware 闭环 harness:顶层固定任务级别(L1–L4)与执行模式(AutoRun/Copilot),中层跑 7 阶段工作流,底层记录验证诊断与指标反馈、折叠成下一轮的架构梯度。
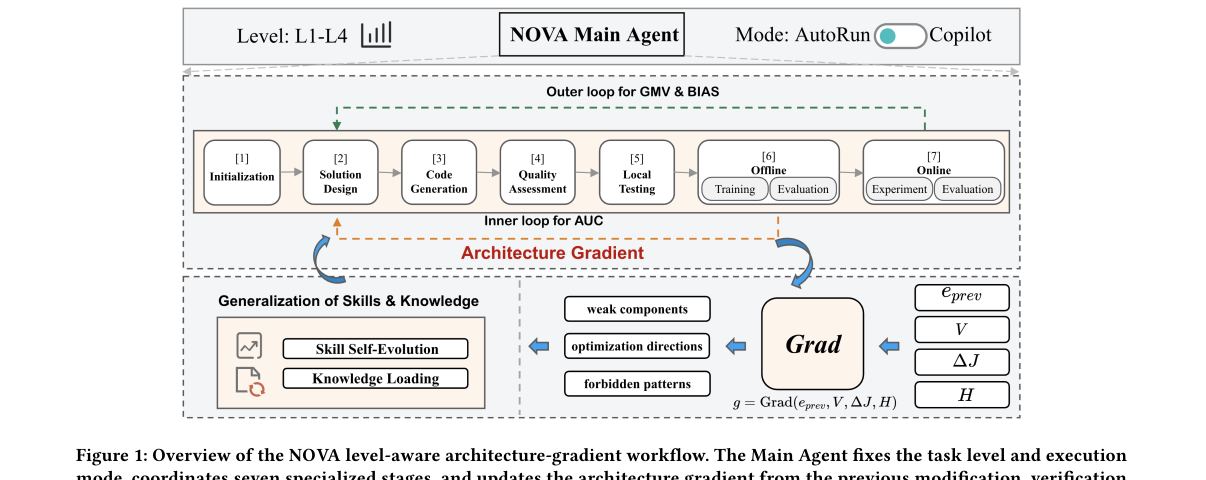
- 输入:现有生产模型代码库 (解析出初始架构 + 可行修改边界)、论文源 (抽架构先验 → 可落地修改方向)、静态知识库 (历史上有效/无效方向的证据)。
- 过程:7 阶段有向工作流
Initialization → Solution Design → Code Generation → Quality Assessment → Local Testing → Offline Training & Evaluation → Online Experiment & Evaluation;inner loop 用离线 AUC 选候选,outer loop 用线上 GMV/Bias 验证。 - 输出:预算 内离线 AUC 最优的可行架构 ,再上线 A/B 验证。
子模块实现(可复现细节)
模块 A — 问题形式化:架构状态 + 可行域
每个候选架构表示为 : 模型图、 结构超参、 特征配置(把特征也纳入架构状态,因为工业提升常需特征-结构协同改动)。每轮施加一个修改 : 候选可行当且仅当满足硬生产约束 ,其中 含:接口兼容、张量 shape 一致、dtype 一致、特征可用性、训练框架兼容、serving 兼容、延迟上限、参数/FLOPs 预算。修改类型见下表(搜索单元 = 结构超参 / 特征增删 / 序列建模升级 / 模块算子替换 / 架构迁移):
| 修改类型 | 典型修改 |
|---|---|
| 结构超参 | 调 token dim、token count、层数及其组合 |
| 特征增删 | 加新特征 / 删冗余或有偏特征 / 调特征分组 |
| 序列建模升级 | target attention → seq/non-seq token 交互或 MixFormer 式交互 |
| 模块/算子替换 | 残差换 AttentionRes;注入 mixer / cross-attention block |
| 架构迁移 | 把 TokenMixer-Large / MixFormer 等论文模块适配到生产模型 |
目标:离线 inner loop 用 AUC 排序 ;线上用加权业务指标 (Bias 这类越低越好的指标赋负权重)。
模块 B — 架构梯度(核心,类 SGD 但非可微)
因 离散且受约束,对 的标准梯度不可用。NOVA 用架构梯度当结构化更新信号。SGD ↔ NOVA 的类比(仅类比,无真实数学梯度):
| 标准 SGD | NOVA 架构修改 |
|---|---|
| 优化变量 | 架构状态 |
| 可行域 | 生产约束架构空间 |
| 目标反馈 | 离线评估 + 线上验证的指标变化 |
| 更新方向 | 架构梯度 |
| 更新操作 | |
| 动量/历史 | 轨迹记忆 (成功+失败修改) |
| 噪声抑制 | 语义验证 + forbidden directions |
| 停止准则 | 离线提升阈值 或 预算耗尽 |
第 轮:,其中 上次修改、 验证诊断、 离线目标变化、 历史轨迹(修改/失败/诊断/指标反馈)。架构梯度给出三类更新信息:① weak components( 哪部分是当前瓶颈);② modification directions(下一步该探哪些方向);③ forbidden directions(哪些已失败/语义非法/反复为负的模式要避开)。然后选下一个可行修改:
**搜索算法(Algorithm 1)**每轮:Propose(A_t,g_t,H) 沿梯度生成 ≤K 个候选 → FilterByConstraints(静态查合法性/框架可用/硬约束/forbidden 命中,不构建模型)→ 验证级联 → 若 survivors 为空则用 负哨兵更新梯度并继续 → Select 选最优 → (Copilot 模式需 HumanConfirm) → OfflineTrain 得 AUC、算 → 写回 、构造下一梯度 。停止:离线 AUC 提升阈值触发早停,否则跑满预算 。
模块 C — Silent-failure-aware 多级验证级联
silent failure = 通过显式工程检查、能跑/能训,但拿不到预期离线/线上提升的修改。两个来源:训练前可检的架构语义错,和结构合法但对业务无效的修改。级联(前轻后重,早拦截):
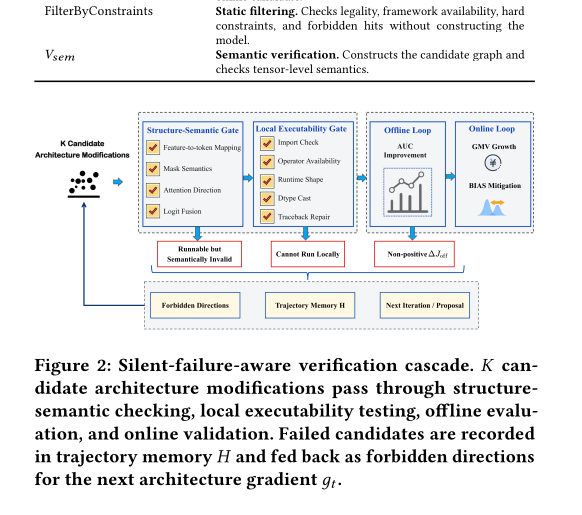
- 结构语义门(Structure-Semantic Gate):查修改逻辑、shape/dtype、feature-to-token 映射、attention 方向、mask 语义、logit fusion。抓「能跑但结构错」的候选(训练框架能执行一个 mask/分支连接/特征融合路径,只要 shape 兼容;但它判断不了 mask 方向/特征路由/融合逻辑是否符合意图)。这是 NOVA 区别于通用 coding agent 的关键——编译和本地测试只证明「图能跑」,不证明「架构修改语义合法」。
- 本地可执行门(Local Testing Gate):查单机可执行性(import check / operator availability / runtime shape / dtype cast / traceback repair),训练前拦工程失败。
- 离线 inner loop:对通过的少量候选用 AUC 评估。
- 线上 outer loop:用 GMV/Bias 做生产验证。
验证即梯度去噪:候选被拒时其失败模式存入 、后续轮作 forbidden direction——通过在训练前屏蔽 false-positive 方向、减少重复语义失败来给搜索去噪。语义门由 skill specifications 驱动(历史种子规则 + 累积 forbidden patterns + LLM 辅助检查),对未覆盖情形不过度自信拒绝、留给离线/线上评估;机制跨任务固定,但一个任务里改进的 skill spec 可被后续相似架构/失败模式的任务复用。语义门不判断「合法修改是否对业务有效」——那交给离线/线上评估。
模块 D — L1–L4 分级 + AutoRun/Copilot + 异常处理
level 控制修改范围,mode 控制是否要人确认(mode 由 skill-spec 覆盖度而非 level 决定:覆盖→AutoRun,未覆盖/高风险→Copilot):
| Level | 任务类型 | 典型任务 | Mode |
|---|---|---|---|
| L1 | 原子结构调参 | 调单个架构变量(RankMixer 层数 / token dim) | AutoRun |
| L2 | 约束感知 ScaleUp | 联合放缩耦合变量(token count/dim/层数)在参数/FLOPs 预算内 | AutoRun |
| L3 | 论文→生产迁移 | 把 TokenMixer-Large/AttentionRes/MixFormer/OneTrans 等模块适配到生产模型 | AutoRun 或 Copilot |
| L4 | 开放式创新 | 从趋势/业务/历史证据提新结构 | Copilot |
三类失败分治:① 临时执行失败(来自环境非候选)→ 有界重试,不污染架构梯度;② 候选级失败(结构语义违规 / 可训但离线为负)→ 记入 作 forbidden/low-value 方向、回到 Solution Design;③ 规则未覆盖/高风险失败 → 路由 Copilot,避免越界自主外推。系统实现为 Main Agent 编排子 agent(Initialization→Solution Design→Code Generation→Quality Assessment→Local Testing→Offline→Online),下游 agent 可消费多个上游阶段输出(如 Code Generation 用 Solution Design 的结构假设 + Initialization 的生产上下文)。
实验设置与结果
任务:L2 ScaleUp(生产 RankMixer backbone,搜 token_cnt/token_dim/RankMixer 层数等结构耦合超参,总模型大小 ±10% 内;注意 token_cnt 必须能被 token_dim 整除);L3 Literature-to-Production(把 TokenMixer-Large 移植进同一 backbone,保特征 pipeline/shape/训练稳定/推理兼容)。数据:腾讯生产广告流量,训练语料跨 1 个月、十亿级 user-item 交互、每条 >1000 特征字段;每个候选从零训练。预算:所有 LLM 方法同用 Claude Sonnet 4.6(差异来自 harness 设计而非底模),每方法跑 个独立任务、每任务 ≤ 轮、每轮 ≤K 候选。
指标定义:ΔAUC>0.001 算 AUC-positive;LPR=(本地通过率);SFR=(runnable-but-negative 率,=本地通过且 AUC-positive 数);EPR==LPR·(1−SFR)(端到端有效通过率,核心指标)。
主结果(RQ1,Table 5):
| 方法 | L2 LPR↑ | L2 SFR↓ | L2 EPR↑ | L3 LPR↑ | L3 SFR↓ | L3 EPR↑ |
|---|---|---|---|---|---|---|
| Human Expert Loop | 95.5% | 48.4% | 49.3% | 40.0% | 22.2% | 31.1% |
| OpenHands | 33.3% | 80.0% | 6.7% | 27.3% | 62.5% | 10.2% |
| ReActAgent-only | 37.5% | 66.7% | 12.5% | 25.0% | 71.4% | 7.1% |
| Optuna-TPE | 17.2% | 72.7% | 4.7% | – | – | – |
| NOVA | 99.0% | 45.5% | 54.5% | 86.7% | 30.8% | 60.0% |
L3 上 NOVA EPR 60.0% 是人类专家(31.1%)的近 2×、远超 coding agent(OpenHands 10.2% / ReAct 7.1%)。
消融(RQ2,Table 6,L3 上逐个移除组件):
| 变体 | LPR↑ | SFR↓ | EPR↑ |
|---|---|---|---|
| NOVA (full) | 86.7% | 30.8% | 60.0% |
| w/o Paper Reproduction | 91.7% | 63.6% | 33.3% |
| w/o Solution Design | 81.8% | 77.8% | 18.2%(最差) |
| w/o Multi-Candidate Gen | 66.7% | 61.1% | 25.9% |
| w/o Quality Assessment | 71.9% | 69.6% | 21.9% |
| w/o Architecture-Gradient Feedback | 87.5% | 57.1% | 37.5% |
关键观察:LPR 高 ≠ EPR 高——去掉 Paper Reproduction 后 LPR 反升到 91.7%(代码更容易跑通)但 SFR 飙到 63.6%、EPR 跌到 33.3%(能跑但无效);Solution Design 是 paper→production 的关键桥(去掉 EPR 仅 18.2%);去掉架构梯度反馈 LPR 仍高(87.5%)但 SFR 57.1%——证明 NOVA 的增益来自把失败转成搜索知识而非只看最终指标。
生产代码案例(RQ3):Case 1 把 TokenMixer-Large 适配进 RankMixer backbone,论文原版用 4 个 block + inter-residual + auxiliary loss,NOVA 找到2-block 轻量变体、约 43% dense 参数达到可比离线效果(缩 block 数、窄 FFN 扩展比、加一条 norm+FFN+residual)——说明 NOVA 做的是架构适配而非论文复现。Case 2 展示架构梯度纠错:通过「transfer→去 aux loss→小权重重引入+task1 专属信号→修正 aux-loss 读错的 target 表示并 mask task3」多轮试错,靠历史诊断避免重复错误、收敛到生产兼容设计。
线上 A/B(RQ4,Table 7,生产 pCVR 模型 5% 流量 request-level 随机):
| 目标 | GMV | pCVR bias |
|---|---|---|
| task1 | +1.25% | −58.8% |
| task2 | +1.70% | −66.7% |
| task3 | +2.02% | −37.3% |
GMV 显著正向且校准更好(bias 下降)。此外单次 literature-to-production 周期人工耗时缩短 13×+。
思考与可参考价值
定位:和 AgentX(快手,同 topic)一脉——都是「让 Agent 自动迭代推荐系统」的工业落地,但 NOVA 更窄更深:专攻「架构级修改」这一最难自动化、最依赖专家的环节,而 AgentX 覆盖从 brainstorm 到上线的全闭环。两篇放一起读能看清「Agentic RecSys」这条线的分工。
可直接借鉴(电商/搜推/Agent 方向):
- 「能跑 ≠ 对」是核心洞见,silent failure 这个概念值得内化:任何让 LLM 改推荐/搜索模型代码的场景,都该在昂贵训练前加一道领域语义门(查 mask 方向、特征路由、logit/score 融合、shape/dtype),而不是只信编译+单测。消融数据很有说服力——去掉结构化理解后 LPR 升但 EPR 崩,正是「优化了能跑、却放任了无效」的真实写照。
- 「验证即搜索信号」而非事后过滤器:把失败诊断记成 forbidden directions 反哺下一步决策,是比「单纯重试」更高级的范式——它让系统越踩坑越聪明。这和 AgentX 的「负结果资产化 / 可证伪归因」是同一种工程哲学,可合并成一套「失败知识库 + 前置门控」的通用设计。
- 架构梯度 = 把无梯度的离散结构搜索包装成类 SGD 的可迭代框架:对我们做生成式召回/排序结构探索有启发——用「上次改动+诊断+指标+历史」聚合出结构化的「下一步往哪改」,比纯 LLM 自由发挥更可控、可审计。
- L1–L4 + AutoRun/Copilot 的分级路由是务实的「人在环」设计:低风险全自动、高风险/未覆盖交人确认,且 mode 由 skill-spec 覆盖度而非 level 决定——这个「按能力边界而非任务难度路由」的判据可直接抄。
- 指标设计可借:把 EPR=LPR·(1−SFR) 拆成「能跑率 × (1−无效率)」,比单看通过率更能暴露「虚假成功」,做任何 code-agent 评测都该这么拆。
局限与存疑:① 单公司、单广告 pCVR 场景,且只测了 L2/L3(L1 太简单、L4 开放式创新没实测,而 L4 恰是「自动架构创新」最有想象力也最难的部分);② baseline 偏弱——coding agent(OpenHands/ReAct)EPR 个位数,主要赢在「它们根本不懂推荐语义」,但没有和同类 agentic-RecSys(REA / AgenticRecTune / YouTube Self-Evolving)的直接数字对比;③ 「架构梯度」本质是结构化 prompt + 启发式 Score 函数,论文未给 Score 的具体形式与权重,可复现性打折;④ skill specifications 仍largely 手工维护(论文自己把「self-evolving skills」列为 future work),所谓自进化尚未闭环;⑤ 线上只验证了 1 个离线最优候选、5% 流量,样本量小;⑥ Case 2 的多轮纠错读起来更像「人类专家经验被编码进 prompt」,架构梯度到底贡献多少自主性难以剥离。