Let the Agent Steer: Closed-Loop Ranking Optimization via Influence Exchange
Shopee
把电商排序调参重构为持续的「影响力交换」,交给一个全自治的 LLM 智能体闭环优化。关键不是让 LLM 直接调那 7 个排序权重,而是让它当「二阶元控制器」:站在更高一层校准「线下指标↔线上效果」的迁移映射(Belief 通道)和约束惩罚强度(Preference 通道)——两者按 Savage 主观期望效用公理正交解耦(信念 vs 偏好),底层用 Optuna TPE 搜参,Memory DB 跨轮沉淀经验,4 小时一轮全程无人。整个项目(9.8 万行代码+30 轮实验+本报告)号称由一人指挥 AI agent 群完成,是「AI 造 AI」的范式样本。
核心思路
一句话问题:工业排序公式是一堆可调权重的加权和,标准调参链路「线下搜参 → 线上 A/B → 人工拍板」有三个结构性顽疾——① 线下↔线上迁移漂移(Country A 实测线下 I_gmv +18.2% 却换来线上 GMV −3.6%);② 诊断信号纠缠(掉点时分不清是「映射预测错了」还是「约束设松了」,二者要相反修正);③ 经验不沉淀(每轮从零开始的「土拨鼠日」)。
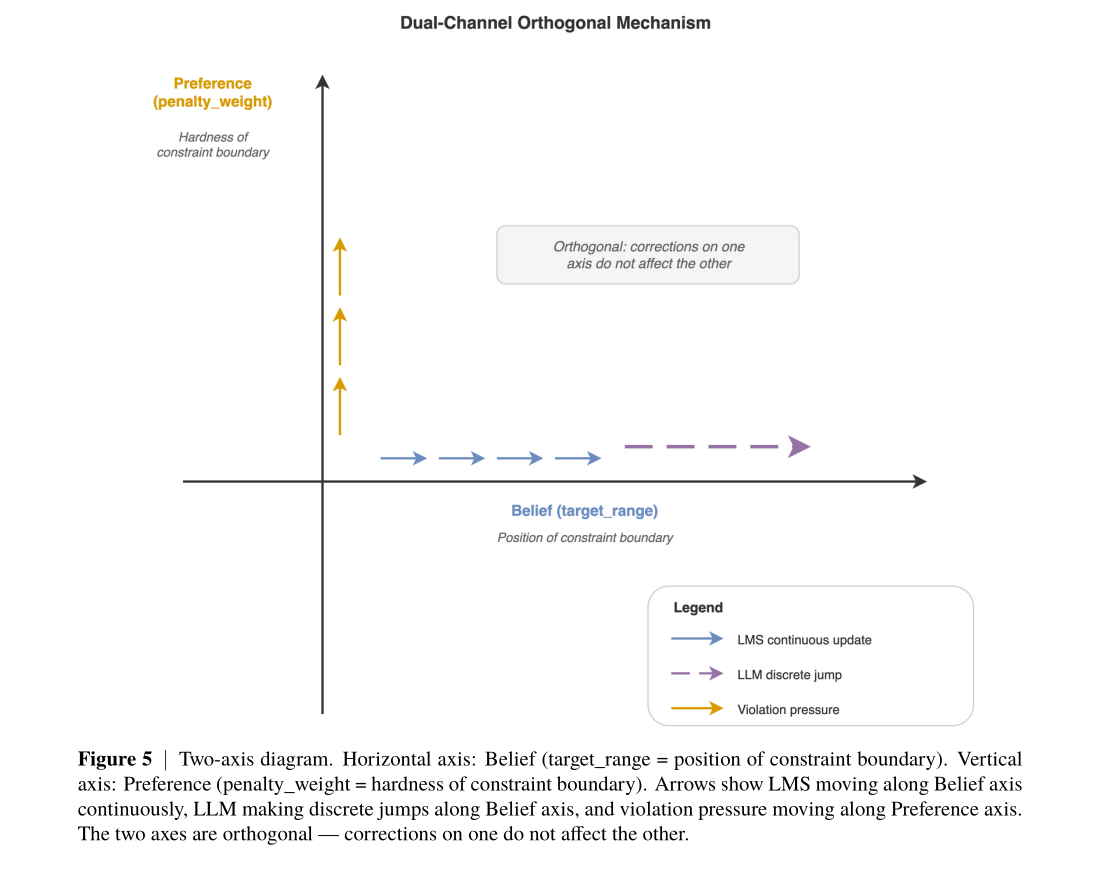
关键 idea / 范式:把排序优化重新定义为业务因子(自然相关性 / 广告出价 / 价格力)之间抢「影响力份额」的影响力交换(Influence Exchange)问题,并主张上述三痛点必须在架构层而非调参层解决。落地为一个全自治 LLM 闭环系统 Sortify,核心是把决策按 L.J. Savage 主观期望效用(SEU)公理正交解耦成两个通道:
- Belief 通道(求真):对应 SEU 里的「信念/概率」——「线下指标如何映射到线上现实?」只管客观规律,修正认知误差(epistemic error,“我预测会发生但没发生”)。
- Preference 通道(求值):对应 SEU 里的「效用」——「约束被违反时有多痛?」只管损失边界,修正价值误差(axiological error,“发生了,但我没料到这么痛”)。
LLM 不直接动那 7 维底层排序参数 θ,而是当二阶元控制器(second-order observer):只调框架级元参数(迁移函数截距 β、惩罚乘子 m),读 20 轮历史做证据驱动反思。底层由 Optuna TPE 搜参,7 表 SQLite Memory DB 跨轮沉淀状态,4 小时一轮(3.5h 攒数据 + 25–50min 处理)全程无人。
整体实现思路
端到端是一个三层闭环,外层人类设目标、中层 LLM+算法做双通道校准、内层 Optuna 搜参,再经 Redis 推到线上、A/B 回流入 Memory DB,形成 4 小时一圈的 YOLO(You Only Live Once)持续循环。
- Layer 1(外层 — 人类/配置):定义优化目标(如 max I_gmv)、约束边界(如 I_order 退化 ≤ 5%)、初始参数范围、惩罚权重种子。每个市场设一次,极少改。
- Layer 2(中层 — LLM + 算法):双通道校准。Belief 通道用 LMS 回归 + LLM 离散截距跳变校准线下→线上迁移;Preference 通道用乘法更新调约束惩罚权重;LLM 元控制器读累积 episode 历史编排两通道。
- Layer 3(内层 — Optuna TPE 搜索):在 Layer 2 给出的校准目标范围与惩罚权重下,跑 5000 trials × 25 workers 搜 7 维参数。
一轮 10 步 One-Shot Pipeline(restart-safe,持久化写幂等):Step1 拉 A/B 报告 → Step2 初始化/校验 Memory DB → Step3 写线下指标(status=offline_recorded) → Step4 写线上 uplift(status=online_recorded) → Step5 LMS 校准(更 6 条 prior_relations 的 slope/intercept) → Step6 导出 LLM context JSON → Step7 调 LLM 生成 proposal → Step8 应用 LLM 提议(改截距 + 惩罚权重;若 Belief 更新超阈值则本轮冻结 Preference) → Step9 由更新后迁移模型推 target_range → Step10 算违反压力推 penalty_weight → Final 跑 Optuna 搜索、发 Redis、写交接 state 文件。
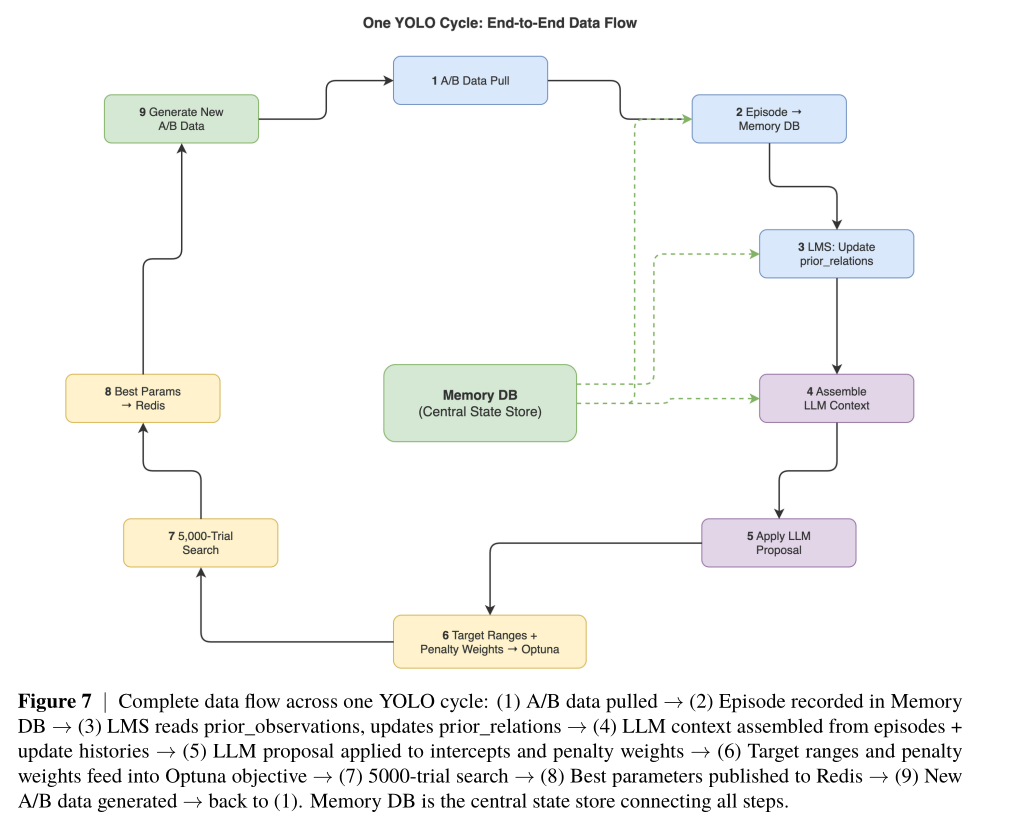
YOLO 模式三阶段:Coldstart(首启 bootstrap 参数、锚定 15 分钟对齐的观测窗、跳过 LLM 诊断直接默认先验搜) → Initial(第一轮完整 pipeline,可选人工确认,建立 baseline episode) → YOLO(无限循环:等 3.5h 攒数据 → 拉 A/B → 跑完整 pipeline → 更 yolo-state.env + 追加 yolo-event-log.md → 回到等待)。失败处理:A/B 拉取失败(瞬时)重试 5 次 × 5min;非 A/B 失败(搜索崩/Redis/DB 损坏)立即退出人工介入。崩溃后读 yolo-state.env 恢复。
子模块实现(可复现细节)
1. Influence Share + 参数搜索引擎
动机:替代不可分解的 Kendall τ。Kendall τ 是单标量,无法归因到单因子(答不出”排序里 GMV 占比 vs 订单数占比”),也无 sum-to-one 约束(无法表达”把 5% 影响力从订单转给 GMV”)。
定义(从对称群推导):请求 q 召回 n_q 个商品,参数 θ 下排序是对称群 S_{n_q} 里的置换 π_q(θ)。S_{n_q} 由相邻对换 s_k=(k,k+1) 生成,任何排序差异可分解为一串成对交换。把分数向量视为 R^{n_q} 中的点,比较超平面 H_{ij}={x: x_i=x_j} 把空间切成”房间”(chamber),每个房间 = 一个唯一排序;点穿墙 = 一对商品交换名次。控制排序变化的局部坐标是成对间隔 Δ_q(i,j;θ)=S_q(i;θ)−S_q(j;θ),且总分按因子可加分解:
成对影响份额(L1 归一化绝对因子间隔,满足局部性/符号不变/非负/单位划分/共同正缩放不变 5 条公理):
显然 Σ_f s_{q,f}=1;符号表示因子把哪个商品推前、|Δ| 表示推得多猛。位置敏感权重 w_{q,ij}=exp(−min(r_{qi},r_{qj})/τ)(τ 控衰减,头部位置权重大)。聚合 Influence Share:
P_q 可取全部信息对或限定 Top-(K+L) 区域。构造保证 Σ_f I_f(θ)=1,这就是”交换”推理的基础:I_gmv 涨 5pp 必然其他因子合计降 5pp。
多目标搜索目标(最大化主指标 I_gmv 提升、二次惩罚约束违反):
θ=(ps_ads_wo, ps_ads_wg, ps_org_wo, ps_org_wg, ps_porg_w, ps_price_pow, ps_w2) 是 7 维参数向量;v_j 是第 j 个约束的违反量(违反为正);λ_j 初始化在 15,000–30,000。二次惩罚是刻意设计:1% 违反惩罚 λ×0.01²、10% 违反 λ×0.10²——差 100 倍,容忍轻微擦边、严惩大违反。约束含 I_order 退化、I_ecpm_term 退化、ads top-10 曝光率、I_gmv_ads。
搜索引擎:Optuna TPE 采样器,每轮 5000 trials × 25 workers(Constant Liar 策略:未完成 trial 假设返回悲观值,防冗余探索),单轮 15–30 分钟。实测能找到相对 baseline I_gmv 提升 +4.9%~+41.6% 的配置。
2. Belief 通道:线下-线上迁移校准
线性迁移模型(对每个指标对,如 I_gmv→GMV、I_order→Orders 共 6 条关系):
α(斜率)= 迁移率,β(截距)= 系统性偏差。
LMS 连续校准(慢速、平滑,学习率 η=0.2),预测误差 e_t=u_{online,t}−û_{online,t}:
η=0.2 每轮只修正 20% 残差,从任意初始偏差到 95% 收敛约需 ⌈log0.05/log0.8⌉≈14 轮(>2 天生产数据),期间系统带着失准模型运行。
LLM 选择性跳变(快速、识别结构性突变):LLM 看 20 轮 episode 历史,识别 LMS 单观测看不到的多轮模式(如”连续 5 轮 GMV 迁移偏悲观但 I_gmv 趋势为正”),直接给截距打离散跳变:
关键约束:LLM 只动截距 β 不动斜率 α——截距漂移代表系统性偏差变化,斜率变化代表关系结构重构,后者交给更保守的 LMS。输出是每个受约束指标的校准 target_range。
3. Preference 通道:约束惩罚自适应
违反压力(归一化):p_j=v_j(θ)/v_j^{threshold},p_j>0 表示违反、≤0 表示满足。
非对称乘法更新(损失厌恶):
三条设计属性:① 尺度不变(乘法更新对 λ=1,000 和 λ=80,000 施加等比例调整,加法更新会过修正小权重);② 损失厌恶(收紧步 0.25 ≈ 放松步 0.08 的 3 倍——违反代价(广告收入崩)远超过紧约束的机会成本);③ 对数空间可解释(乘法在原空间=加法在 log 空间)。输出校准后的 penalty_weight 直接喂入目标函数。
4. LLM 元控制器
两个正交旋钮(硬安全边界,非建议):
为什么动框架级而非 7 维 θ:「线下 GMV 预测过去 3 轮偏乐观 5–8%」是可跨数据快照复用的结构性经验;「ps_ads_wg=2.15」是绑定今天数据分布的一次性事实(明天可能 1.73)。LLM 在可复用经验空间作业,Optuna 在易逝事实空间作业。
输入 context JSON:① 6 条 prior relation 的当前 slope/intercept;② 最近 20 个 episode(配对线下-线上指标);③ 最近 30 条 prior update history(含 LMS 与 LLM);④ 当前惩罚权重状态。证据要求:每个提议必须引用具体 episode key 作证据(无证据被拒);低置信(如近期信号矛盾)时返回空提议(优于弱接地修正)。
调用实现:经 OpenAI Codex CLI 的 exec 子命令在沙箱子进程调用(Codex 只当底层 LLM 推理引擎,Sortify 自带 memory + tool-calling):
codex exec - --skip-git-repo-check \
  --sandbox read-only --color never \
  -c model_reasoning_effort="high"
reasoning_effort=high 激活扩展推理,300 秒超时,不显式设 temperature。Prompt 单次 zero-shot(故意不给 few-shot 防锚定历史压制新结构洞察),含 ~600 词系统指令(定义 JSON schema:proposal_id + proposals 数组,每项含 relation_key/delta_intercept/penalty_multiplier/reason/evidence_episode_keys;声明安全边界 |Δβ|≤0.1、m∈[0.5,2.0]) + 动态 context JSON。
七层输出安全管道(纵深防御,确保 LLM 即使胡说也搞不垮系统——“有边界的顾问”):① Prompt 级指令约束格式与值域 → ② 鲁棒 JSON 抽取(三策略:直接 json.loads → Markdown code-block 正则 → 花括号深度状态机) → ③ schema 校验+类型强转(缺 delta_intercept 默认 0.0、缺 penalty_multiplier 默认 1.0,畸形项静默丢弃) → ④ relation_key 白名单(未知 key 立即拒) → ⑤ 硬钳位(Δβ→[−0.1,0.1]、m→[0.5,2.0]) → ⑥ 全局权重边界(乘法缩放后仍限 [1,000, 80,000] 防跨轮累积漂移) → ⑦ 失败回退(超时/不可解析/空提议 → no-op Δβ=0, m=1.0,pipeline 不中断)。
与 LMS 协同:单轮内串行——LMS 先更(Step5),LLM 读后置状态再提议(Step7-8)。冻结规则:若 Belief 更新超阈值,Preference 通道本轮冻结一轮,保诊断清晰。
5. Memory DB(7 表持久化)
7 张 SQLite 表,幂等写 + 不可变审计:
| 表 | 角色 | 写模式 |
|---|---|---|
| episodes | 事实表:每轮一行,配对线下-线上快照 | 仅追加;status: offline→deployed→online |
| offline_candidates | 每轮 Top-5 参数候选 | 每轮追加 |
| prior_relations | Belief 通道当前状态:每个指标对的 slope/intercept | 每轮 upsert |
| prior_observations | 每个指标对+episode 的 (offline, online, beta) 三元组 | 幂等追加 |
| prior_update_history | Belief 通道审计(method=lms/llm,新旧 slope/intercept) | 仅追加 |
| penalty_wt_upd_hist | Preference 通道审计(constraint, pressure, step, 新旧权重) | 仅追加 |
| memory_events | 全局不可变审计日志(event_type, idempotency_key, metadata_json) | 仅追加 |
两关键属性:幂等(prior_observations 用复合键 relation_key+episode_key,重试不产生重复) + 不可变(memory_events 当 WAL,无行被删改,留完整取证轨迹)。三种跨轮智能:LLM context 装配(取最近 20 episode + 30 update record)、跨实验热启动(Country A 直接从已有 Memory DB 状态起步)、跨市场迁移(Country B schema 零修改复用)。
系统基础设施
| 组件 | 规格 |
|---|---|
| 搜索引擎 | Optuna TPE,5000 trials/轮,25 workers(Constant Liar),15–30min |
| 状态库 | SQLite(agent_memory.db),~1KB/轮增长 |
| 参数发布 | Redis KV |
| 数据积累窗 | 3.5h(最小) |
| 总周期 | ~4h(3.5h 攒数 + 25–50min 处理),~6 轮/天 |
| 资源 | 单机、无 GPU;单 LLM API 调用/轮 |
实验设置与结果
数据集/场景:两个东南亚市场(Country A / Country B)的 PDP(商品详情页)推荐,30 轮真实生产实验。Baseline:基本是部署前后/轮次间纵向对比 + Country B 的 baseline 排序公式(无并行人工调参对照、无消融)。
指标定义:线下 Influence Share 类(I_gmv 主目标、I_order/I_ecpm_term/I_gmv_ads/ads_top10_rate 约束);线上 A/B(GMV、Orders、Ads Revenue、Advertiser Value、Organic Clicks、Ads CTR);衍生(Transfer rate = 线上 uplift / 线下 uplift;Oscillation ratio = ps_ads_wo max/min;LLM correction count = 每次提议非零调整项数)。
实验总览:
| Exp-401838(Country A) | Exp-437160(Country B) | |
|---|---|---|
| 起始 | 热启动(继承 Memory DB) | 冷启动(默认先验) |
| 轮数 | 7(warm-start) | 23(V1:11 + V3:12) |
| 时长 | 25 小时 | V1 03-05 |
| 7 参数 | ads_wo/wg, org_wo/wg, porg_w, price_pow, w2 | org_wc/wg/wo, ads_wc/wg/wo, biz_price_pow |
Exp-401838:Country A 热启动 7 轮逐轮 A/B
| Round | GMV | Orders | Ads Revenue | Advertiser Value |
|---|---|---|---|---|
| R2 | −3.6% | 0.0% | +0.7% | +7.9% |
| R3 | −1.5% | +1.7% | −0.8% | −1.0% |
| R4 | +0.2% | +1.7% | −8.7% | −8.1% |
| R5 | +1.9% | +3.8% | −5.8% | −5.6% |
| R6 | +0.9% | +2.7% | −9.4% | −10.8% |
| R7 | +9.2% | +12.5% | +5.7% | −8.9% |
GMV 从 R2 −3.6% 升到 R7 +9.2%,R4–R7 连续 4 轮正;Orders 从 R3 转正、峰值 +12.5%。两个硬警告:① R7 的 +9.2%/+12.5% 采自清晨低流量窗(~12K 曝光),统计功效弱、需高流量期复验;② Advertiser Value 除 R2(+7.9%)外全程为负、R7 达 −8.9%——为 GMV/Orders 系统性压缩广告主 ROI。
迁移分析(Belief 通道必要性)
| Round | I_gmv Uplift | Online GMV | 观察 |
|---|---|---|---|
| R2 | +18.2% | −3.6% | 显著乐观偏差;正线下 uplift 未转化为正 GMV |
| R7 | +41.6% | +9.2% | 乐观偏差仍在,但校准后线下增益开始可靠转化为正线上 GMV |
且同轮 R7 GMV +9.2% / Orders +12.5% / Ads Revenue +5.7% / Advertiser Value −8.9% 各指标不同步——证明不同业务指标不该共享单一全局校准系数,各自维护迁移关系。
参数稳定性(残余钟摆效应)
| 统计量 | Exp-401838 |
|---|---|
| ps_ads_wo 范围 | 1.96–8.91 |
| 振荡比(max/min) | 4.5× |
| 完整摆动周期 | 2 |
| 第二周期比第一窄 | 是 |
ps_ads_wo(广告订单权重)是全实验最易变参数,控广告可见性 vs 自然体验的跷跷板:搜索引擎找到高广告权重解 → 线上暴露自然退化 → 下轮约束惩罚广告权重 → 摆向另一极端。这反映单目标+惩罚建模只能逼近、不能解决的真实多目标张力——系统从无界探索转为受约束残余振荡,但未收敛到单一稳定点。
LLM 校准收敛
| 阶段 | Exp-401838 |
|---|---|
| 早期(R2) | 5 项,全面重校准 |
| 中期(R3–R6) | 2–3 项,幅度递减 |
| 晚期(R7) | 2 项,最小幅度(−0.005) |
| 趋势 | 清晰收敛:5→2 项,幅度→~0 |
热启动下 LLM 角色从”重写整个迁移框架”收敛为”填补剩余校准残差”。
Country B:冷启动到推全量(端到端唯一全生命周期证据)
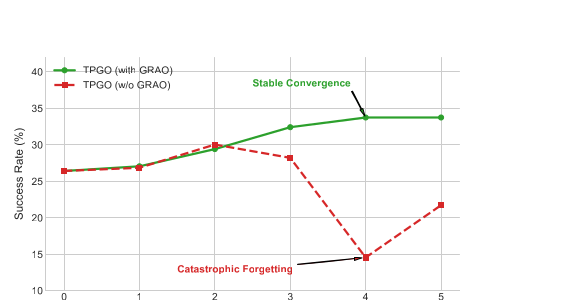
冷启动首轮信号(V1 Round 1,无先验):线下目标 0.493、I_gmv +4.9%(≥+4% 达标)、I_ecpm_term −4.5%(≥−5% 临界);ps_org_wc 从 1.0→3.71(+271.2%,全实验最大单参调整)——首轮即识别出 baseline 严重低配自然点击信号。但方向正确 ≠ 可部署:V1(11 轮)GMV 胜率仅 30%(均值 −2.4%),7 参数全程宽幅振荡。V3(12 轮)缩小搜索空间后,R8 观测窗(测 R7 参数)是唯一 GMV 与 Ads Revenue 同时为正的轮(GMV +2.6%、Ads Revenue +6.1%),据此冻结 R7 参数。
R7 冻结参数结构(高 Click、低 GMV/Order):
| 参数 | 值 | 解读 |
|---|---|---|
| ps_org_wc | 7.667 | 自然点击权重(主导) |
| ps_ads_wc | 4.381 | 广告点击权重(高) |
| ps_org_wg | 0.568 | 自然 GMV 权重(压制) |
| ps_org_wo | 0.805 | 自然订单权重(压制) |
| ps_ads_wg | 0.641 | 广告 GMV 权重(压制) |
| ps_ads_wo | 0.957 | 广告订单权重(适中) |
| ps_biz_price_pow | 1.047 | 价格幂(近中性) |
关键洞察:用点击信号主导排序、刻意压制交易信号——点击信号在自然/广告间远比交易信号零和性低,从而绕开 Country A 的广告-自然跷跷板,让 GMV 与 Ads Revenue 同时改善。
7 天 A/B 长周期验证(YMAL 场景,10% 处理 vs 20% 对照):
| 指标 | Diff | 说明 |
|---|---|---|
| GMV/UU | +4.15% | 主 KPI |
| GMV | +4.10% | 与 GMV/UU 一致 |
| GMV/Order | +3.97% | 客单价驱动 GMV |
| Order/UU | +0.17% | 近中性 |
| Ads Revenue | +3.58% | 广告收入同向为正 |
| CPC | +4.19% | 单次点击价值更高 |
| Take Rate | +3.01% | 变现改善 |
| Click/UU | +1.21% | 用户参与上升 |
| Ads Load | −2.64% | 广告位更少但更值钱 |
GMV 涨主要来自客单价(GMV/Order +3.97%)而非订单量(Order/UU +0.17%)——点击驱动排序浮现高价值商品;Ads Revenue +3.58% 在 Ads Load −2.64% 下取得,说明单广告价值显著提升(CPC +4.19%)。7 天窗滤掉日内波动,部署信心强于单轮。最终 03-24 推全量。
效率
单 LLM API 调用/轮(高 reasoning effort 下约 0.10/轮,6 轮/天 ~0.60/天)、无 GPU、Memory DB ~1KB/轮(30 轮后 <100KB);Optuna 约 6.25–12.5 CPU-hour/轮。内循环(搜参→部署→观测→校准→下轮)全自治;外层治理(冻哪轮参数、是否推全量、推后监控)仍人工。相比人工 baseline(1–2 人时/轮、~1 轮/天),边际成本降到 ~0 人时、节奏升到 ~6 轮/天。
思考与可参考价值
局限(方法学硬伤):① 几乎无可比 baseline、零消融——所谓实验基本是部署前后/轮次间纵向对比,没有「人工调参 vs Sortify」并行对照,也没测「去掉 Belief 通道 / 去掉 LLM 只留 LMS」,性能提升无法干净归因到所提机制,更像优秀的工业部署复盘而非可证伪科学论文;② 头条数字采自最不可靠窗口——Country A +9.2% GMV/+12.5% Orders 来自 R7 一个 ~12K 曝光清晨低流量窗,统计功效弱;③ 广告主利益被系统性牺牲(Country A Advertiser Value 除 R2 外全程负、R7 −8.9%)却被轻描淡写;④ 参数未真正收敛(ps_ads_wo 仍有 4.5× 钟摆残余震荡,单目标+惩罚根治不了多目标张力);⑤ 强烈自我宣传腔(大段”AI 造 AI 范式跃迁""孤独决策者的认知穿透与编排艺术”)削弱客观性;⑥ 依赖 Shopee 内部数据+Codex CLI+私有架构,外部不可复现。作者自陈未来方向:用多目标 Pareto 前沿替代单目标+惩罚以消钟摆、用置信度加权迁移模型在低流量窗更保守。
对电商/搜索推荐/Agent 方向的可借鉴点:
- 「线下指标涨≠线上涨」的 transfer gap 可建模、可持续校准——Belief 通道(线性迁移 û=αu+β + LMS 慢校准 + LLM 离散跳变)思路能迁移到任何「离线评估→在线业务」的 Agent 优化场景(如 SEO 推词线下评估 vs 线上效果、simulator 评测 vs 真实 CTR)。这是全文最硬、迁移价值最大的发现。
- LLM 别直接操纵业务参数,让它当「二阶元控制器」——只动框架级偏差/权重、有硬钳位(七层安全管道)、要求引用 episode key 作证据、低置信返回空提议。这套「有边界顾问」模式对 simulator 优化 / 多智体编排都是好的安全范式,可直接复用到任何「让 LLM 调系统但不能让它搞垮系统」的场景。
- Influence Share(可分解、sum-to-one)的归因思路实用——把不可分解的 Kendall τ 换成 L1 归一化的成对因子间隔份额,让「把 X% 影响力从因子 A 转给因子 B」可量化,对多因子排序/融合公式的可解释调参很有价值。
- 非对称损失厌恶(收紧 0.25 ≈ 放松 0.08 的 3 倍)的约束自适应思路可直接复用到任何「违反代价 >> 过紧机会成本」的在线约束场景。
- 钟摆效应是个警示:单目标+惩罚建模多目标张力根本不足,且把广告主当被压缩的隐性损失而非显式利益相关者会埋雷;后续应直接上多目标 Pareto + 把第三方利益相关者(广告主)显式建模。