Deep Research for Recommender Systems
Renmin University of China (人民大学高瓴) × Meituan (美团)
把推荐系统的最终产物从「一串商品列表」重定义为「一份帮用户做决策的研究报告」——借 Deep Research 范式让系统替用户去逛、去比、去综合。双 Agent:T5+GRPO 的轨迹模拟 Agent 生成「探索→决策」行为轨迹并召回候选,DeepSeek 驱动的自进化报告 Agent 把候选按多维兴趣拆成榜单+理由写成报告。核心是交互范式从「被动过滤器」转向「主动 agent 助理」。
核心思路
一句话问题:传统推荐系统几十年来交互范式没变——系统只负责把”相关商品”摆成一个列表,用户仍要自己逐个点开、对比规格、综合信息才能下单,认知负担重(高客单价商品尤甚)。系统是”被动过滤器(tool)“而不是”主动助理(assistant)”。
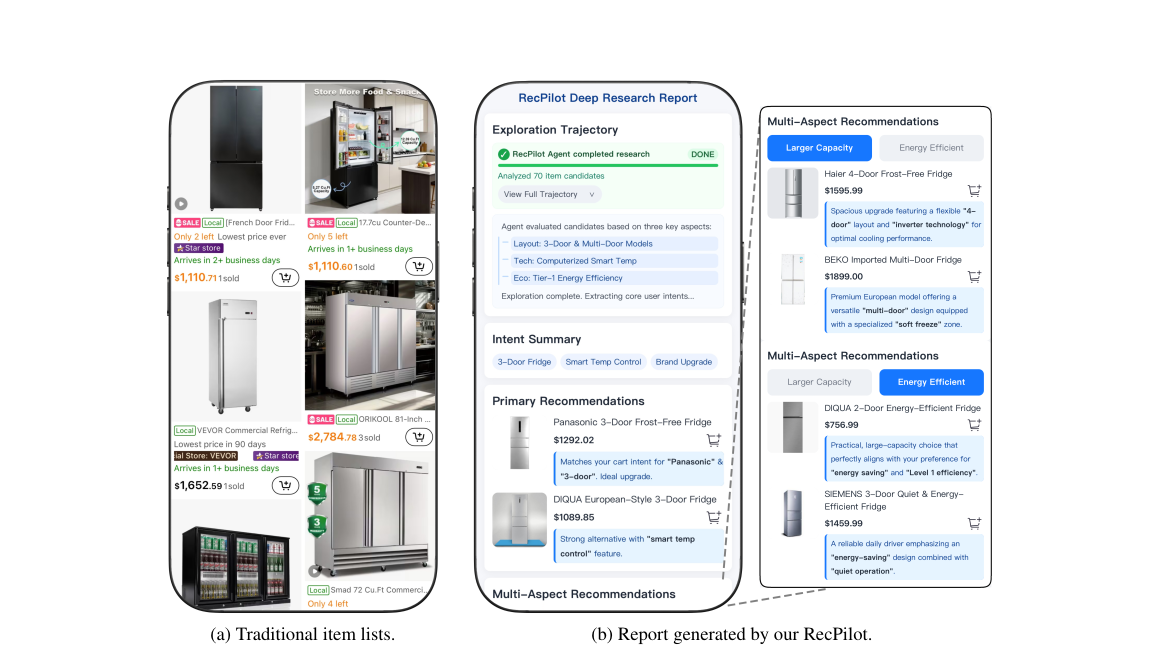
关键 idea:借鉴搜索领域的 Deep Research 范式(Agent 替你读完一堆网页、写成一份报告),把推荐的输出从 item list 重构为 user-centric 的决策报告。系统而非用户去承担”逛 item 空间”的苦活,最后产出一份带探索轨迹、意图摘要、分维度榜单和推荐理由的可解释报告,把推荐从被动过滤变成主动 agent 服务。
落地为 RecPilot 多智体框架,两个核心 Agent:
- 用户轨迹模拟 Agent:把推荐建模成生成式”探索→决策”轨迹(click→collect→cart→purchase),T5 编解码 + GRPO 强化学习 + 免模型过程奖励,替用户探索 item 空间并召回候选;
- 自进化报告生成 Agent:把候选按多维兴趣拆解、并行排序,结合 rubric + 经验双通道写成报告,并用免训练自进化机制随用户行为持续更新偏好。
形式化两个子任务:用户历史 (item-behavior 对),探索 session 。轨迹模拟是条件生成 ,报告生成是 。
整体实现思路
端到端 pipeline:上下文 + 历史交互 → 轨迹模拟 Agent(生成 N 条”探索→决策”轨迹 + 召回 top-K 候选)→ 报告生成 Agent(多维兴趣拆解 + 并行排序 + 写报告)→ 自进化(按真实购买反馈更新 rubric/经验)。
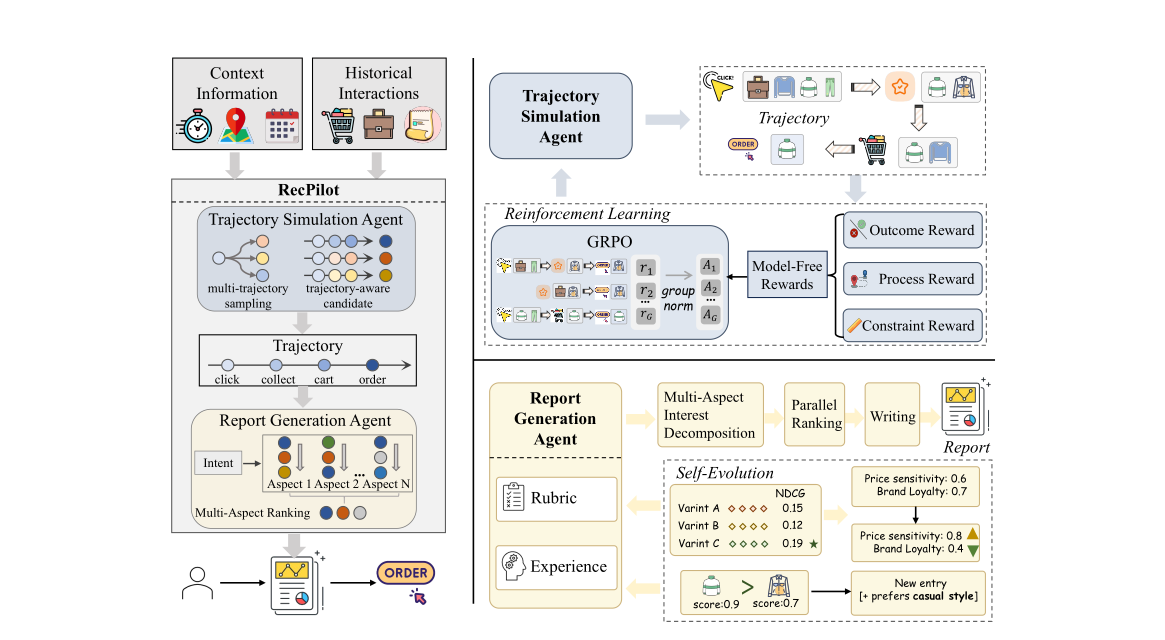
- 轨迹模拟 Agent(实例化 ):把异构行为和 item ID 映射到统一词表,按 session 做 action-guided 的 tokenization;先 SL 打底学出 item ID embedding(构成协同语义空间),再 GRPO 强化学习用复合奖励(结果+过程+约束)优化;推理时 top-p 采样 N 条多样轨迹,每条末态 hidden state 召回 top-K,合成候选池去重排序。
- 报告生成 Agent(实例化 ,DeepSeek-V3.2):用 rubric(属性优先级分)+ 经验记忆(key-value 隐式偏好)刻画偏好;LLM 把轨迹压成意图摘要 → 检索经验 → 拆成多个属性子集(aspect)→ 每 aspect 内 rubric 加权打分并行排序 → 跨 aspect 求和成总榜 → 写成四段报告。
- 自进化:免训练,best-of-n 按真实购买 NDCG 选最优榜单反更新 rubric,对比式固化经验,从 click session 挖负偏好补经验。
子模块实现(可复现细节)
子模块 1:Session-Aware Trajectory Tokenization
- 输入:原始 session 。
- 输出:tokenized 轨迹(公式 1):
- 关键设计:异构 action 类型与离散 item ID 都映射到统一词表;对同类连续行为,把 action token 当前缀(如 覆盖第 到 个同类交互),后面跟按时序排列的 item token。每条轨迹首尾加
<bos>/<eos>标 session 边界, 固定为<purchase>表决策完成。 - 为什么:把高频
<click>折叠压缩,缓解长尾 action 分布的干扰,让模型聚焦状态转移而非复读高频 token。行为有层级purchase > favorite > click。
子模块 2:监督学习(SL)打底
- 用 encoder-decoder(T5) 把历史编码与未来生成解耦,避免 decoder 过拟合历史/偏向高频行为。
- 目标(公式 2),自回归 next-token:
其中 是 tokenized 历史, 是目标”探索→决策”轨迹, 为训练集。此阶段端到端学出的 item ID embedding 后续被过程奖励复用作协同语义空间。
子模块 3:RL with Model-Free Process Rewards(核心创新)
SL 是 teacher-forcing,泛化与探索能力弱;引入 GRPO 阶段。复合奖励三件套:
① Outcome Reward(公式 3) — 末位预测命中真实购买:
直接对齐推荐终极目标但稀疏,难指导中间探索。
② Process Reward(公式 4,Max-Sim pooling) — 这是论文最巧的一步。不要求 token 级复刻历史,只要求生成商品与真值商品在协同语义空间语义一致(用 SL 学的 ID embedding)。对每个生成 item 取与真值轨迹所有 item 的最大余弦相似度,再 mean-pool:
是生成轨迹的 item, 是真值轨迹的 item。理由:同阶段(如连续 click)item 间严格次序很弱、易受页面布局影响;语义对齐而非 ID 硬匹配能保留行为多样性、提升对未见轨迹的泛化。
③ Constraint Reward(公式 5–7) — 长度 + 格式约束。长度指数衰减惩罚():
格式硬罚 :若轨迹(1)直接以 <purchase> 开头(零探索)或(2)含连续相同 action token 无中间 item,则 否则 。合成 。
Policy Update via GRPO(公式 8–10):每个用户采样 条轨迹 ,总奖励 ;组内归一化算 advantage:
最大化 clipped 目标:
,KL 项防策略偏离初始分布。无需独立 value 网络。
子模块 4:Exploration Trajectory Generation(推理)
- Diverse Trajectory Sampling:greedy/beam search 多样性不足,改用 top-p 采样(每步从累积概率 的 token 采样),并行生成 条不同轨迹。
- Trajectory-Aware Candidate Generation:每条轨迹用末步 hidden state 预测 next item、取 top-K,得 候选池;把探索轨迹拼上预测 item 成完整轨迹,整条轨迹的 log-likelihood 作候选打分;去重后取 top-K,连同各自”探索→决策”轨迹传给报告 Agent。
子模块 5:Agentic Report Generation
Rubric-Experience 双通道偏好:
- 结构化 rubric(骨架):用 item 属性作跨用户通用维度,用户 偏好是各属性优先级分集合 ,支持数值化比较。
- 文本经验(血肉):经验记忆 每条是 key-value(情境条件为 key、相关内容为 value),捕捉 rubric 编码不了的情境化隐式偏好。
Multi-Aspect Interest Decomposition + Parallel Ranking:
- LLM 把模拟轨迹压成意图摘要 ;
- 用 检索经验 (语义相似度选 top);
- 以摘要+检索经验为 context,LLM 识别多个属性子集 即 aspect,对每个 aspect 相关属性的 rubric 分各加 强调相关性;
- 每个 aspect 并行排序——LLM 对候选 item 评每个属性匹配度 ,rubric 加权求和(公式 11):
- 跨 aspect 直接对所有分求和成总榜并排序。
Structured Report(公式 12),四段:
是 LLM 把内容转成报告组件的函数;=模拟轨迹,=意图摘要,=跨 aspect 总榜,=各 aspect 榜单(用属性生成对应理由做决策支持)。
子模块 6:Self-Evolution for Personalization(免训练)
- Rubric Optimization(best-of-n):各 aspect 榜单按真实购买(high-level 行为)的 NDCG 评分,选 NDCG 最高的榜单、用其(加了 的)rubric 分反更新原值,过滤掉次优/噪声调整。
- Experience Consolidation(对比式):以 NDCG 最高榜为正例、优化前榜为负例,当正例把真实购买项排得更高时构对比对,LLM 生成纠偏经验条目,明确写出需调整的决策逻辑。
- Extended Experience Mining:真实 purchase session 稀缺,对 click 等 low-level session,LLM 推理潜在负偏好/未满足需求补经验库;不用来更新 rubric(rubric 是精确数值、low-level 行为噪声大)。
实验设置与结果
数据集:TMALL(click/collect/cart/purchase 四行为),取两周记录按天切 session,过滤训练集出现 <5 次的 item。处理后 288,777 用户 / 556,233 item / 1,294,696 session;session-wise leave-one-out,只保留含 purchase 的 session 做验证。最终 306,088 train / 1,941 valid / 1,272 test。预测目标为 purchase。
实现细节:轨迹模拟骨干是极小 T5——2 encoder + 2 decoder 层,hidden 64,FFN 中间维 256(ReLU),2 头(head dim 64),AdamW,batch 32,lr cosine annealing + warmup,按 valid NDCG@10 选 checkpoint。报告骨干 DeepSeek-V3.2,经验检索用 Qwen3-Embedding-8B,所有方法解码 temp 0.2、max 16384 token,输出统一为公式 12 四段格式。
轨迹模拟任务(Recall@k / NDCG@k)
| Metric | GRU4Rec | BERT4Rec | SASRec | PBAT | MBHT | MB-STR | ReaRec | RecPilot |
|---|---|---|---|---|---|---|---|---|
| Recall@5 | 0.0618 | 0.0527 | 0.0636 | 0.0551 | 0.1015 | 0.1025 | 0.0794 | 0.1557 |
| Recall@10 | 0.0793 | 0.0708 | 0.0808 | 0.0726 | 0.1139 | 0.1175 | 0.0904 | 0.1706 |
| NDCG@5 | 0.0470 | 0.0398 | 0.0526 | 0.0418 | 0.0793 | 0.0833 | 0.0645 | 0.1241 |
| NDCG@10 | 0.0526 | 0.0456 | 0.0581 | 0.0476 | 0.0833 | 0.0880 | 0.0681 | 0.1292 |
相对最强基线 MB-STR:Recall@5 +52%(0.1025→0.1557)、NDCG@5 +49%。结论:显式建模”探索→决策”连续过程比判别式直接映射历史→预测更强。
轨迹模拟消融:
| 变体 | Recall@5 | Recall@10 | NDCG@5 | NDCG@10 |
|---|---|---|---|---|
| Ours | 0.1557 | 0.1706 | 0.1241 | 0.1292 |
| w/o CR(约束奖励) | 0.1439 | 0.1651 | 0.1142 | 0.1211 |
| w/o PR(过程奖励) | 0.1454 | 0.1643 | 0.1165 | 0.1227 |
| w/o RL(仅 SL) | 0.1187 | 0.1376 | 0.0922 | 0.0982 |
w/o RL 跌最狠(R@5→0.1187),证明 RL + 过程奖励是收益关键;CR 保结构、PR 引导语义意图收敛。超参:top-p 0.95 最佳(过小保守、过大引入噪声 token)、temperature 1.0 最佳;轨迹越长效果越好(4→12,探索 depth 即 reasoning depth)。
报告生成任务(6 维 1–5 分,真人 + Gemini-3-flash 模拟用户)
模拟用户与真人 Cohen’s Kappa = 0.7064(良好一致),后续多用模拟用户评分。
| Evaluator / Method | Accuracy | Coverage | Informativeness | Clarity | Consistency | Novelty | Avg. |
|---|---|---|---|---|---|---|---|
| Simulated DeepSeek-V3.2 | 4.46 | 3.44 | 3.67 | 4.50 | 3.88 | 2.86 | 3.80 |
| GLM-5 | 4.38 | 3.30 | 3.47 | 4.24 | 3.70 | 2.73 | 3.64 |
| Qwen3-Max | 4.05 | 3.24 | 3.66 | 4.48 | 3.78 | 2.91 | 3.68 |
| GPT-5.2 | 4.35 | 3.40 | 3.77 | 4.67 | 3.91 | 2.89 | 3.83 |
| ReAct | 4.45 | 3.35 | 3.62 | 4.41 | 3.82 | 2.92 | 3.76 |
| Plan-and-Solve | 4.48 | 3.52 | 3.76 | 4.55 | 3.90 | 3.07 | 3.88 |
| RecPilot | 4.60 | 3.62 | 3.80 | 4.80 | 3.94 | 4.09 | 4.14 |
| Real GPT-5.2 | 4.07 | 3.41 | 3.83 | 4.54 | 4.05 | 2.97 | 3.81 |
| Real Plan-and-Solve | 4.25 | 3.45 | 3.83 | 4.41 | 4.00 | 3.13 | 3.84 |
| Real RecPilot | 4.36 | 3.60 | 3.82 | 4.69 | 4.00 | 4.06 | 4.09 |
指标定义:Accuracy=看完报告选的 item 是否=label;Coverage=是否覆盖核心决策属性;Informativeness=可核验事实占比;Clarity=对比/结论是否清晰;Consistency=意图/榜单是否严格跟随模拟轨迹;Novelty=是否提出有据可循的额外兴趣。优势几乎全集中在 Novelty(4.09 vs 所有基线 ≤3.13),来自多维兴趣拆解。Agent 方法(ReAct/Plan-and-Solve)普遍优于直接推理。
Pairwise(vs Plan-and-Solve,模拟用户胜率):Novelty 77%、Clarity 66%、Accuracy 60%、Coverage 57%、Informativeness 55%、Consistency 52%——全维度领先。
报告侧消融(Avg.):RecPilot 4.14 → w/o Rubrics 4.10 → w/o Interest Decomposition 4.09 → w/o Experience 4.08。三组件方向一致但差异极小(在噪声量级内),主要拉开是 Accuracy(4.60→4.46 当去掉 Interest Decomposition)。
Self-Evolution:用 2/5/8/11/14 天数据优化,性能随时间跨度单调上升;早期(2→8 天)靠经验记忆快速适应,后期靠 rubric 权重稳定化做长期偏好建模。
案例:item list vs 报告
思考与可参考价值
局限:
- 单数据集单域:只有 TMALL 电商,跨域泛化完全未验证,对主打”新范式”的论文是硬伤。
- 核心卖点缺客观证据:“减少用户努力”全靠主观 5 分制,没有真实决策耗时 / 点击次数 / 转化的客观度量,claim-evidence 缺口明显。
- 方法-指标可能循环:多维拆解显式去挖”额外兴趣”,而 Novelty 指标定义恰好是”是否提出额外兴趣”,77% 新颖性胜率说服力打折。
- 报告侧消融在噪声内(4.14→4.08~4.10),难证各组件真有用,暗示报告增益大半来自结构化格式本身。
- 原子 ID 方案扩展性差:对长尾/冷启动 item embedding 学不动(故过滤 <5 次),百万/亿级 item pool 效率作者自己列为 open problem;过程奖励依赖 ID embedding 协同空间,扩展即受限。
- 延迟/成本未量化:报告 max 16384 token + 多次 LLM 调用 + 检索,online 可行性未评。
对电商/搜推/Agent 方向的借鉴:
- 生成式召回:把”探索→决策”轨迹当显式 reasoning chain 来生成、再用末态 hidden state 召回候选,比纯判别式多了可解释中间推理,且整条轨迹 log-likelihood 当候选分是简洁的排序信号,可直接嫁接到生成式召回/Push simulator。
- Max-Sim 协同语义过程奖励:正解决生成式推荐 RL “奖励太稀疏 / ID 硬匹配扼杀多样性”的通病——用语义相似度替 0/1 命中做 reward。对 simulator click-AUC 那条线可能是新杠杆(语义相似度 reward 提供密集信号)。
- 落地必须换语义 ID:要支撑百万/亿级 item,原子 ID 必须换成码本分解的语义 ID(否则长尾+冷启动直接崩),过程奖励也要从 item 向量余弦改成码序列层面相似度。
- 报告范式真正缺的是客观省力度量:落地前应先建真实决策耗时/转化的 online 评测;作者给的务实出路是「快列表 + 慢报告」双模式,只对高客单价品开报告模式。
- rubric + 经验双通道 + 免训练自进化是合理的轻量个性化工程组合:数值 rubric 做可比较骨架、文本经验做情境化补充、best-of-n + 对比式经验固化避免重训,对 Agent 记忆/偏好建模有参考价值。