Autonomous Information Seeking: A Roadmap for Agentic Recommender Systems
National University of Singapore × Polytechnic University of Bari × Renmin University of China (人大高瓴) × USTC (中科大)
Agentic RecSys 领域第一篇以「自治度(Level of Autonomy)」为主轴的系统性 survey。核心贡献是一套双轴分类法——**Agent 角色 × 自治等级**:角色分 agent-assisted(agent 辅助经典推荐器)/ agent-as-recommender(agent 直接当推荐器)/ agent-as-simulator(agent 模拟用户)三种,自治度分 L0 被动排序→L1 会话→L2 检索增强→L3 工具驱动→L4 单智体规划→L5 多智体编排→L6 概念性 AGI 社会。关键概念区分在于:**LLM-based RS ≠ Agentic RS**——只有显式具备规划、工具调用、持久记忆、模块协同的系统才算 agentic,单次前向的 prompt-based LLM 推荐仍是「反应式」的。全文另有一个尖锐的元批判:架构跑得比测量快,大量论文声称有 memory/planning/multi-agent,却只用静态 NDCG 评测,等于没验证自己的核心 claim。
核心思路
一句话问题:「Agentic Recommender System」这个词在文献里被用得极其随意——挂个 LLM 就自称 agentic,导致无法比较、无法判断进展。
关键 idea:不按算法族(MF vs 神经网络)、也不按任务(召回/排序/重排)来分类,而是用两个正交轴重新组织整个领域:
- 宏观角色(macro role) —— agent 站在推荐闭环的什么位置;
- 自治等级(Level of Autonomy, LoA) —— agent 被允许做多少事。
作者明确划出一条大多数论文含糊带过的界线:LLM-based RS 不等于 Agentic RS。很多 LLM 推荐系统仍然是纯反应式的——它们响应 prompt、吃 in-context history,但不显式规划、不调外部工具、不维护跨会话持久记忆、不协调多个专用模块,单次前向就出结果。只有把「行动选择」显式建模进推荐环境的系统才算 agentic。
推荐系统被重新形式化成一个交互式决策过程而非静态映射函数。按轮次 :用户输入 ,交互历史 ,系统内部状态 (用户/物品画像、记忆等长程一致性所需的隐变量),系统从动作空间 选动作 。关键在于 不再只有「推荐物品 」,而是包含:
- 对话动作:提问澄清、确认、解释、协商 trade-off
- 工具动作:检索、排序、过滤、查知识库、浏览网页
- 环境动作:加购物车、预订、排期(当这些在职权范围内)
于是范式从 “models that rank”(会排序的模型) 转向 “systems that pursue goals”(会追目标的系统)。
两个正式定义:
- LLM Agent for Rec: —— 推理引擎(LLM)、 控制器/策略(决定怎么 prompt、怎么解析工具调用、怎么多步执行,如 ReAct)、 画像模块、 记忆模块、 工具集。
- Agentic RecSys (ARS): —— 用户集、物品全集、外部环境(web/API/KB/模拟器)、可选的经典 RS 组件 、agent 集合 。注意 是 optional 的:它在 agent-assisted 里存在,在 agent-as-recommender 里退化成「被 agent 当工具调用」。
整体实现思路
轴一:自治等级 L0–L6
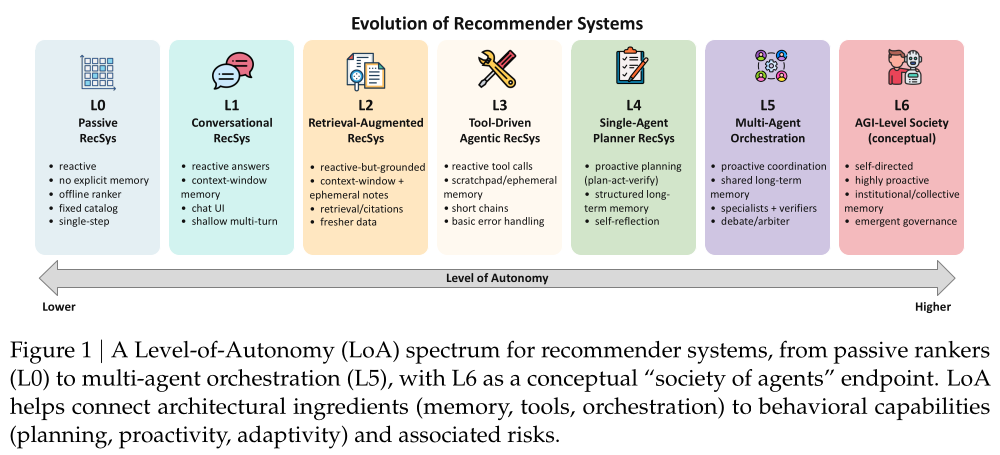
LoA 由四个反复出现的维度驱动:(1) 任务范围与规划风格(单次打分 → 多步 plan-act-verify);(2) 上下文感知与记忆(短 in-context 状态 → 持久用户/环境记忆);(3) 交互灵活性(静态输出 → 多轮、混合主动、多智体对话);(4) 适应性(静态推理 → 更新画像/反思/从反馈学习)。
| 等级 | 名称 | 关键能力 | 记忆形态 |
|---|---|---|---|
| L0 | Passive RecSys | 反应式、单步、固定 catalog、离线排序器 | 无显式记忆 |
| L1 | Conversational RecSys | 反应式回答、chat UI、浅层多轮 | context window |
| L2 | Retrieval-Augmented RecSys | 反应但有据(grounded)、检索/引用、数据更新 | context window + 临时笔记 |
| L3 | Tool-Driven Agentic RecSys | 反应式工具调用、短链、基础错误处理 | scratchpad / 临时记忆 |
| L4 | Single-Agent Planner | 主动规划(plan-act-verify)、自反思 | 结构化长期记忆 |
| L5 | Multi-Agent Orchestration | 主动协同、专家+验证者、debate/仲裁 | 共享长期记忆 |
| L6 | AGI-Level Society(概念) | 自导向、涌现式治理 | 机构/集体记忆 |
survey 聚焦 L2–L5:这是今天真正存在具体架构、且自治相关设计选择(记忆、工具、编排、验证)会实质影响推荐质量与风险的区间。
轴二:三种宏观角色
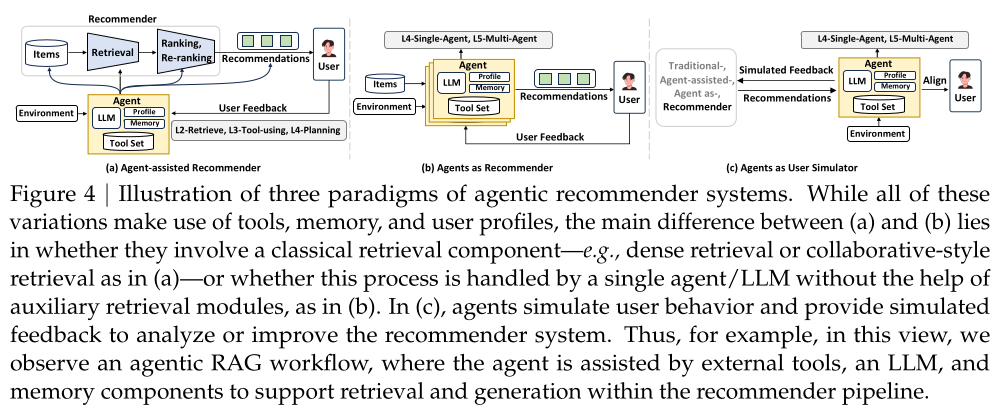
(a) 与 (b) 的分水岭是「有没有经典检索组件」:(a) 里 dense retrieval / 协同过滤式召回仍在,agent 只在旁边帮忙;(b) 里这个过程由单个 agent/LLM 直接接管,经典模型若存在也只是被调用的工具。决策权(decision authority)在谁手里,是区分 augmentation 与 replacement 的唯一硬标准。
| 角色 | 定义 | 决策权 | 典型 LoA | 代表工作 |
|---|---|---|---|---|
| Agentic Augmentation(agent-assisted) | agent 在经典推荐器旁边改进特定环节(偏好澄清、证据检索、结果过滤) | 经典模型出最终排序 | L2–L4 | RecMind, iAgent, ARAG, ToolRec |
| Agentic Replacement(agent-as-recommender) | 一个/多个 agent 全责推荐:维护用户状态、编排工具、召回排序、生成解释 | Agent | L4–L5 | InteRecAgent, MADREC, DRDT, MACRec |
| Agentic Simulation(agent-as-simulator) | agent 模拟用户/环境行为,产生 click/rating/critique/对话用于训练、评测、鲁棒性分析 | 不直接推荐 | L4–L5 | RecAgent, Agent4Rec, RecoWorld, CreAgent |
两轴交叉才能定位一个系统:「一个重排经典模型候选的 RAG 助手」= augmentation × L3;「一个同时建模用户与创作者的多智体模拟环境」= simulation × L5。
子模块实现(可复现细节)
模块 A —— Agent-Assisted:检索增强 / 工具驱动 / 规划辅助(L2–L4)
A1. 检索增强(L2) 用三个正交视角组织,作者强调 RS 里的 RAG 与 NLP 里的 RAG 不同,检索到的证据必须对齐推荐结构:
- 功能角色(why retrieve):① 偏好接地 —— 检索历史片段以稳定意图、减少跨轮不一致(RAH 查结构化人格库拿偏好/目标/价值取向;iAgent 用工具调外部知识 + LLM 内部知识辅助 reranker);② 物品接地 —— 检索物品证据支撑解释、防编造;③ 上下文扩展 —— 为健康/金融/旅行等垂域检索领域知识。
- 检索内容(what):用户信息(画像、历史、约束,分长短期)/ 物品语义(属性、评论、多模态内容)/ 辅助知识(外部语料、KG、领域源)。这个选择直接决定隐私风险:用户侧检索常含敏感数据,辅助知识检索则引出来源与许可问题。
- 检索流程(how sequenced):① 粗到细(先召回宽候选,再按约束精化);② 带反思的迭代检索(检索→起草→检测缺失证据→再检索);③ 多源融合(用户历史检索 + 物品属性检索)。这些流程隐式引入了 planning,因此应该在 trajectory 层面评测,而非只看最终准确率。
L2 的三个失效模式(作者点名):检索偏置(高频/易检索的模式主导)、上下文过载(关键证据 “lost in the middle”)、伪接地(检索文本给了虚假信心但无因果相关性)。
A2. 工具驱动(L3) —— 工具四分类:① RecTools(传统召回器/排序器/候选过滤模型,直接给候选集或排序列表);② 外部信息工具(web/领域搜索、KB 查询);③ 属性工具(特征计算器、KG 补全、约束检查器——按结构化属性过滤);④ 多模态工具(视觉/音频编码器、captioner)。
作者的关键观察:tool-driven assistance 之所以有效,往往不是因为 LLM 是个强排序器,而是因为它在编排一批具有更好归纳偏置的结构化组件(检索、排序、图搜索)。这句话建议做工业落地的人抄在墙上。
A3. 规划辅助(L4) —— 规划不止发生在对话里,共四类:交互规划(下一句问什么)、表征规划(怎么更新用户偏好/物品描述,如 AgentCF)、排序/重排规划(先满足哪个约束、怎么权衡目标)、优化规划(LLM agent 自动诊断算法缺陷、迭代更新推荐策略/流水线——这正是本站 agentic-rec 下 AgentX / NOVA / AgenticRecTune 那一整条线)。
模块 B —— Agent-as-Recommender:单智体五件套(L4)
单智体推荐器被拆成可复用的五组件(这是本 survey 最有工程价值的分解):
B1. Profile(持久偏好与约束建模):不同于经典推荐器把画像隐式编码进 latent embedding,agentic 系统显式维护文本/结构化画像以支持可解释与可控。
- InteRecAgent:三面画像
{like, dislike, expect},由 LLM 从对话历史动态合成,同时抓长期偏好与短期意图,直接喂给工具调用。 - Instruct²Agent:instruction-aware 画像 + 轮级用户反馈更新 + 动态抽取器(在当前指令下导出任务特定偏好),做到per-user 优化与其他用户解耦。
B2. Memory(工作/情景/语义三层):
| 记忆类型 | 定义 | 代表实现 |
|---|---|---|
| Working(工作记忆) | 短期对话上下文 | InteRecAgent 的 Candidate Bus:data bus(每轮初始化为全量物品或用户指定候选,每次工具执行后更新)+ tracker(记录每个工具的输入/输出/执行状态),让候选可以在多个工具间流式串联,并支撑 reflection 判断 |
| Episodic(情景记忆) | 可检索的历史交互与反馈记录 | PUMA |
| Semantic(语义记忆) | 抽象后的偏好事实与世界知识 | RecMind 拆成 Personalized Memory(用户评分/评论)+ World Knowledge(物品元数据 + web 搜索实时信息);MemRec、AFL |
BiLLP 的做法值得注意:给 actor / critic / planner 各配独立工作记忆,每步后更新。
B3. Tool-Using:同 A2 四分类。具体实现细节:RecMind 用 Database Tool(NL→SQL 取域内知识)+ Web Search Tool + Text Summarization Tool;ToolRec 的属性导向检索/排序工具——检索工具按指定属性模式与规模约束返候选,排序工具用 LLM + 指令模板按用户历史与属性相关性排序,从而无需为每个属性单独训模型就能捕捉隐式意图;AgentDR 把全 catalog 排序委托给传统推荐器,agent 只负责整合多模型输出(个性化的工具适用性)+ 注入替代品/互补品的常识关系推理——这是缓解幻觉同时保持可扩展性的关键工程折中。
B4. Workflow Controller(三种控制流):
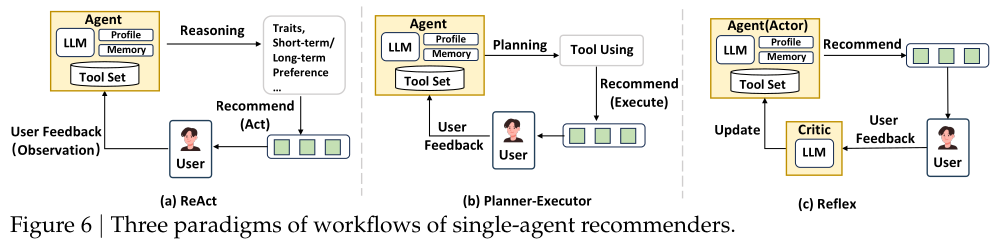
| Workflow | 机制 | 优势 / 代价 | 代表 |
|---|---|---|---|
| ReAct | 推理与工具调用交替,增量精化候选与约束 | 对开放式请求有效;但早期工具调用出错会复合放大 | MoRE(动态选组合多个 reflector)、DRDT(发散思维动态反思)、R4ec(reasoning-reflection-refinement 环,actor 提议 + reflection 模型纠错)、Re2LLM(自反思建 hint 知识库,训轻量 agent 选 hint,无需微调 LLM)、SRLF(set-wise 反思,评估整个候选集) |
| Plan-then-Execute | planner 先分解子目标,executor 按计划执行工具调用 | 可控性强(计划可被检查、被约束) | InteRecAgent(第一阶段 LLM 生成完整工具使用计划,第二阶段按计划顺序执行,不必每步都调 LLM);RecMind 的 Self-Inspiring (SI) 规划——利用所有已探索的推理分支生成每一步,比 CoT/ToT 的单路径更多视角 |
| Reflex | 自批判环 / judge-checker | 持续策略精化 | BiLLP(actor-critic,critic 评估用户满意度即 action advantage value,更新 actor 策略);T-PRA(actor-critic 平衡满意度与兴趣探索);AgentDR(plan-then-execute + reflex 检查) |
B5. Optimization(两种反思):
- Self-Reflection(内部批判):T-PRA 的 critic 模块生成结构化反馈 → 用 DPO 联合精化 actor 与 advisor。
- Feedback-Reflection(外部信号):ECPO 建模每轮的用户期望与确认,定位不满来源,做细粒度的轮级偏好更新——避免了 MTPO 那类方法的高采样成本。
模块 C —— Multi-Agent Recommender(L5)
C1. 角色与协调协议:常见角色集 = manager/planner、retriever、ranker、analyzer、critic、verifier、safety monitor。协议四类:manager–worker 分解(MACRec、MultiCF、LLMOrch)、debate–judge 选择(MACRS)、基于角色的可信对话协议(MATCHA)、协商式多利益相关方推荐(Collab-REC)。
C2. 通信——作者反复强调一个模式:结构化 hand-off 优于自由聊天。
- ARAG:staged hand-off 而非 free-form chat ——
understanding → alignment-scoring → evidence compression → ranking,让决策可诊断。 - RecBot:Parser → Planner 用显式 JSON 消息传归一化意图,防止多轮指令执行中的语义漂移(semantic drift)。
- TAIRA:Manager 选 thought pattern → 分解子任务 → 派给专用 Executors → 回收证据聚合。
- Collab-REC:moderated rounds —— agent 提交 act-conditioned 提案,moderator 反馈拒绝与惩罚(如重复城市、虚构城市)并要求修订,得到协商共识而非自由聊天。
C3. 优化(几乎都不做梯度更新):
- RecBot:simulation-driven distillation —— 用 GPT-4.1 教师产高保真轨迹,蒸馏进轻量学生 agent,兼顾线上部署效率与推理规划能力。
- TAIRA:thought-pattern distillation —— 把成功推理迹抽象成可复用的规划模板,无需重训 LLM。
- Collab-REC:多轮协商 + penalty-aware scoring(奖励 agent 成功、惩罚重复与幻觉条目),显式导向跨利益相关方的均衡多样列表。
模块 D —— Agent-as-Simulator(L4/L5)
模拟分三层:数据合成(TalkPlayData 2、ColdLLM、LAUS)→ 单智体用户模拟(RecAgent、Agent4Rec)→ 闭环多智体环境模拟(RecoWorld、CreAgent、RecInter、GGBond)。
用户模拟器的四个设计轴(作者强调这四轴必须显式评测而非假设成立,否则会「训练在模拟器的赝像上」):
- Fidelity(保真度):靠 画像构造 + 记忆设计 两件事。画像:RecAgent/Lusifer 用人口属性(性别/年龄/特质/兴趣),Agent4Rec 从 MovieLens-1M 导出社会特质(活跃度 activity、从众性 conformity、多样性 diversity)。记忆:RecAgent 引入 sensory memory(把原始观察转成精简表示);Agent4Rec 提出 factual memory(编码交互行为)+ emotional memory(捕捉交互引发的心理状态)。
- Controllability(可控性):CSHI 用插件式管理器做分阶段行为控制 + 显式画像操纵 + human-in-the-loop;也可通过调记忆衰减率建模兴趣漂移、调画像采样分布模拟不同人口构成。
- Observability(可观测性):不只输出 implicit feedback,还输出理由。Zhang et al. 的可解释模拟器把 LLM 偏好推理 + 统计行为建模结合,产高保真训练数据供 RL 推荐器用。
- Calibration(行为校准):
- user-system 动作:Agent4Rec 把逐页浏览拆成 taste-driven(浏览、评分、观后感——即时偏好)与 emotion-driven(退出会话、给推荐系统打分——满意度与疲劳如何影响去留)两类;部分工作还建模供给侧(创作者/商家)以更新物品属性或生成新物品。
- user-user 动作:RecAgent 允许 agent 之间一对一聊天 + 一对多广播,捕捉社会维度。
模拟的四个风险(写得很清醒):① 模拟器–策略错配(agent 过拟合模拟器怪癖,离线虚高、线上崩——对会钻反馈生成漏洞的 agentic 系统尤其致命);② 闭环中的误差复合(用户响应的微小错误设定会随时间放大,得出关于长期福利的误导结论);③ 模拟器本身缺乏评估(模拟器必须当作模型来评,而不只是当工具来用);④ 模拟既是评测对象又是评测方法,二者不可分割。
实验设置与结果
这是 survey,没有自己的实验。它的「实证结果」是文献计量,以及一套评测框架。
文献统计(2024 Jan – 2026 Mar)
检索范围 DBLP / ACM DL / IEEE Xplore / arXiv,2018–2026.03;关键词组合 agent recommend、RAG recommend、retrieval-augmented recommend、agent personalization、recommend simulator;三步收集:纳入标准(含自治/半自治 agent 用于推荐、用户模拟或评测;排除只把基础模型当特征抽取器的工作)→ 迭代滚雪球(前后向引用追踪至无新工作)→ 标注编码(按 agent 角色、架构、自治等级、模态、评测、可信性标注)。
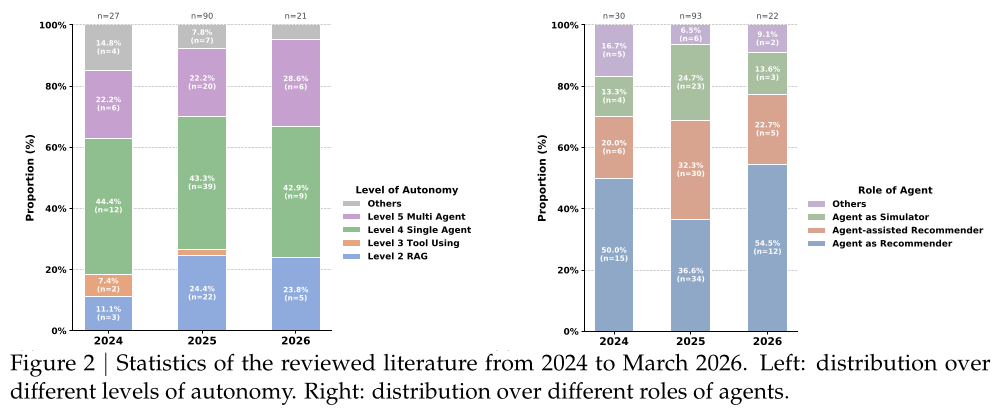
| 维度 | 2024 | 2025 | 2026 (至 3 月) |
|---|---|---|---|
| 论文总数 | ~27–30 | ~90–93 | ~21–22 |
| L2 检索增强 | 11.1% (n=3) | 24.4% (n=22) | 23.8% (n=5) |
| L3 工具使用 | 7.4% (n=2) | ~2% | — |
| L4 单智体 | 44.4% (n=12) | 43.3% (n=39) | 42.9% (n=9) |
| L5 多智体 | 22.2% (n=6) | 22.2% (n=20) | 28.6% (n=6) ↑ |
| Agent as Recommender | 50.0% (n=15) | 36.6% (n=34) | 54.5% (n=12) |
| Agent-assisted | 20.0% (n=6) | 32.3% (n=30) | 22.7% (n=5) |
| Agent as Simulator | 13.3% (n=4) | 24.7% (n=23) ↑ | 13.6% (n=3) |
三个结论:(1) 爆发式增长——2024 的 ~27–30 篇 → 2025 的 ~90–93 篇,约 3×;(2) 向目标驱动的自动 agentic 推荐倾斜——Agent-as-Recommender 是主导范式,Agent-as-Simulator 明显上升(13.3% → 24.7%);(3) 向更高自治度迁移——L4 稳定占 40%+,L5 从 22.2%(2024) 稳步升到 28.6%(2026)。
评测框架:从「排序列表」到「轨迹」
作者主张 ARS 必须当作交互系统评测。一个 轮 episode 的轨迹是
其中 用户输入、 内部/环境状态、 agent 动作、 工具/记忆/模拟器/其他 agent 返回的观察、 面向用户的输出。经典指标只评了 里那个排序列表。Agentic 评测需要一个测量向量:
分别对应推荐效用、交互质量、生成输出质量、接地性、工具与规划行为、记忆行为、安全、成本。该测哪些分量由 LoA 决定:L2 要检索与接地检查;L3 要工具使用诊断;L4 要计划、记忆、反思评测;L5 要协同与失败归因指标。
评测中最常见的混淆是把 target(评什么)/ protocol(怎么评)/ metric(报什么数) 三者搅在一起。作者给了一张矩阵拆开:
| Target(评测对象) | Protocol(协议) | Metric(指标) |
|---|---|---|
| 推荐结果 | 离线 benchmark / 模拟 / 线上 A/B | HR, Recall, NDCG, MRR, MAP, AUC, CTR/CVR |
| 交互与生成输出 | CRS benchmark / 用户研究 / 对话模拟 / 人类或 LLM judge | Success@K, 任务完成率, 平均轮数, 满意度, BLEU/ROUGE/BERTScore |
| 接地与 RAG 证据 | 检索 benchmark / claim-level 审计 / 噪声或对抗证据测试 | Retrieval Recall@K, 上下文相关性, 引用准确率, 忠实度, 幻觉率, 矛盾率 |
| 模拟器有效性 | 模拟器 vs 日志对比 / 人工验证 / 下游效用 / simulation-to-A/B 对齐 | 分布相似度, 评分/点击一致性, 泄漏率(leakage rate), 处理效应相关性 |
| Agent 轨迹(工具/记忆/规划/协同) | trace logging / 功能验证 / 模块消融 / 错误分类 | 工具选择准确率, 参数合法性, 执行成功率, 计划覆盖率, 恢复成功率, 记忆 precision/recall, 矛盾率, 共识达成时间 |
| 安全/隐私/公平/部署 | red teaming / 投毒-越狱测试 / 隐私审计 / 生产监控 | 攻击成功率, 策略违规率, 隐私泄漏, 曝光失衡, 延迟, token 成本, 超时/降级率, 留存/GMV |
几条落地时最容易踩的坑(作者直接点破):
- 高 NDCG 什么都不证明:它不证明 agent 选对了工具、把 claim 接地到了 catalog 证据、维持了一致的画像、问了有用的澄清问题、或满足了延迟约束。
- 收益可能来自错误的地方:L2 的增益可能只是更好的检索或 prompt 构造;L3 的增益可能掩盖了脆弱的工具路由;L4 的增益可能只依赖 reflection prompt;L5 的增益可能只反映了某一个有用的专家 agent,而非有效的协同——所以必须做角色消融。
- 降级行为必须测:一个在工具失败后静默降级到通用排序器的系统,看起来很可靠,但它已经不在执行你要研究的那条 agentic workflow 了。
- 平均延迟不够:多步 agent 会死在长尾工具延迟上,必须报 tail latency。多智体可能降低 wall-clock 但抬高总 token 成本,parallelism 要单独报。
- 模拟器可能作弊:一个能访问隐藏 target 标签、完整物品元数据或未来交互的模拟器会产生过度乐观的结果。模拟器同时输出 implicit feedback 和理由时,两者必须分开评——文本讲得通不代表 click/rating 行为真实。
作者还给了一张最小报告清单(minimum reporting checklist),覆盖离线推荐(数据切分、候选集、负采样、baseline、重复跑、LLM 版本)、对话生成(judge rubric、prompt、证据可见性、一致性统计)、RAG(检索源、证据粒度、新鲜度、claim 切分)、工具与规划(tool schema、调用日志、参数合法性检查、恢复策略、planner 消融)、记忆(类型、更新规则、陈旧记忆策略、隐私与删除处理)、多智体协同(消息格式、轮数、共识规则、死锁处理、每角色成本)、安全隐私(威胁模型、攻击预算、泄漏指标)、部署(延迟分布、token 成本、超时/降级率、置信区间)。
元批判:架构跑得比测量快
“The main evaluation gap is that architecture has advanced faster than measurement.”
大量论文引入了 memory、tools、RAG、planning、reflection 或多智体,却仍然主要用静态排序指标评测——等于论文的核心 claim 从未被验证。这条批评对本站 agentic-rec 下所有工业论文同样成立(AgentX 不报失败率、YouTube Self-Evolving 不报 silent-failure 率,NOVA 的 EPR=LPR·(1−SFR) 拆法反而是少数正面样本)。
思考与可参考价值
局限
- 无实验、无 benchmark、无代码——它提出「应该这么评」,却没有把 checklist 兑现成一个可跑的 benchmark 或 leaderboard。批评评测缺失的 survey 自己也停在了倡议层面。
- L0–L6 谱系有事后合理化的味道:L6「AGI 社会」明确是概念性的凑数项;L1(会话) 与 L2(RAG) 的边界在真实系统里非常糊(一个带 RAG 的多轮 chatbot 到底是 L1 还是 L2?)。作者自己也只敢认领 L2–L5。
- 统计口径偏窄:2026 只统计到 3 月(n≈21),却和整年的 2024/2025 并列画趋势图,「L5 升到 28.6%」这个结论建立在 n=6 篇上,噪声很大,不宜当强证据引用。
- 对工业侧那条线覆盖偏薄:AgentX / NOVA / REA / AgenticRecTune 这类「agent 优化推荐系统本身」的工作,在它的分类里被塞进 §3.3 的「优化规划」一个小节。而这条线恰恰是目前唯一有真实线上 A/B 收益的分支。这暴露了双轴分类法的一个盲区:它的两个轴都是围绕「agent 在推理时的位置与权限」设计的,装不下「agent 在研发时改进系统」这个正交维度。
对电商 / 搜推 / Agent 方向的可借鉴点
-
先用 LoA 给自己的系统定级,再谈收益。这是最实用的一条:如果你的系统实际是 L2(检索增强、单轮、固定 pipeline),就不要按 L4/L5 的话术去写方案和汇报。作者对 L2 的定性很准——「反应式、单轮检索、固定 pipeline 难以适应」,是静态检索模型与自主推荐 agent 之间的过渡态,而不是终点。
-
五件套分解(Profile / Memory / Tool / Workflow / Optimization)可以直接当 agent 系统的设计 checklist。尤其 workflow 三选一(ReAct / Plan-then-Execute / Reflex)的取舍是有明确判据的:要可控性和可审计 → Plan-then-Execute(计划可被检查、被约束,且不必每步调 LLM,省成本);要灵活探索 → ReAct(但要防早期工具调用错误的复合放大);要持续策略精化 → Reflex。
-
AgentDR 的折中是工业落地最该抄的那个:把全 catalog 排序委托给传统推荐器(保证可扩展性 + 不幻觉),agent 只做它擅长的两件事——整合多模型输出、注入替代/互补品的常识关系推理。这正是「LLM 不是好排序器,但是好编排器」这一观察的具体形态。在亿级 item 的电商场景,任何让 LLM 直接生成/排序全库物品的方案都会撞墙,这个 pattern 是稳的。
-
多智体一定要用结构化 hand-off,不要 free-form chat。ARAG 的 staged hand-off(understanding → alignment-scoring → evidence compression → ranking)和 RecBot 的 JSON 显式消息防语义漂移,是两个可以直接复制的工程模式。free-form 多智体聊天在生产里既贵又不可诊断。
-
评测那一节对做用户模拟器的人价值最高:
- 必须把「下游效用」与「模拟器有效性」分开评——模拟器提升了下游 NDCG,不代表它像真实用户。它可能只是泄漏了标签、或者坍缩了行为多样性、或者奖励了钻它漏洞的策略。
- 必须测 leakage:能看到隐藏 target 标签/完整元数据/未来交互的模拟器,结果必然虚高。
- implicit feedback 与 rationale 必须分开评:理由写得像人不代表 click 行为像人。换句话说,LLM 生成的文本合理性与行为预测能力是两回事——一个能把「为什么点这个」讲得头头是道的模拟器,其点击/评分分布可能与真实用户相去甚远。做 LLM-based 用户模拟时,如果只评了文本质量就宣称模拟器可用,等于跳过了唯一重要的那个检验。
- 长周期环境必须报稳定性检查,否则响应模型的微小误差会复合成关于留存/公平/信息茧房的误导性结论。
-
反过来看,这篇 survey 最该被记住的一句话是那句元批判:架构跑得比测量快。做 agentic 系统时,如果你加了 memory / planning / 多智体,却只用最终排序指标去证明它有用,那你其实什么都没证明——收益可能来自 prompt、来自某一个专家 agent、来自更好的检索,唯独可能不来自你声称的那个机制。对应的解法就是角色消融 + 轨迹级指标 + 可证伪归因(这与本站 NOVA 的 silent-failure 门、AgentX 的可证伪归因是同一个哲学)。