AgentX: Towards Agent-Driven Self-Iteration of Industrial Recommender Systems
Kuaishou (快手)
把工业推荐系统的「迭代」本身交给 Agent——不是让 LLM 当推荐器,而是让多智体闭环自己 brainstorm 想法→改生产代码→上线跑 A/B→从结果里学,把「想法到上线」周期里工程师的重复劳动彻底自动化。四个 Agent(头脑风暴/开发/评估)串成闭环,第四层 SGPO 把执行轨迹蒸馏成「语义梯度」反过来优化 Agent 自己的 prompt,越跑越强。最大价值在于以真实线上 A/B 作 reward、在快手十亿级流量上实测:3 周 3 个 worker 把 374 个想法跑成 10 个可上线策略,单 worker 业务价值 3.7× 于人类工程师,主 feed +0.561% 使用时长、本地生活 >1 亿年化营收。
核心思路
一句话问题:工业推荐系统的算法迭代(数据分析 → 特征工程 → 建模 → 上线 → A/B → 归因复盘)几十年来一直「人肉串行」,发布周期以周计;工程师大量精力耗在拉数、改配置、维护 pipeline 这些重复杂活上,真正稀缺的「提好假设 / 看懂失败 / 找优化方向」反被工程摩擦稀释。结果是创新吞吐量与人头线性绑定,而不是随证据、算力、经验复利增长。
关键 idea / 范式:把推荐迭代的瓶颈从「算法工程师的劳动」转移到「Agent 系统的能力」——前者依赖个人经验、不可复制;后者可重复、可复利。一旦每次线上迭代的执行轨迹能被记录、分析、回喂给底层 Agent 框架,系统就不再是线性的自动化工具,而是一个会自我进化的开发引擎。
注意区分本文与「LLM 当推荐器(LLM4Rec)」「Agent 当推荐器」两条线:AgentX 是 Agentic Automation for RecSys——Agent 去设计和改进底层推荐模型/策略本身,而不是直接给用户出 item。它对标的不是推荐算法,而是 AI Scientist / ML-engineering-agent 那一脉,只是把战场搬到「真实工业推荐 + 真实线上 A/B reward + 持续自进化」这个此前空白的象限。
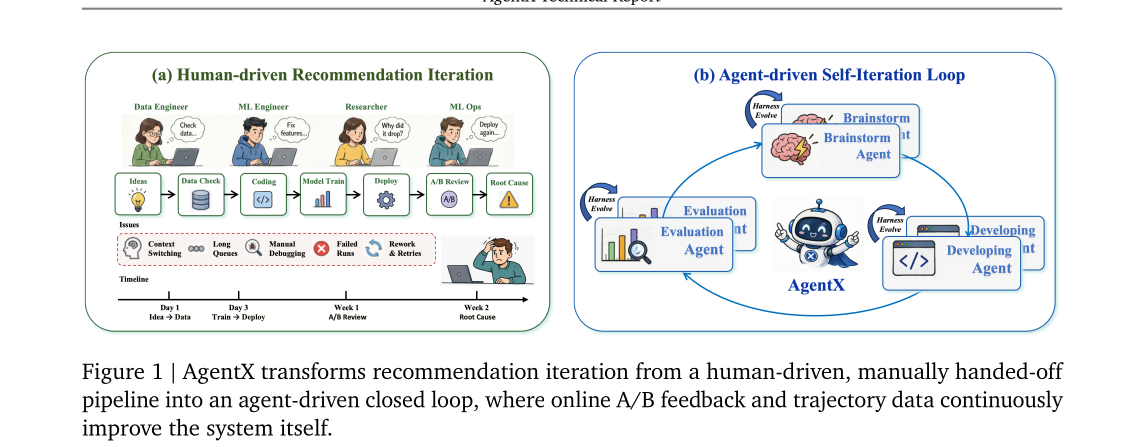
作者明确指出已有工作的三个结构性 gap:① 缺真实线上反馈——多数系统的成功信号来自离线指标或人类专家打分,不等于真实业务价值;② 缺工业规模验证——公开工作的数据/模型/pipeline 规模远低于十亿级样本、多目标耦合、多业务线并行的真实系统,而规模会从根本上重塑瓶颈结构;③ 缺持续进化机制——多数 ML-engineering agent 做完一个任务不沉淀参数/prompt/workflow,反复踩同一个坑。AgentX 就是冲着这三点去的。
整体实现思路
端到端是一个**闭环(closed-loop)而非一次性(one-shot)**的 pipeline,由四个阶段构成,前三个把一个 idea 从「意图」带到「被验证的线上结果」,第四个把轨迹回喂、让闭环自己变强:
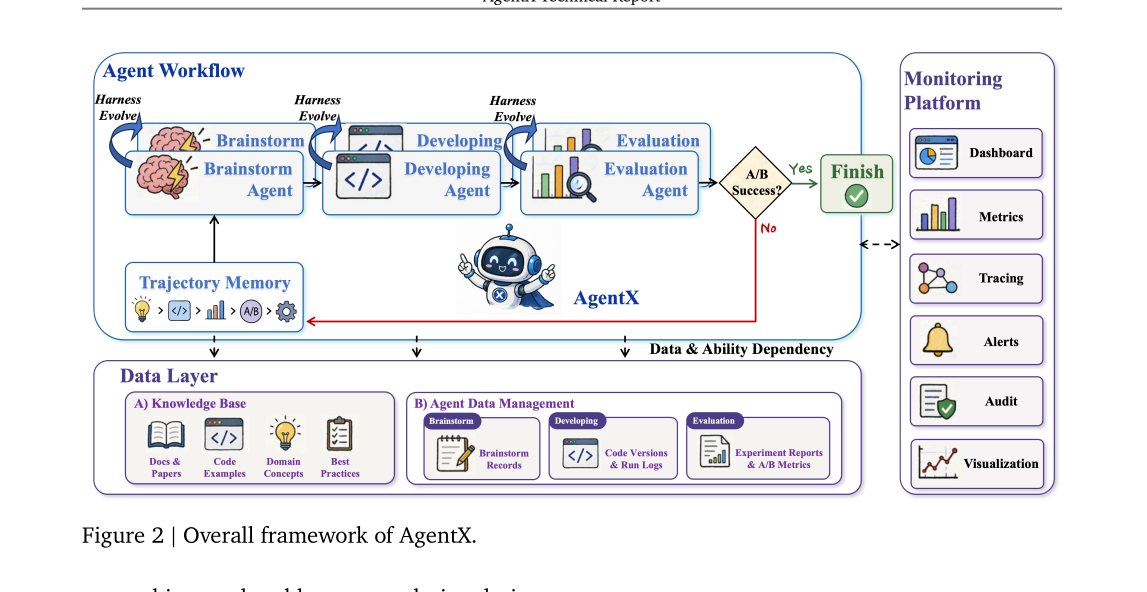
- Brainstorm Agent:把欠定义的用户意图,经「有界探索 + 证据加权生成」,变成一小批排好序、可执行的实验提案。
- Developing Agent:把每个选中的提案,经「仓库接地生成 + 面向验证的实现循环」,落成生产可用的代码(线上策略轨道)或可信的训练实验(离线模型轨道)。
- Evaluation Agent:管理灰度发布与流量分配,用「护栏否决(guardrail veto)」判读 A/B 结果,并把线上结果(含失败)资产化成可复用的 reward 信号与失败记忆。
- Harness Evolution(SGPO):对累积的执行轨迹做推理,用语义梯度 prompt 优化(SGPO)更新单个子 Agent的规格,且只经「成对回放」准入。
环绕这条闭环还有共享的 Data Layer(Knowledge Base 经验库 + Agent Data Management 实验记录)和 Monitoring Platform(Dashboard/Metrics/Tracing/Alerts/Audit/Visualization),把每一个产物持久化。
子模块实现(可复现细节)
模块 A — Brainstorm Agent(想法生成)
职责边界:不是吐一长串「看着合理」的点子,而是把模糊优化意图变成一小批有生产证据支撑、限定在允许的改动面、精确到能被编码/上线/事后诊断的提案。它显式拆成三块:Question(把欠定义意图变成明确任务边界)→ Idea Production(有界探索 + 证据上下文)→ Validation & Materialization(人审 + 生产检查 → 结构化提案产物)。
-
有界探索(Bounded Proposal Exploration):成批而非自由生成;每个候选被打上三种成熟度状态之一——
ready-to-implement(有具体目标 + pipeline 落点 + 目标路径 + 足够证据)、probe-first(有前景但需先做一次数据/dry-run 探针)、moonshot-backlog(依赖未来基建/模型能力的长线方向)。批循环是残差式的:每轮把被拒方向、历史重复、违反约束、已覆盖机制写入avoid set,下一轮只搜剩余空间,避免换皮重复。 -
证据加权评分(Evidence-Weighted,核心公式):四个证据源 对同一候选用 candidate-specific 的权重混合(而非固定检索策略): 其中 是结构化任务边界, 是该源给出的证据分。最终候选分把证据项与目标对齐、业务有效性、可实现性、交接完整度、风险综合: 风险项 惩罚重复方向、未解决的核心信号、范围过宽、不安全 trade-off 等。
-
四个证据源各管一类「接地」:
- Experiment KB:历史 launch review、业务定义、过往结论与教训——防止重新发现已知失败 / 误用业务概念;候选越依赖新颖性/历史证据/业务语义,权重越高。
- System KB:模型架构、特征定义、DSL 行为、pipeline 边界、配置语义、源码 scope——降低 code-path 敏感提案的幻觉。构建为结构化领域 wiki三层(schema 层 / wiki 层 / raw-source 层),经
ingest–query–lint生命周期维护,代码 diff 触发增量更新。 - Data Analysis:历史分析报告、指标定义、SQL plan、离线统计,必要时跑实时 SQL——验证「问题是否真实存在、目标人群是否够大、指标跌幅是否显著」。
- Model Research:把论文转成可执行的提案知识而非文本摘要。每篇论文拆成 typed claims(problem/assumption/method/finding/limitation)+ architecture components + inter-paper relations(extend/contradict/parallel/apply),并标注证据强度。关键工业区别:生产 baseline 用同一 schema 表示,带 feature contract(每个特征槽的 name/dim/embedding-table 身份)和硬训练约束(流式在线增量训练、无 epoch、禁止 backbone freezing / early stopping)。于是 paper-derived idea 在源头就被真实生产架构与训练制度约束住,而非事后拿生产指标评——这正是与学术 auto-research(搜索空间和 reward 都是合成的)的本质差异。
模块 B — Developing Agent(开发,双轨道)
两条轨道共享同一套「面向验证」的纪律,但交付物不同。
B1 线上策略轨道——交付安全可上线的生产代码。核心难点是「能编译但语义错」的仓库级可靠性失败:属性幻觉(凭空发明 user/context/item 特征字段)、DSL 误用、harness-pattern 违规(放错队列 / 注册不全 / 绕过安全模式)。对策:
- 仓库接地生成:项目专属 KB(改动模式、注册约定、特征开关规则、已接受 patch 范例)+ case toolbox(确定性工具:user/context/item 三侧 schema 查询工具、ranking DSL checker、C++ checker、轻量静态 linter)。最重要的接地规则是「特征属性用前必查 schema」——字段名变成已验证事实而非 LLM 猜测。
- 面向验证的实现循环:abstract(把提案抽成实现计划:哪些文件可改 / 需要哪些信号 / 哪个 pipeline stage / 哪个 feature switch 守护 / 提交前必过哪些检查)→ 实现原子子需求 → 组装 → 确定性验证。两层验证:accuracy loop(实现 vs 计划比对,额外修复迭代记为质量成本,理想是一次到位)+ dryrun pipeline(编译 + 集成检查,理想一次通过;反复失败说明 Agent 在拿远程基建当 debug 工具)。
- 8 维质量评分(公式 + Table 1):,,当前实例化为 人工干预是硬二值门: 无干预 / 有干预;Dryrun 相对「一次通过」打分 。三个 severity-S 维度——属性幻觉(22%)、correctness-loop 开销(18%)、人工干预(18%) 合计占 58%,因为它们最直接威胁自治生产可靠性。
| 维度 | 含义 | 严重度 | 权重 |
|---|---|---|---|
| N1 | C++ 语法糖违规 | B | 6% |
| N2 | Harness 模式违规 | A | 12% |
| N3 | 属性幻觉 | S | 22% |
| N4 | Ranking DSL 检查修正 | A | 8% |
| N5 | C++ 语法检查修正 | B | 6% |
| N6 | Correctness loop 迭代次数 | S | 18% |
| N7 | 人工干预 | S | 18% |
| N8 | Dryrun pipeline 通过 | A | 10% |
B2 离线模型轨道——交付可信的训练结论(要进知识库,不可被幻觉污染)。单轮 pipeline:
- policy 先承诺如何被证伪:声明改动 + 宣称的因果机制 + 一组 expected observables(每个精确命名,接到
tf.print/tf.summary,并描述健康 vs 病态行为,如「step 1000 后 gate activation > 0.5 表示活门,≈0 表示坍缩」)。 - verify 检查两件事:git diff 语义是否匹配 policy 方向、每个声明的 observable 名是否出现在 diff 里;不过则 code agent 重写(≤3 次,耗尽则干净判败而非带病前进)。
- experts×N 并发独立投票:每个专家只拿 policy 文本 + 自己的私有 KB,物理隔离于历史与他人意见;共识由 Python 计票( 超多数),绝不由 LLM 判。
- exec 是纯 Python 状态机(无 LLM):提交→轮询→评估→指标抽取,AUC 用正则从原始训练日志拉——因为指标抽取是有标准答案的模式匹配,幻觉 AUC 进库代价太高。
- 可证伪归因(Falsifiable attribution):final review 逐条裁决因果链 link(verified/broken/unclear),Python 确定性折叠:全 verified →
CLEAR,任一 broken/unclear →UNCLEAR。verdict 与 attribution 分离:AUC 涨但归因 unclear 是刹车信号,不传播未归因增益。论文 RankMixer 例:Round 1 复现乘法门 ,代码对、AUC +0.0003,但 gate observable 全程≈0——Glorot 初始化使 把门归零、梯度阻断,attribution=UNCLEAR,增益不记录;Round 2 一行残差修复 ( 时退化为恒等、恢复梯度)→ ΔAUC=+0.0022 全链 verified。 - 平台故障下的鲁棒执行:纯函数分类器读 log head(8MB)+tail(256KB)+中段采样的 ≤64 条 FATAL,映射到 reason code。确定性错误(NaN 梯度、特征表冲突、缺评估 checkpoint)立即放弃;瞬时故障(log stall、基建中断)重试一次;LLM 网关失败轮换网关。reason code 按固定优先级评估,
ps_aborted这种可能掩盖底层确定性错误的基建症状永远最后评。一个 detached watchdog daemon 对整批活跑同策略自愈。
模块 C — Evaluation Agent(评估,把噪声流量变可信 reward)
- 安全部署与流量分配:deployment addressing 把每个实验映射到正确 business domain/world,选 split factor,分配互斥流量桶;账号绑定实验按 UID 路由、设备侧体验按 device ID、混合人群用「UID 优先、匿名回退 device」;桶分配欠定时做 pre-experiment balance check 选基线最匹配的组。参数改动须过工程白名单;配置走 canary 灰度窗口再放全量,监控到不稳定即halt。
- A/B 判读 + 护栏否决:指标抽取与决策逻辑分离;有 pre-experiment 历史时用 CUPED 方差削减,不满足假设回退 DiD / 直接分组对比;上游缺数则缩/移观察窗而非把残缺查询当结论。护栏三原则:① 业务域局部化(消费/直播/电商/广告各有自己的核心指标与否决阈,不受全系统护栏并集约束);② 复合经济交换指标(用加权多目标的 LT exchange score,单指标走负不自动否决,大幅降噪);③ 阈值是注意力信号而非绝对硬墙(触发即升级人审;高收益策略可走 exception-review 通过)。输出是结构化裁决 KEEP / EXTEND / DISCARD + 主效应 + 护栏状态 + 统计方法 + 观察窗 + 注意事项。
- 负结果资产化(Negative-Result Assetization):每个失败实验写明根因(缺显著性/护栏恶化/流量不匹配/实现侧 caveat/业务语境不符),并按 pipeline stage、业务目标、受影响人群/内容段、策略杠杆建索引。下一轮 brainstorm 前可检索这些资产,把「低频用户在粗排 boost 损了留存护栏」这类坐标组合标成高风险区。
模块 D — Harness Evolution(SGPO,让 Agent 自己变强)
实验分析只解释「策略是否有效」,不解释「为何上游 Agent 没抓到约束 / 漏了因果链 / 交接不全 / 代码违规」。SGPO(Semantic-Gradient-based Prompt Optimization)是第二层优化,目标不是推荐策略本身,而是控制每个子 Agent 如何推理的 harness(指令、验证规则、输出契约、工具使用纪律)。生产安全版一次只改一个子 Agent,其余冻结,保证可检视、可归因。
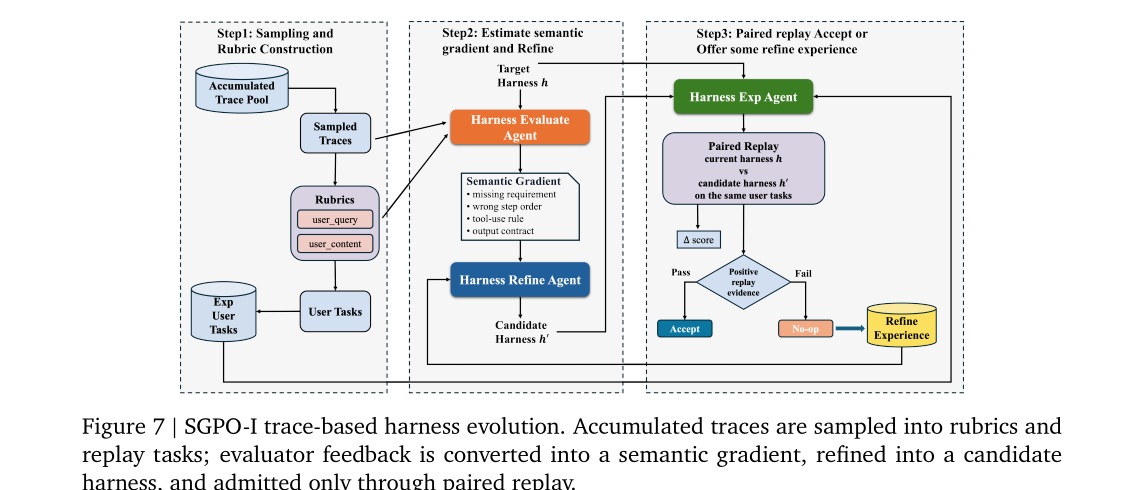
SGPO-I(证据=会话轨迹)三步:
- 损失计算(语义梯度):,其中 是子 Agent 在第 轮的 harness, 是采样轨迹, 是从初始/后续用户输入抽的 rubric。语义梯度 不是数值导数,而是「缺失约束 / 步序弱 / 证据要求欠定义 / 下游契约不全」的结构化诊断。
- 语义梯度更新:,仅改目标子 Agent 的指令/验证规则/输出契约/工具纪律。
- 成对回放准入:用同一批 replay 任务(由 LLM 把用户 query 改写成保留业务域/目标/护栏/约束的独立任务)同时跑新旧 harness, 否则 no-op,被拒 patch + 评分 + 失败解释存为 refine experience。SGPO 的可靠性来自这道准入门,而非评估器的绝对正确——judge 误诊只会变成 no-op,不会永久劣化。Table 2:brainstorm 子 Agent 5 轮把归一化 replay 分从 75.15% 拉到 98.00%,关键 accepted 编辑不是泛泛润色,而是「生成前先显式化任务契约」「每候选须暴露 business-causal chain」这类具体契约变更。
SGPO-II(证据=历史 MR 编码回放):把证据源从对话轨迹换成历史 merged request。先过滤噪声(bulk reformat / revert / 依赖升级 / <10 行 / >5000 行 / 生成文件为主 / diff 上下文已不存在),把每个 MR 转成「只给需求」的任务、隐藏落地 patch,Agent 在 MR base commit 的干净分支上实现。5 维编码 rubric(Table 3):语义正确性 40%(硬门 ≥4)、需求覆盖 25%、文件覆盖 20%、默认安全 10%、风格 5%;加权 ≥4.0 且语义 ≥4 才算过。Table 4 复杂异步模块案例:2.60 → 4.90(+88%)。少数回归(如 3.67→1.80)被刻意保留以刻画方法边界,但准入门挡住其进入生产 harness。
模型研究探索 pipeline 的进化(harness 固定、搜索空间进化):三阶段穷举——Phase 1 每篇论文一个复现提案、按 mean ΔAUC 排行取 top-=16;Phase 2 逐模块隔离消融(每个 ablatable 模块枚举 orig_choice + LLM 推断的替代,bundle 只激活目标模块、其余回退 baseline,≥24/32 实验为正 ΔAUC 才确认有效);Phase 3 跨论文组合(嫁接最高 delta 的已确认模块;每 4 轮触发 challenger 轮把 top 模块用到 rank 17–32 论文保多样性)。记忆引导剪枝:paper-level(结果证伪论文核心前提则该论文全模块退出,如 RankUp 全复现 ΔAUC=−0.0203 且 observable 直接矛盾 → 记为 paper-level prune + anti-pattern)、module-level(Phase 2 确认无独立贡献则退出 Phase 3)。饱和检测:对离散化架构字段做 SHA-1 novelty signature,重复率 >80% 连续两轮则停。经验飞轮:每轮结果(无论成败)append-only 入事件日志,整理成 anti_patterns(带 log/diff 正则)与 playbook(ΔAUC>0.001 才记),且每条经验须过两道门——阈值门(≥2 次独立 run)+ 对抗审查门(专门 Agent 试图证伪其因果机制),存活才 confirmed。
实验设置与结果
部署:快手 App 3 周,3 个 AgentX worker 并发跑「想法→上线」闭环,覆盖两个生产场景——主 feed 推荐 + 本地生活商业化。以真实线上 A/B 为权威 reward。
漏斗(Table 5 / Eq.10):374 ideas 106 passed 100 launched 10 launchable results。两条业务线内部自洽:主 feed 361×27.7%×95.0%×8.4%=8,本地生活 13×46.1%×83.3%×40.0%=2。
单 worker 生产力对比(Table 8):
| 指标(每 worker·周) | AgentX | 人类工程师 | 比值 |
|---|---|---|---|
| 并发实验数 | 12 | 1.5 | 8× |
| LR 数 | 1.1 | 0.08 | 13.8× |
| 累计使用时长收益 | 0.0623% | 0.0167% | 3.7× |
| 单 idea 上线转化率 | 2.7% | 5.1% | 0.53× |
作者坦诚不 claim 单 idea 质量持平:人类手挑想法命中率仍高约 1.9×;AgentX 是「自动化下的量」换「稀缺下的精」。
最反直觉的发现——瓶颈是工程而非算法:268 个被拒想法的归类(Table 6)中,参数资源冲突 64.7%(目标参数已被 holdout/在飞实验/异世界占用,想法没错但落不了地)、缺 user/item 属性 14.5%,平台 + 基建侧合计吃掉 91.4% 的拒绝,真正的 Agent 错误(硬约束/白名单违规 7.5% + 弱假设/护栏风险 1.2%)只占 8.7%。编码失败(Table 7)同样 95%+ 是基建侧(DSL wiring 35% + MaTX/C++ 约束 20% + if/else 结构 15%)。→ 最高杠杆的下一步不是更聪明的 Agent,而是brainstorm 前就查 AB 平台状态的上游冲突检查器。
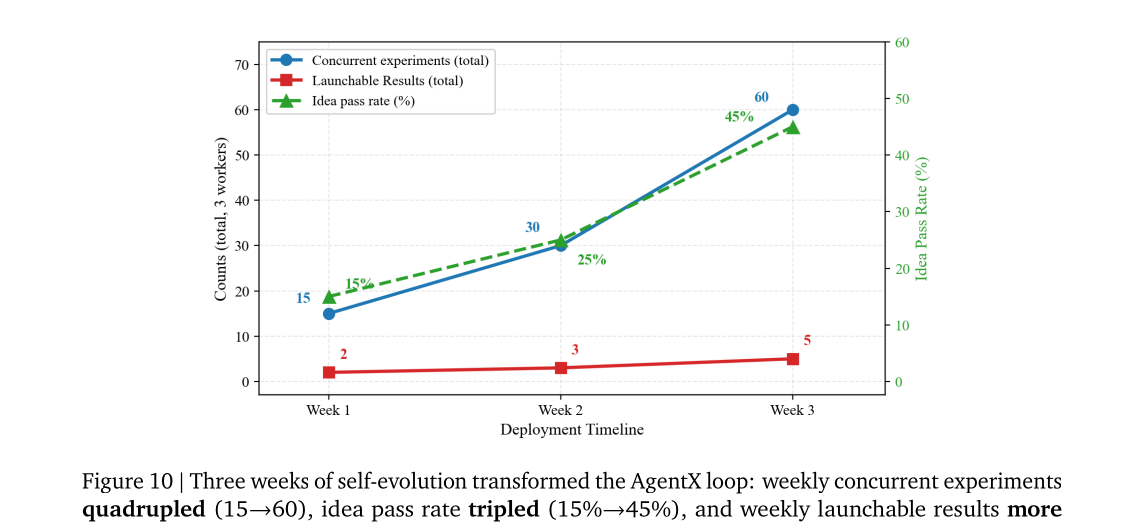
自进化(Figure 10):3 周内每周并发实验 15→60(翻两番)、idea pass 率 15%→45%(翻三倍)、每周 LR 2→5(翻倍多);skill 固化 + 踩坑积累 + dryrun 模板成熟共同把吞吐与选择性同时拉高——「不只产得多,还产得更对」。
真实业务收益:主 feed 累计 +0.561% 用户使用时长;本地生活 >1 亿元年化营收。
端到端案例(PCV 排序):Loop 1 直接 PCV boost ( 相关性基分、 混合 PCV 分、 固定权重)→ 弱正但噪声大(人均时长 +0.034%、活跃设备 −0.023%、18–30 段设备均用 −0.032%);Evaluation 诊断「需质量门控 + 活跃度自适应 + 时长约束」。Loop 2 约束 PCV 排序 ,其中 时长导向基分、 质量门控、 活跃度动态权重 → 用户时长 +0.071%、real-show +0.118%,护栏稳定。完整跑通「生成→实现→评估→反馈重设计→知识固化」闭环。专家 Agent 协同案例(本地生活):训练一个推荐决策 Agent 做 user-level 诊断 + 自然语言控制建议,AgentX 落成可控原子动作(CPM boost),UV 级控制 → 营收 +4.7%。
思考与可参考价值
这是一篇工业系统论文,不是算法论文——真正的贡献是「闭环 + 真实线上 A/B reward + 工业规模 + 持续自进化」这个此前空白象限的首个生产级落地,而非某个新模型结构。读它要带着「系统/流程设计」而非「刷点」的视角。
可直接借鉴(电商/搜推/Agent 方向):
- **「事实用确定性代码、判断才交给 LLM」**是贯穿全文的可靠性铁律:特征字段查 schema、AUC 用正则抽、专家用 Python 计票、归因用 Python 折叠——把幻觉能进入系统的入口逐个堵死。任何要进生产的 Agent 系统都该抄这条。
- 可证伪归因(falsifiable attribution):要求 policy 上线前先声明「会观察到什么 observable 才算机制成立」,AUC 涨但 observable 没动则判 UNCLEAR、不记增益。这对我们 simulator/生成式召回那条 AUC 线尤其有价值——能挡掉「数字涨了但说不清为什么」的虚假杠杆,避免把 lucky 超参当机制写进经验库。
- 负结果资产化 + 经验双门(≥2 run 阈值门 + 对抗证伪门):把失败按「stage×目标×人群×杠杆」坐标建索引、要求经验能解释自己的因果机制才能入库——比「直接从 A/B 结果蒸经验」(作者点名对比 AgenticRecTune 的 Skillhub)更抗 spurious correlation。
- SGPO = 语义梯度 + 成对回放准入门:把「优化 prompt」做成可回放、可门控的离线系统优化,可靠性挂在准入门而非 judge 正确性上——这是把 prompt 优化工程化、敢上生产的关键设计模式。
- 最务实的工程洞察:在真实十亿级系统里,Agent 的推理质量远不是瓶颈(错误仅占 8.7%),平台/基建摩擦(参数资源冲突 64.7%、缺特征 14.5%)才是。任何想在公司内落地「Agent 自动迭代」的人,第一优先级应是把 AB 平台状态/特征可用性做成 Agent brainstorm 前的前置检查,而不是先卷模型。
局限与存疑:① 技术报告、单公司、无代码,结果难独立复现/验证;② 没有与其他 Agent 系统的对照,唯一 baseline 是单个人类工程师;③ 单 idea 质量仍低于人类(0.53×),「量换精」是否长期划算未知;④ SGPO 的 replay 分由 LLM-judge 给,存在评估循环风险(虽有成对回放门缓解);⑤ 3 周窗口偏短,自进化「每周翻倍」是 ramp 期现象,能否持续存疑;⑥ 业务数字(+0.561%、>1 亿、+4.7%)口径与归因细节有限,外部无法核验。