AgenticRecTune: Multi-Agent with Self-Evolving Skillhub for Recommendation System Optimization
把「推荐系统级配置调优」(多模型 head 分数融合权重、各阶段阈值等非可微「胶水参数」)这件原本靠工程师人肉网格搜索 + 反复上线试错的活,整体交给一套 LLM 多智能体闭环来做。Actor 提案 → Critic 过滤 → Online 自动起 A/B → Insight 从结果抽规律 → Skill 写回技能库,再加一个会随历史实验自我进化的 Skillhub(技能=Task Context+Requirement+North Star+初始配置+Domain Knowledge+Tools 的插件),让 agent 越调越懂业务。已在 Google Discover 三阶段(pre-/ranking/re-ranking)多次成功上线。
核心思路
一句话问题:现代工业推荐系统是「pre-ranking → ranking → re-ranking」多阶段流水线,绝大多数研究只盯着「把某一个模型练得更好」,但真正决定系统上限的还有一类系统级配置(system-level configurations)——每个模型 head 输出的多路分数怎么融合成最终分(fusion weights)、各阶段的截断/路由阈值、为满足业务目标对分数做的调整等。这些「胶水参数」具备三个致命特性:(1) 非可微(涉及排序、Top-K 截断、业务逻辑,没法反传梯度);(2) 多目标 + 护栏(要在 engagement / diversity / 长期留存间权衡,且次要指标不能跌破 baseline);(3) 每次动模型就得全局重调,且目标本身还随产品策略漂移。传统 AutoML/HPO 只会在预设数值空间里搜,缺乏「用自然语言理解业务目标 + 跨上下文推理」的能力。
关键 idea:把整条「配置优化工作流」交给一套 基于 Google Gemini 的五智能体系统 AgenticRecTune,并配一个会自我进化的 Skillhub。范式从「编辑模型代码 / 跑离线评估」转向 system-level orchestration + 直接优化线上指标——agent 不改模型,只当一个「主动控制器」去调线上系统的非可微胶水参数,用真实 A/B 结果(而非离线 proxy label)作为反馈信号,闭环地把 North Star 业务指标顶上去。
整体实现思路
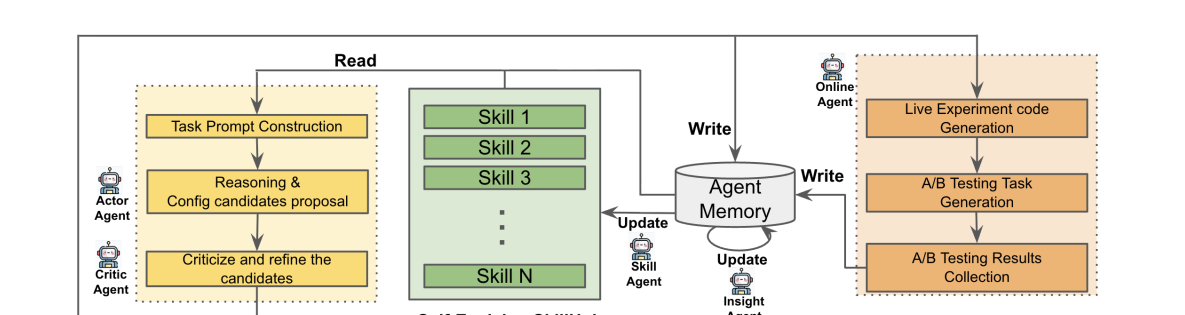
端到端是一个 propose → critic-filter → online A/B → insight → skill-update 的闭环(对应上图):
- 输入:一个待优化的「任务」(如 pre-ranking 的 value-based retrieval 分数融合、ranking 的 value fusion、re-ranking 的 diversity),其规格由 Skillhub 里对应的 skill 提供(任务上下文、参数定义、搜索空间、North Star 指标、当前线上 baseline 配置、领域知识、可调用工具)。
- ① Reasoning Loop(离线推理):
Task Prompt Construction从 Skillhub 取 skill + 从 Agent Memory 取历史 elite 配置,拼出结构化 prompt → Actor Agent 提出一批候选配置(带每个参数改动的解释)→ Critic Agent 按格式/护栏/历史失败案例过滤,选出最有希望的子集,写入 Agent Memory。 - ② Online Experiments(线上执行):Online Agent 把批准的候选配置自动翻译成生产基建要的可执行 code/script/config → 在 A/B 平台自动建实验(分流量、设对照组=线上现配置、设处理组=agent 提案、设达到统计显著的时长;上线前需人工 review)→ 实验结束调平台 API 收集 North Star 指标与显著性,回写 Agent Memory 对应任务项。
- ③ Self-Evolution(记忆与技能进化):Insight Agent 对历史结果做剪枝/去冗余、维护 Pareto「top performers」池、抽取「敏感参数 / 成功 mod 模式」;Skill Agent 把这些 insight 合成成可执行策略,追加到对应 skill 的 Domain Knowledge、收紧搜索空间边界,甚至合成全新 skill。更新后的 Skillhub 反哺下一轮 ① 的 prompt 构造。
整套形式化为一个多任务 Compositional Optimization(见子模块)。输出是:在各阶段上线、相比 baseline 统计显著正向的新配置集。
子模块实现(可复现细节)
0. 优化问题形式化(Multi-Level Compositional Optimization)
系统最终输出(展示给用户的排序列表)是三阶段函数复合:
F = f_re( f_rank( f_pre(x; w_pre, θ_pre), x; w_rank, θ_rank ), x; w_re, θ_re )
x:输入请求(用户画像、用户行为、上下文特征、初始大候选池)。w_*:各阶段模型权重(不动,由模型训练决定)。θ_pre, θ_rank, θ_re:各阶段系统级配置(agent 要调的东西,融合权重/阈值等)。- 联合配置向量
Θ = [θ_pre, θ_rank, θ_re] ∈ P,P是配置空间(系统更复杂可加更多分量)。
设 y_true 为用户真实隐式/显式反馈,M(F, y_true) = [M_1, ..., M_J] 为多个 North Star 指标(如总 DAU、engagement)。优化目标:最大化主指标之和,约束次要(护栏)指标不跌破 baseline b_j,且系统成本受限:
Θ* = arg max_{Θ∈P}  E_{(x,y_true)~D} [ U( M( F(x; w, Θ), y_true ) ) ]
其中  U(M) = Σ_{i=1..n} M_i(F, y_true)              # 主指标求和
s.t.  M_j(F, y_true) ≥ b_j   ∀ j ∈ {n+1, ..., J}    # 护栏约束
      E_{x~D}[ C(Θ) ] ≤ C_max                       # 系统成本约束
难点:F(x;Θ) 含排序/Top-K 截断/业务逻辑 → 非可微,没法梯度优化 → 这正是要用 LLM agent 推理 + 线上 A/B 黑盒反馈来搜的原因。
1. Actor Agent — 候选配置提案
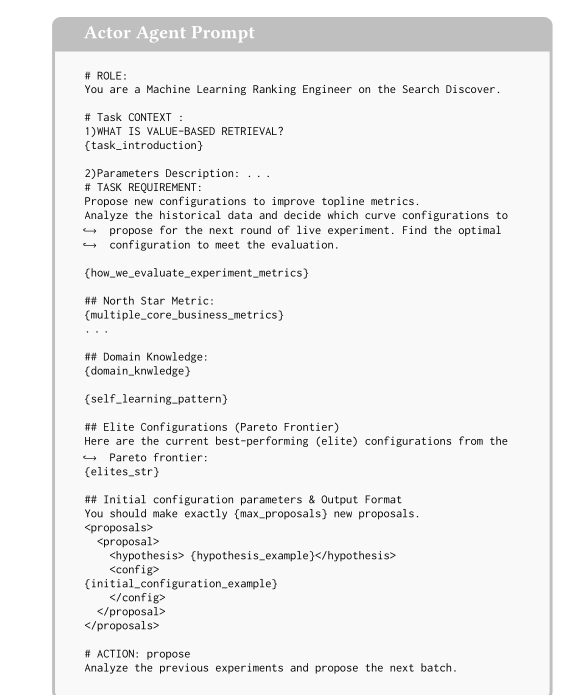
- 输入:
Task Prompt Construction拼好的结构化 prompt(上图模板),含# ROLE(如「Search Discover 上的 ML Ranking Engineer」)、Task CONTEXT(任务说明 + 参数定义)、TASK REQUIREMENT、{how_we_evaluate_experiment_metrics}、## North Star Metric、## Domain Knowledge(注入{self_learning_pattern}自学到的模式)、## Elite Configurations (Pareto Frontier)(从 Agent Memory 读到的当前最优配置{elites_str})、## Initial configuration parameters & Output Format。 - 算法:Gemini 推理,提出 恰好
{max_proposals}个新候选,对敏感参数重点调整;每个提案输出<proposal><hypothesis>...</hypothesis><config>...</config></proposal>,并给出每个参数改动的逻辑解释(保证探索可解释、扎根于任务目标/领域知识/历史数据)。 - 可控性:用户可动态注入参数(如候选 batch size、日志目录)以适配当前系统约束。
- 输出:一批 XML 格式的候选配置 + 假设 + 解释。
2. Critic Agent — 过滤与精修
- 输入:Actor 的原始 prompt + 原始 response(候选集)。
- 算法(prompt 见论文 Prompt 4.1.3):扮演「Discover feed ranking 实验评估专家」,按四步精修——(1) Validity Checks(无 typo、符合原 prompt 意图);(2) Alignment with Goals(逐条对照 Optimization Objectives 与指标优先级);(3) Assess Explanation(每个 config 改动的
<explanation>是否逻辑自洽、与参数描述一致);(4) Selection(选出多样且最有希望的{max_proposals}个,显式避免选互相太像的策略)。输出 XML<proposals>,并为每个入选项新增<justification>说明为何被选(引用其对指标的潜在影响 + 假设强度)。同时对照系统护栏、指令约束、已知历史失败案例过滤。 - 作用:在昂贵的线上实验前剔除次优/越界提案,缓解 LLM「幻觉」,提升闭环稳定性与收敛性。
- 输出:精修后的候选子集 + 反馈评论,写入 Agent Memory。
3. Online Agent — 自动起 A/B 并回收结果
- 3.1 Online Experiment Code Generation:把抽象参数值翻译成生产基建要的可执行 code/script/config 文件(遵守 skill 里的 restriction)。
- 3.2 A/B Testing Task Generation:在生产 A/B 平台自动建实验——分配流量百分比、定义对照组(baseline 配置)vs 处理组(agent 提案)、设达到统计显著的时长。上线前需用户 review。
- 3.3 A/B Testing Results Collection:实验结束调平台 API 收集 North Star 指标与统计显著性,回写 Agent Memory(更新对应 task 的 JSON),为下一轮 prompt 构造与 Skillhub 进化提供 ground-truth。
4. Agent Memory — 多智能体共享记忆
- 数据结构:每个 task item 字段 =
id name, config string, explanation, proposed time, status, results, evaluation check info。Critic 经 Write 写入精修候选;Online Agent 实验后追加 results;下一轮 Actor 在 prompt 里读 elite task item。 - 4.2 Pruning & Selection:Insight Agent 定期剪冗余日志;按线上表现 + 类别多样性排序,维护「top performers」池,丢弃被严格支配(strictly dominated)的候选,只留无人能在所有指标上全面胜过的 elite(≈ Pareto 前沿),保持记忆精简高性能。
- 4.3 Diversity Maximization:先对每个候选的所有结果做标准化(避免大数值尺度指标主导),再用贪心策略——选一个强起点,迭代地选「在数学距离上离已选集合最远」的候选,防冗余。
5. Self-Evolving Skillhub — 技能库与自进化
Skill = 插件,每个 skill 针对一个具体任务,含 6 个组件:
- Task Context:生产/推荐系统背景 + 指明优化哪个组件(如 pre-ranking 配置或 diversity 参数)+ 每个参数的精确定义与作用。
- Task Requirement:约束与期望输出(允许的搜索空间/取值范围、部署配置的 JSON schema、基建约束)。
- North Star Metric:主优化目标 + 次要指标 + 各指标优先级与方向(增/减)。
- Initial configuration parameters:当前线上 baseline 配置(探索的锚点与起点)。
- Domain Knowledge:任务专属启发式 + 历史日志 + 专家经验(如「过度增大 diversity penalty 会拖累 engagement」),用于收窄搜索空间、防灾难性配置;Skill Agent 会自动往这里追加学到的知识。
- Tools:执行函数(部署配置到 A/B 平台的 API、查实验结果、做统计显著性分析)。
自进化的两类机制(Insight Agent 学 + Skill Agent 写):
Insight Agent 的 Pattern Learning 两种方式:
- Self-Learning:持续吃自己的日志/推理轨迹/结果,搜「常见成功 mod 与配置差异」,检出跨迭代影响最大的敏感参数,从单任务抽主指标模式(如「激进增大某 diversity penalty 持续拖累 engagement」→ 抽成新 pattern)。
- Cross-Learning:用 MapReduce 策略——并行从多任务学主指标模式(Map)+ 全局综合(Reduce),涉及文件都登记在 memory。
Skill Agent 据此自进化:
- 4.4.1 Dynamic Knowledge Extraction:Insight 完成 self/cross-learning 后,Skill Agent 识别与某 skill 相关的 pattern,自动追加到该 skill 的 Domain Knowledge,并动态收紧 Task Requirement 里的搜索空间边界,让推理循环避开已知次优区。
- 4.4.2 Novel Skill Generation:不止追加 insight,还利用积累记忆 + 现有技能集合成全新 operational skill(主要更新 domain knowledge 段),无需人工手写新 skill;工程师也能显式追踪学到的 pattern。
→ Skillhub 从「静态指令」变成「学习引擎」:新提案在进真实实验前先被过往经验引导。
实验设置与结果
部署平台:Google Discover(大规模多媒体内容推荐)。线上 A/B:用户流量随机分到正交 bucket,对照组=线上现有调优配置,处理组=AgenticRecTune 生成配置;按标准 launch period 跑到统计显著(p < 0.05)。覆盖 pre-/ranking/re-ranking 三阶段,各取一个代表任务。
主结果(Table 1,线上 A/B 三阶段 × 三类 topline 指标增益):
| Task | Stage | Engagement Metric 1 | Engagement Metric 2 | Diversity Metric |
|---|---|---|---|---|
| Value-Based Retrieval | Pre-Ranking | +0.75% | +0.90% | +0.48% |
| Value Fusion | Ranking | +0.62% | +0.19% | +0.06% |
| Diversity | Re-Ranking | +0.21% | +0.29% | +3.43% |
三阶段全部统计显著正向;re-ranking 的 diversity 任务在不触发短期 engagement 下跌的前提下把多样性顶了 +3.43%,且发现了工程师人工调参容易漏掉的参数交互。
Ablation 1 — 底座 LLM(Table 2,re-ranking diversity 任务):
| Model | Engagement Metric 1 | Engagement Metric 2 | Diversity Metric |
|---|---|---|---|
| Gemini 3 Pro | +0.21% | +0.29% | +3.43% |
| Gemini 3 Flash | +0.08% | +0.07% | +1.69% |
| Gemini 1.5 Pro | +0.22% | +0.27% | +2.11% |
结论:模型规模/代际显著影响 agent 表现,Gemini 3 Pro 综合最均衡(diversity 最强);Flash 虽省算力但全面最弱 → 高参数推理能力对在搜索空间里导航是必要的。
Ablation 2 — Agent 策略(Table 3,Value-Based Retrieval 任务):
| Strategy | Engagement Metric 1 | Engagement Metric 2 | Diversity Metric |
|---|---|---|---|
| Actor-Critic Strategy | +0.75% | +0.90% | +0.48% |
| Single Agent Strategy | +0.29% | +0.26% | +0.06% |
结论:Actor-Critic 比单 agent 在 engagement 上的增益翻倍还多;Critic 的迭代反馈有效抑制优化过程的「幻觉」、逼出更严谨的候选选择。注意 diversity 提升幅度相对温和(+0.48%)——双 agent 的主要收益在于「精修精度」而非单纯扩大探索广度。
思考与可参考价值
局限:(1) 指标全部脱敏为 Metric 1/2/Diversity,没有绝对量级与置信区间,外部难判断收益体量;(2) 缺与传统 AutoML/grid search/贝叶斯优化在同任务同预算下的 head-to-head,「比网格搜索更高效」是定性论断;(3) 强依赖 Gemini 3 Pro 量级模型,小模型明显掉点,成本/延迟未讨论;(4) 三阶段各只测一个任务、样本量小,且 A/B 起停仍需人工 review,非完全无人闭环;(5) Skillhub 自进化缺定量消融(去掉 self-evolution 掉多少没给)。
对电商 / 搜推 / Agent 方向的可借鉴点(与「Agent 优化电商/推荐系统自迭代」高度契合):
- 直接对标用户在做的方向:这篇把「推荐系统级配置调优」交给 Actor-Critic-Online 多智能体 + 自进化 Skillhub 自动闭环,正是「Agent 优化电商/推荐」的工业落地范本。其 propose → critic-filter → online A/B → insight → skill-update 闭环可几乎照搬到 SEO 推词配置自优化 / 推荐融合权重自调 的 agent 上。
- Actor-Critic 分工值得直接抄:Actor 负责广度提案、Critic 在昂贵线上实验前做格式/护栏/历史失败案例过滤,是控制 LLM 幻觉成本的关键工程模式——任何「LLM 提案 → 上线试」的自迭代系统都应加这一层守门。
- Self-Evolving Skillhub 是记忆架构的好模板:把「技能」拆成 Task Context / Requirement / North Star / 初始配置 / Domain Knowledge / Tools 六件套,且只让自进化写 Domain Knowledge + 收紧搜索空间(而非乱改结构),既能积累经验又稳;配 Pareto「严格支配剪枝 + 标准化贪心多样性选择」维护 elite 池,可直接迁移到自家优化 agent 的长程记忆设计。
- 以真实线上 A/B 作 reward、绕开离线 proxy:对非可微「胶水参数」(融合权重、阈值、SEO 出词策略权重),离线指标常与线上 North Star 错位;用 agent 直接对线上多目标 Pareto 前沿优化、护栏约束次要指标,是比离线调参更对齐业务的思路。
- 底座模型选型提示:这类需要复杂推理的优化 agent,用旗舰推理模型(Gemini 3 Pro 级)收益明显高于 Flash 级,做自迭代系统时别为省成本上太小的模型。