AgenticRec: End-to-End Tool-Integrated Policy Optimization for Ranking-Oriented Recommender Agents
Xiamen University
把推荐 agent 的 "想 → 调工具 → 输出排序列表" 整条 ReAct 轨迹用 list-wise GRPO(reward = NDCG@K)端到端训练并证明梯度无偏;再叠一个 Progressive Preference Refinement 阶段,自挖 ranking 违例做硬负样本对、用 bidirectional preference 双向打磨,把 pairwise 排序误差的凸上界压紧。
论文正式名(PDF 内):AgenticRec: A Recommendation-Oriented Agentic Framework with Progressive Tool-Integrated Reasoning Optimization。Qwen3-4B-Instruct-2507 backbone,Amazon Reviews 2023 四个垂类,代码匿名仓
anonymous.4open.science/r/AgenticRec-FB16。
核心思路
一句话问题:现有 LLM 推荐 agent(RecMind / InteRecAgent 等)的「Think → Act(调工具) → Recommend」轨迹是靠通用语言先验或 prompt 启发式驱动的,中间的工具调用与推理过程从不被最终的 ranking feedback 优化(misalignment);而且只用 list-level 的粗监督,搞不定 top 几个高度混淆候选之间的细粒度偏好边界(在 implicit feedback 这种稀疏信号下尤其明显)。
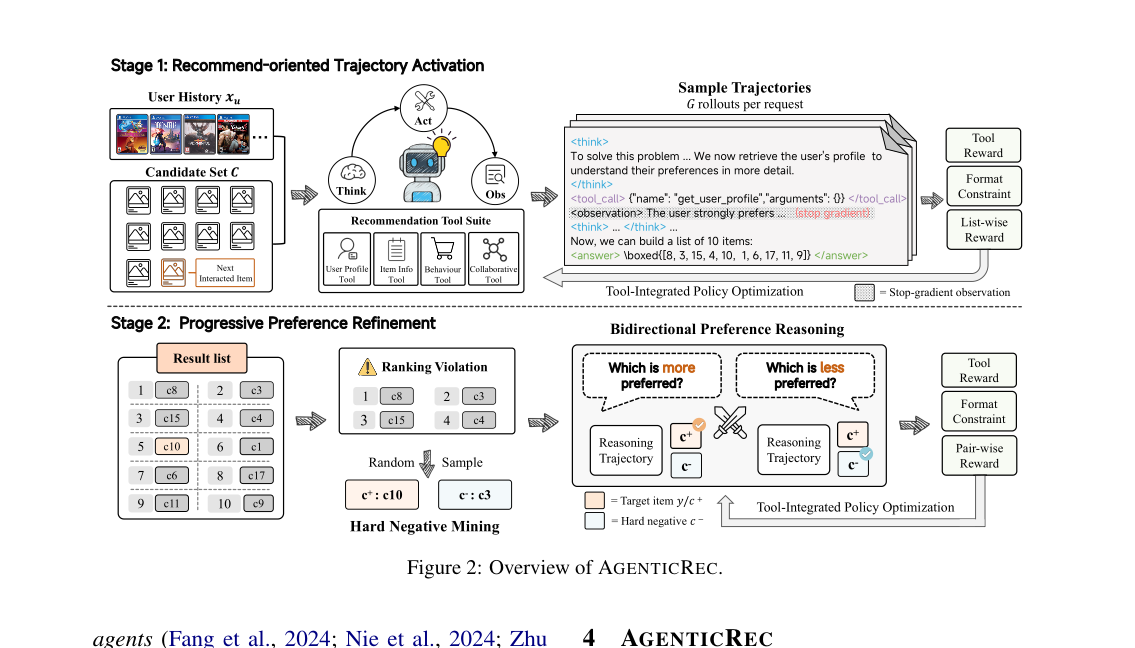
关键 idea / 范式:把推荐建模成一个「工具增强推理(Tool-Integrated Reasoning, TIRR)」的 ReAct 闭环,配一套推荐专用工具(用户画像 / 物品信息 / 行为统计 / 协同信号),然后用两阶段 RL端到端训练这条轨迹:
- RTA(Recommendation-Oriented Trajectory Activation):用 list-wise GRPO,把 NDCG@K 当 trajectory-level reward 沿整条「think + tool-call + 最终排序」回传(observation token 做 stop-gradient),让「何时调工具 / 调哪个 / 证据怎么回写到排序」全部 outcome-driven;
- PPR(Progressive Preference Refinement):从 stage-1 模型自己的 ranking 违例里自挖 hard negative 对
(c⁺, c⁻),用 bidirectional preference reasoning(同一对既问”哪个更可能选”又问”哪个更不可能选”)做 pair-wise GRPO,把 pairwise ranking error 的凸上界压紧。
论文给了两条 proposition:(1) RTA 的 GRPO 梯度对 list-wise 目标方向无偏;(2) PPR 的双向偏好损失是 0-1 排序误差的凸上界(logistic loss)。
整体实现思路
端到端 pipeline(见下图):输入是用户交互历史 xᵤ = [v₁,...,vₜ](最长 10 条)+ 候选集 C = {c₁,...,c₂₀}(1 正 + 19 随机负),要求输出 top-10 排序列表 rₖ。
- 推理框架(TIRR):ReAct 闭环
Think₁ → Act₁ → Obs₁ → ... → Rec。模型在<think>里推理,在<tool_call>里发 JSON 工具调用,工具返回写进<observation>,最终答案放在<answer>\boxed{[8,3,15,...]}</answer>。单条轨迹最多 10 次工具交互(latency budget)。 - Stage 1 RTA:每个样本采 G=8 条 rollout,reward = NDCG@K(命中且合法)/ −0.5(合法但目标 y 不进 top-K)/ −1(格式错),Hit@1 且至少调一次工具再 +0.1 bonus;advantage = 组内 reward 减组均值(GRPO),整条 trajectory 的 log-prob 一起求梯度,observation token stop-gradient;借鉴 DAPO 把「整组全负奖励」的样本动态丢弃。训 3 epoch。
- Stage 2 PPR:拿 stage-1 模型在训练集上跑出的排序,凡是正样本没排第一就算 ranking violation,从「排在
c⁺之前的 item」里随机采 1 个当c⁻,组成硬对;对每对生成正/反两个二分类任务(MORE / LESS likely),用 binary 0/1 reward 的 pair-wise GRPO 再训 1 epoch。
子模块实现(可复现细节)
1. 推荐工具套件(4 类,tool-agnostic 可扩展)
| 工具 | 调用名 | 输入 → 输出 | 实现 |
|---|---|---|---|
| User Profile | get_user_profile | 无参 → 一段 LLM 预生成的用户画像(偏好品类/长期兴趣) | 用 backbone 同款 Qwen3-4B-Instruct-2507 离线对「样本时间戳之前的历史」预生成画像 |
| Item Information | item_info_search / candidates_analyze | item_name → 类目/价格/评分/热度;无参 → 按类目或价格聚合的候选概览 | 查 dataset item metadata;候选分析做双粒度(单品细节 + 列表组成) |
| Behavioral Statistics | get_session_behavior / get_rating_behavior | 无参 → 近期 session 兴趣演化;按高/中/低评分分组的物品 | 对 metadata 字段算统计摘要,把人工特征工程变成 agentic 过程 |
| Collaborative | get_similar_items / get_similar_users | item_title → I2I 相似物品;无参 → U2U 相似用户近期购买 | 在训练集上跑 SASRec 建 embedding 空间做协同检索 |
2. RTA — Reward 设计(Eq. 1)
- Recommendation reward:
R_rec(r_K, y) = NDCG@K(r_K; y)—— 把真实交互物品 y 在排序列表里的 NDCG 当奖励,直接对齐 ranking 目标与偏好信号(y= ground-truth next item,唯一正样本)。 - Format constraint:非法 item / 非法工具 / 格式错 → −1,强约束输出可执行。
- Tool-call bonus:算完
R_rec后,若Hit@1且N_tool(τ) > 0(τ 中工具调用次数 > 0)再 +0.1,鼓励用工具但只奖励高质量轨迹以防 reward hacking。 - Tool-call budget:单 τ 最多 10 次工具交互,超了算 invalid → 吃 −1。
3. RTA — 策略优化(GRPO + 动态采样)
GRPO 估计量(Eq. 6):对每个 instance 采 G 条 rollout {τ⁽ᵍ⁾},
baseline b 是包含自身的组均值(inclusive group-average)。轨迹 τ 覆盖整条 think + Act(工具) + Obs + 最终 ranking,observation token 做 stop-gradient(工具返回的内容不回传梯度,只回传模型自己生成的 think / act / rank token)。动态采样:整组 rollout 全是负奖励的样本直接 drop(DAPO 思路),避免早期噪声更新。
Proposition 1(梯度方向无偏):用 inclusive group-average baseline,E[∇Ĵ_GRPO] = (G−1)/G · ∇J(θ)。证明用 E_τ[∇log π_θ(τ)] = 0(score function 期望为零),baseline 因含自身那项不完全抵消,最终只引入正缩放因子 (G−1)/G(G>1 时恒正),相当于学习率衰减、不改变优化方向 → 保证「高质量 ranking 的 credit 能正确回传到具体的中间推理和工具调用步骤」。
4. PPR — Hard Negative Mining(Eq. 3)
对每个 (xᵤ, C),正样本 c⁺ = y。stage-1 模型出 r_K 后,若 c⁺ 没排第一即「ranking violation」。硬负池:
即「排在 c⁺ 之前的 item」;若 c⁺ 根本不在 top-K,就用整个 top-K 当池。不取最难的 top-1,而是随机采 1 个 c⁻ 组成 (c⁺, c⁻) —— 增加负样本多样性、避免过度对抗导致模糊监督。无需额外标注,只靠 implicit feedback。
5. PPR — Bidirectional Preference Reasoning(Eq. 4)
同一对 (c⁺, c⁻) 在同一用户上下文下拆成两个对称任务:
- Positive direction:问「用户更可能选哪个」→ 目标
c⁺_⋆ = c⁺; - Negative direction:问「用户更不可能选哪个」→ 目标
c⁻_⋆ = c⁻,逼模型显式找出c⁻相对用户历史的 mismatch / 短板,而不是把它当背景非正样本。
两方向共享 prompt 结构(PPR prompt 模板里 [MORE / LESS] LIKELY,输出 \boxed{A} 或 \boxed{B}),reward 换成二元 pair-wise:
其余 reward 分量(format / tool budget)保持不变。
Proposition 2(误差上界最小化):定义打分差 Δs = s(c⁺) − s(c⁻),排序错误即 Δs < 0(离散 0-1 损失 L₀₋₁ = I(Δs<0) 不可导)。双向任务的组合损失正比于
(因为 P_pos = e^{s(c⁺)}/(e^{s(c⁺)}+e^{s(c⁻)}),而 P_neg「拒绝 c⁻」化简后等于同一个 sigmoid)。这是 logistic loss,是 0-1 排序误差的凸光滑上界(2log(1+e^{-Δs}) ≥ 2log2·I(Δs<0)),在 Δs≪0 时仍有非零梯度 → 专挖 Δs<0 的硬对训练即最小化经验 pairwise 错误率,sharpen 偏好边界。
6. 关键超参(Appendix C.3)
| 项 | 值 |
|---|---|
| Backbone | Qwen3-4B-Instruct-2507 |
| Stage1 / Stage2 epoch | 3 / 1 |
| Group size G | 8 |
| 最大生成长度 | 6,144 |
| batch size | 64 |
| learning rate | 1e-6 |
| rollout temperature | 0.6 |
| 工具调用上限 / 轨迹 | 10 |
| 候选集 / 历史长度 | 20(1 正 + 19 负)/ 最长 10 |
| 硬件 | 4× A800 80GB(推理 vLLM) |
实验设置与结果
数据集:Amazon Reviews 2023 四子集 —— CDs / Instruments / Office / Games,限定 2022.10–2023.10,按时间 8:1:1 切分。采负样本时排除历史交互物品并打乱候选顺序(去位置偏置)。
| Dataset | #Users | #Items | #Inters. | Sparsity |
|---|---|---|---|---|
| CDs | 5,437 | 8,785 | 13,826 | 99.71% |
| Instruments | 7,593 | 5,279 | 15,746 | 99.61% |
| Office | 27,130 | 11,511 | 47,333 | 99.85% |
| Games | 6,251 | 3,003 | 11,457 | 99.39% |
指标:NDCG@K(N@K)/ HitRate@K(H@K),K∈{1,5,10},看真实购买物品在 top-10 里的命中与排序。
Baseline:传统序列推荐(Caser / GRU4Rec / SASRec / ReaRec);training-free LLM(LLMRank、InteRecAgent,用 GPT-4);可训 LLM(TALLRec / LLaRA / S-DPO / ReRe,统一 Qwen3-4B backbone,lr 1e-5)。
主结果(Table 1,节选最强 baseline 对比)
| Model | CDs H@1 | CDs N@5 | CDs N@10 | Games H@1 | Games N@5 | Games N@10 |
|---|---|---|---|---|---|---|
| SASRec | 0.0536 | 0.1413 | 0.2145 | 0.1535 | 0.2762 | 0.3234 |
| InteRecAgent | 0.0782 | 0.1660 | 0.2392 | 0.1782 | 0.3009 | 0.3477 |
| LLaRA | 0.2324 | 0.3736 | 0.4394 | 0.2763 | 0.4588 | 0.4952 |
| ReRe | 0.2073 | 0.3371 | 0.4080 | 0.2921 | 0.4473 | 0.4976 |
| AgenticRec | 0.2992 | 0.4795 | 0.5324 | 0.3282 | 0.4887 | 0.5445 |
四数据集 20 列指标里 AgenticRec 拿下 19 列 SOTA。CDs H@1 0.2992(vs LLaRA 0.2324,+28.7%),Games H@1 0.3282(vs ReRe 0.2921,+12.4%)。值得注意:training-free 的 InteRecAgent(带工具但不训)甚至打不过可训的 LLaRA,印证「工具不端到端训会引入噪声」。
消融(Table 2:R = 纯 LLM 推理,TIRR = 带工具推理)
| Data | Setting | Variant | H@1 | H@5 | N@5 |
|---|---|---|---|---|---|
| CDs | Frozen | R | 0.1907 | 0.4696 | 0.3303 |
| CDs | Frozen | TIRR | 0.2331 | 0.5476 | 0.3955 |
| CDs | Trained | R | 0.2324 | 0.5399 | 0.3865 |
| CDs | Trained | TIRR (RTA) | 0.2837 | 0.6162 | 0.4606 |
| CDs | Trained | TIRR (RTA+PPR) | 0.2992 | 0.6472 | 0.4795 |
| Instr. | Frozen | R | 0.1973 | 0.5613 | 0.3818 |
| Instr. | Frozen | TIRR | 0.1948 | 0.5277 | 0.3673 |
| Instr. | Trained | TIRR (RTA+PPR) | 0.2586 | 0.6115 | 0.4393 |
关键结论:① Frozen 设置下 TIRR 不一定胜 R(Instruments/Office 上 TIRR 反而更差)—— 不训练时工具调用纯靠语言先验,会调出噪声证据;② Trained 后 TIRR 一致胜 R(CDs 0.2324→0.2837)—— 工具必须端到端训才有用;③ PPR 在 RTA 之上再涨一档(CDs H@1 0.2837→0.2992)。
训练动态与 scaling
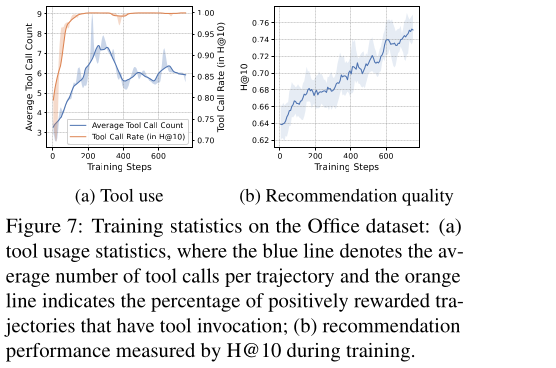
- 工具使用学习:正奖励轨迹的 tool-call rate 早期迅速逼近 100% 并保持;平均调用次数从 ~3 缓涨到 ~8 后稳定(学到稳定策略而非滥调);与 H@10 同步上升。
- PPR 训练(Games):PPR 测试集偏好判断准确率 +26.3%(0.190→0.240),同时最终推荐 H@1 +12.5%(0.292→0.328)—— 双向偏好能力可迁移到最终排序。
- Scaling:Qwen3 1.7B → 4B → 8B 全指标单调上升。
- Group size:G 2→4→8 性能提升但渐饱和,中等 G 是稳定性/效率折中。
- Latency:单 A800 + vLLM,每请求平均 16–21s,工具时间仅 0.01–0.02s(agent 推理为主,论文定位于交互式/推理密集场景而非毫秒级实时排序)。
- Token cost:AgenticRec(含 Think/Act/Obs/Rec)相比 Naive LLM 仅小幅上涨(如 CDs 2595→2708,Games 3074→3663),可控。
思考与可参考价值
局限:① 只在 Qwen3-4B + Amazon 4 垂类做,跨 backbone / 真实工业流量未验证(论文 limitation 自承没上 72B);② 候选集仅 20,离工业 hundreds-to-thousands 候选的真实 ranking 还远;③ 4 类工具手工设计、固定数量,“tool-agnostic” 在工具变多/有噪声时的稳定性没测;④ Hit@1+用工具的 +0.1 bonus 是 reward shaping,“为拿 bonus 而调工具” 的 hacking 倾向未专门分析;⑤ 只有 NDCG/H@K 一族 offline 指标,无 CTR/GMV/留存等业务验证;⑥ PPR 依赖 base 模型已有一定 LLM-as-a-Judge 自评能力,更小模型起步可能失败。
对电商 / 搜推 / Agent 方向的可借鉴点:
- 「list-wise reward 接 GRPO 整条 trajectory」是一个干净可迁移的范式——任何「中间推理 + 工具调用 + 最终输出排序列表」的 agent(电商搜索重排、生成式推荐、多路召回融合)都能套:把业务 ranking metric 当 trajectory-level reward,observation 做 stop-gradient,DAPO 式丢全负组。这是把 R1 风格 GRPO 真正落到推荐 agent 的一个代表作。
- Bidirectional Preference Reasoning 是近乎零成本的工程 trick:同一对硬负样本正向问「更喜欢哪个」、反向问「更不喜欢哪个」,逼模型显式 articulate 负样本的 mismatch,可零成本插进任何 pairwise/DPO 风格的偏好训练。理论上还有「等价于 logistic loss、是 0-1 误差凸上界」的支撑。
- 从 ranking 违例自挖 hard negative 比全局采负更精细:用模型自己的错误(排在正样本之前的 item)做硬负,随机采而非取最难,平衡难度与稳定性 —— 适用任何 ranking 任务的难例挖掘。
- 「工具必须端到端训才不引入噪声」的消融很有指导意义:frozen 下带工具反而掉点,提醒在落地 agent 推荐/搜索时,不要直接 plug 一堆工具靠 prompt 启发式,而要把工具调用纳入 outcome-driven 的 RL 优化。
- 下一步值得做:候选集拉大到 100+、工具带真实噪声、reward 里塞真实转化信号(不止 NDCG,加 CTR/GMV),以及 self-evolving recommender agent(论文 future work)。