Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
Mem0 (mem0.ai)
把「长对话记不住」从「把上下文窗口撑大」重新定义为「增量抽取 + 冲突消解 + 选择性检索」的记忆工程问题。Mem0 用两阶段流水线:extraction 阶段拿「异步刷新的全局摘要 + 最近 m 条消息 + 新消息对」当 prompt,LLM 抽出候选事实;update 阶段对每条候选事实召回 top-s 相似记忆,让 LLM 通过 function call 自己裁决 ADD / UPDATE / DELETE / NOOP——不训分类器,直接用推理能力做记忆管理。Mem0^g 再加一层有向标注图(实体为点、关系为边、节点带 embedding 和时间戳),检索时走「实体锚定子图 + 语义三元组匹配」双通道。LOCOMO 上 Mem0 综合 J=66.88%、Mem0^g=68.44%,超 Zep(65.99)、OpenAI memory(52.90)、最好的 RAG(60.97);相对 full-context 的 72.90% 只差 4.5pt,但 p95 总延迟从 17.1s 降到 1.44s(−92%),记忆存储只占 7k/14k token 对比 Zep 的 600k+。
核心思路
问题:LLM 的上下文窗口是固定的,跨 session 的长期对话必然溢出。而且把窗口做大(128K / 200K / 10M)只是延后问题,不解决问题——真实对话根本没有主题连续性:用户先说自己吃素,然后聊几小时代码,再回来问晚饭吃什么。full-context 方案要在几万 token 的编程讨论里翻出那句「我吃素」,而 attention 对远距离 token 本来就衰减。
关键 idea:不要存对话,存从对话里抽出来的事实,并且在写入时就做冲突消解。Mem0 的两个核心设计:
- 增量的 extraction → update 两阶段流水线:每来一对消息就抽事实,抽完不是直接落库,而是先召回语义相似的老记忆,让 LLM 通过 function call 决定这条新事实是 ADD / UPDATE / DELETE / NOOP。用 LLM 的推理能力直接当记忆管理器,不额外训分类器。
- Mem0^g:在自然语言记忆之上再叠一层有向标注图,实体为节点、关系为边,节点带 embedding + 类型 + 创建时间戳。冲突关系不物理删除而是标记为 invalid,保留时间线。
值得注意的一个概念区分:论文把「memory」定义成压缩后的显著事实,而不是 RAG 那种「原文 chunk」。这是它相对 RAG 拿到 +10~12% 相对增益的根源——chunk 里塞着大量噪声,而记忆是去噪后的结论。(也正是这一点被后来的 APEX-MEM 反过来批评:写入时 consolidate 会把时序演化史一起丢掉。)
整体实现思路
Mem0(基础版)
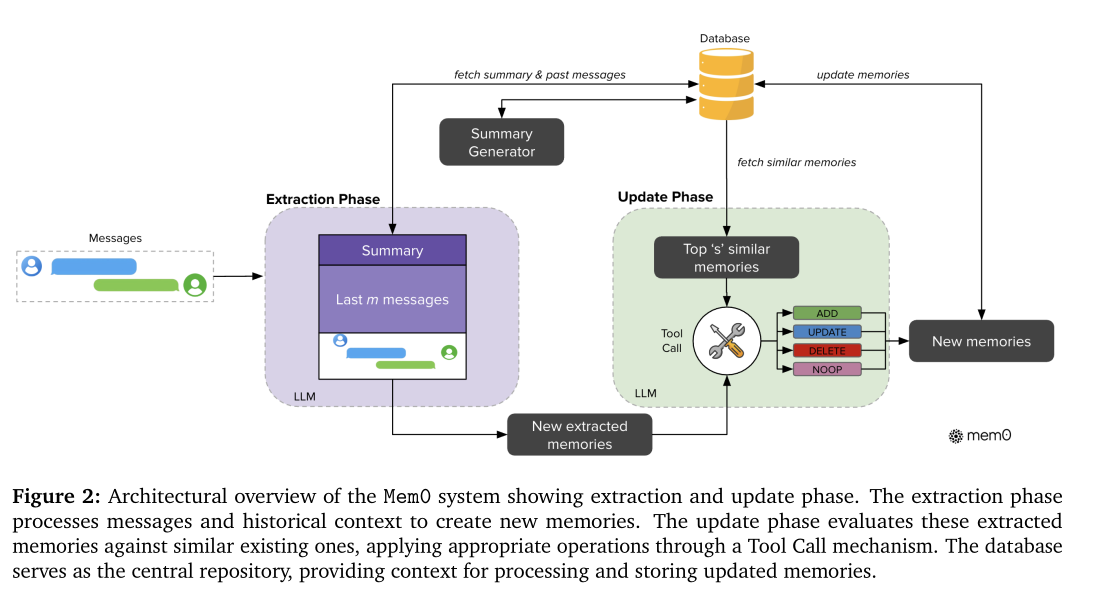
端到端数据流:
新消息对 (m_{t-1}, m_t)
   │
   ├── 全局摘要 S ← [异步 Summary Generator,独立于主链路周期性刷新]
   ├── 最近 m 条消息 {m_{t-m}, ..., m_{t-2}}   ← DB
   ↓
拼成 prompt P = (S, {m_{t-m},...,m_{t-2}}, m_{t-1}, m_t)
   ↓  φ = LLM 抽取函数
候选事实集 Ω = {ω_1, ..., ω_n}
   ↓  对每个 ω_i
向量检索 top-s 相似已有记忆
   ↓  LLM tool call 裁决
ADD / UPDATE / DELETE / NOOP  →  执行 → 更新 DB
两个上下文源是互补的:摘要 S 给全局主题理解,最近 m 条消息给细粒度时间上下文(那些还没被 consolidate 进摘要的细节)。摘要生成走异步旁路——这是工程上的关键选择,主链路不会被摘要 LLM 调用拖慢。
Mem0^g(图增强版)
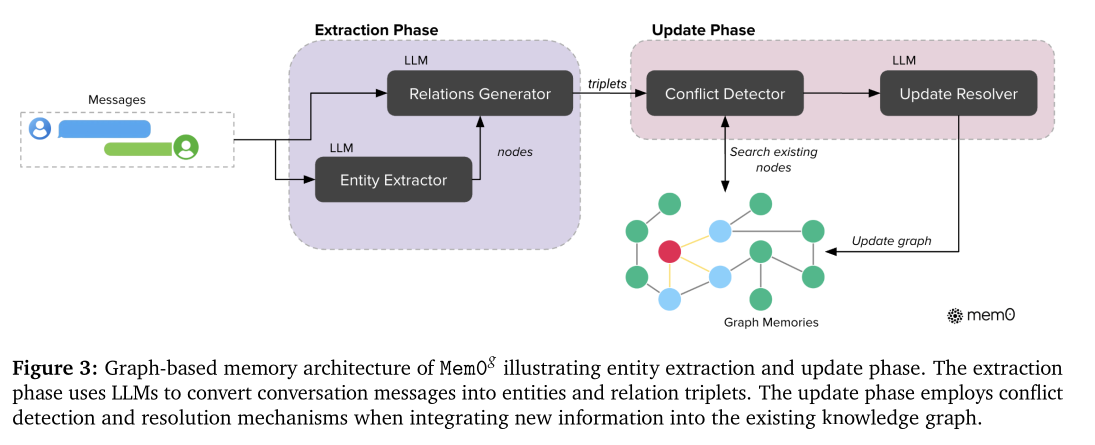
四个 LLM 模块串成两阶段:extraction 阶段 Entity Extractor(出 nodes)→ Relations Generator(出 triplets);update 阶段 Conflict Detector(搜已有节点,判冲突)→ Update Resolver(决定哪些旧关系作废)。图存 Neo4j。
子模块实现(可复现细节)
模块 1 — Extraction(抽取阶段)
| 项 | 内容 |
|---|---|
| 输入 | 消息对 (m_{t-1}, m_t)(通常是 user 消息 + assistant 回复,构成一个完整交互单元) |
| 额外上下文 | 全局摘要 S + 最近 m 条历史消息 |
| Prompt | P = (S, {m_{t-m}, ..., m_{t-2}}, m_{t-1}, m_t) |
| 输出 | 候选事实集 Ω = {ω_1, ω_2, ..., ω_n},自然语言表述 |
| 超参 | m = 10(recency window) |
| 模型 | GPT-4o-mini(全部 LLM 操作统一用它) |
要点:抽取只针对新的这一轮交换产生事实,但是在整段对话的语境感知下做——所以指代消解、隐含信息能被正确展开。
模块 2 — Asynchronous Summary Generator
独立于主流水线的旁路组件,周期性重刷会话摘要 S 并写回 DB。不阻塞主链路,保证抽取总能拿到较新的全局语境而不引入延迟。论文没给刷新频率的具体值。
模块 3 — Update(更新阶段,Algorithm 1)
对每条候选事实 ω_i:向量检索 top-s 相似记忆(s = 10),把「候选事实 + 检索到的记忆」一起给 LLM,通过 function-calling 接口(论文称 tool call)返回四选一操作:
function ClassifyOperation(f, M):
    if ¬SemanticallySimilar(f, M):  return ADD      # 新信息,库里没有
    elif Contradicts(f, M):         return DELETE   # 与已有记忆矛盾
    elif Augments(f, M):            return UPDATE   # 补充已有记忆
    else:                           return NOOP     # 已存在 / 不相关

procedure UpdateMemory(F, M):
    for each fact f in F:
        op = ClassifyOperation(f, M)
        if op == ADD:
            id = GenerateUniqueID();  M ← M ∪ {(id, f, "ADD")}
        elif op == UPDATE:
            m_i = FindRelatedMemory(f, M)
            if InformationContent(f) > InformationContent(m_i):   # 只在更丰富时才替换
                M ← (M \ {m_i}) ∪ {(id_i, f, "UPDATE")}
        elif op == DELETE:
            m_i = FindContradictedMemory(f, M);  M ← M \ {m_i}
        elif op == NOOP:
            pass
    return M
设计要点:UPDATE 有个信息量守卫 InformationContent(f) > InformationContent(m_i)——只有新事实更丰富时才替换,防止把详细记忆退化成粗略版本。另外注意基础版 Mem0 的 DELETE 是物理删除(M \ {m_i}),这是它时序推理能力的上限所在。
模块 4 — 图定义与实体节点(Mem0^g)
记忆表示为有向标注图 G = (V, E, L):
- 节点 V = 实体(
Alice、San_Francisco) - 边 E = 关系(
lives_in) - 标签 L = 节点语义类型(
Alice → Person、San_Francisco → City)
每个实体节点 v ∈ V 三个组成部分:
- 实体类型分类(Person / Location / Event / …)
- embedding 向量
e_v(语义匹配用) - metadata,含创建时间戳
t_v
关系是三元组 (v_s, r, v_d):源节点、标注边、目标节点。
模块 5 — 两阶段图抽取
① Entity Extractor:从输入文本识别实体及其类型。实体覆盖人、地点、物体、概念、事件、属性——判据是「语义重要性 / 唯一性 / 持久性」。
② Relations Generator:对抽出的实体两两评估是否存在有意义的关系,有则打标签(lives_in / prefers / owns / happened_on)。通过 prompt engineering 引导 LLM 同时推理显式陈述与隐含信息。
两个模块都用 GPT-4o-mini + function calling 做结构化抽取。
模块 6 — 图的存储、合并与冲突消解
新三元组入库流程:
- 对 source / destination 实体分别算 embedding
- 在图里搜语义相似度 > 阈值
t的已有节点 - 按命中情况分三种:都新建 / 只新建一个 / 复用两个已有节点,然后建带 metadata 的关系边
- Conflict Detector 识别与新信息潜在冲突的已有关系
- LLM-based Update Resolver 判定哪些旧关系应作废——标记为 invalid 而非物理删除,以支持时序推理
这里是 Mem0^g 与基础版 Mem0 的关键分歧:基础版 DELETE 真删,图版只标 invalid。这正好解释了实验里 Mem0^g 在 temporal 任务上 +2.62pt 的增益来源。
模块 7 — 双通道检索(Mem0^g)
| 通道 | 做法 | 适用查询 |
|---|---|---|
| Entity-centric | 先识别 query 中的关键实体 → 语义相似度定位图中锚点节点 → 系统性遍历该节点的入边和出边 → 构造相关子图 | targeted、实体聚焦型问题 |
| Semantic triplet | 整个 query 编码成 dense 向量 → 与图中每条关系三元组的文本编码算细粒度相似度 → 返回超过可配置阈值的三元组,按相似度降序 | 宽泛的概念性问题 |
两通道结果合并后作为上下文喂给答题 LLM。
模块 8 — 答题 prompt(Appendix A)
答题阶段的 prompt 有几条对复现很关键的指令:
- 「特别注意时间戳来确定答案」
- 「若记忆间矛盾,优先采信最新的记忆」
- 「把相对时间引用换算成绝对日期」——例:2022-05-04 的记忆里说「去年去了印度」→ 输出 2021
- 「答案控制在 5-6 词以内」(LOCOMO 的短答案格式要求)
Mem0^g 版本额外多一步:「分析知识图谱关系以理解用户的知识语境」,且 prompt 里 memories 与 relations 分两段分别给({speaker_N_memories} / {speaker_N_graph_memories})。
实验设置与结果
设置
- 数据集:LOCOMO——10 段长对话,每段约 600 轮 / 平均 26,000 token,跨多个 session;每段配约 200 个问题。问题分 single-hop / multi-hop / temporal / open-domain 四类(adversarial 类被排除,因为无 ground truth)。
- 指标:F1、BLEU-1,以及 LLM-as-a-Judge (J)。论文明确指出词面指标的缺陷:ground truth「Alice 三月出生」vs 生成「Alice 七月出生」——事实错了但 F1 很高。J 跑 10 次独立运行取均值 ± 1 std。
- 部署指标:token 消耗(
cl100k_base编码)、search latency、total latency 的 p50 / p95。 - 可复现性:temperature = 0。
- baseline 六大类:已有 LOCOMO benchmark(LoCoMo / ReadAgent / MemoryBank / MemGPT / A-Mem)、开源记忆方案(LangMem Hot Path)、RAG(chunk ∈ {128…8192},k ∈ {1,2})、full-context(整段 26k token 直接喂)、专有模型(OpenAI ChatGPT memory)、记忆平台(Zep)。
RAG 为什么不试 k>2:平均对话 26,000 token,k=2 已覆盖 16,384 token,再大就等于 full-context,选择性检索失去意义。
主结果(Table 1,分问题类型)
| 方法 | Single-Hop J | Multi-Hop J | Open-Domain J | Temporal J |
|---|---|---|---|---|
| A-Mem* | 39.79 | 18.85 | 54.05 | 49.91 |
| LangMem | 62.23 | 47.92 | 71.12 | 23.43 |
| Zep | 61.70 | 41.35 | 76.60 | 49.31 |
| OpenAI | 63.79 | 42.92 | 62.29 | 21.71 |
| Mem0 | 67.13 | 51.15 | 72.93 | 55.51 |
| Mem0^g | 65.71 | 47.19 | 75.71 | 58.13 |
分类型解读:
- Single-hop:Mem0 最强(F1 38.72 / J 67.13)。加图反而略降——目标事实就在单轮里时,关系结构提供不了额外价值。
- Multi-hop:Mem0 明显最强(F1 28.64 / J 51.15)。加图不但没帮上还掉了 4pt——论文承认这与预期相反,归因于「导航复杂图结构在多步推理中的开销或冗余」。
- Open-domain:Zep 反超(J 76.60),Mem0^g 75.71 紧随(差 0.89pt),Mem0 72.93。
- Temporal:Mem0^g 最强(F1 51.55 / J 58.13),Mem0 55.51 也不弱。OpenAI memory 崩到 21.71——原因很具体:即使 prompt 里显式要求带时间戳,ChatGPT 生成的记忆里大多数还是没有时间戳。
综合 J + 延迟 + token(Table 2 关键行)
| 方法 | 记忆/chunk token | Search p50 | Search p95 | Total p50 | Total p95 | Overall J |
|---|---|---|---|---|---|---|
| RAG (k=2, 256) | 256 | 0.255 | 0.699 | 0.802 | 1.907 | 60.97 |
| Full-context | 26,031 | — | — | 9.870 | 17.117 | 72.90 |
| A-Mem | 2,520 | 0.668 | 1.485 | 1.410 | 4.374 | 48.38 |
| LangMem | 127 | 17.99 | 59.82 | 18.53 | 60.40 | 58.10 |
| Zep | 3,911 | 0.513 | 0.778 | 1.292 | 2.926 | 65.99 |
| OpenAI | 4,437 | — | — | 0.466 | 0.889 | 52.90 |
| Mem0 | 1,764 | 0.148 | 0.200 | 0.708 | 1.440 | 66.88 |
| Mem0^g | 3,616 | 0.476 | 0.657 | 1.091 | 2.590 | 68.44 |
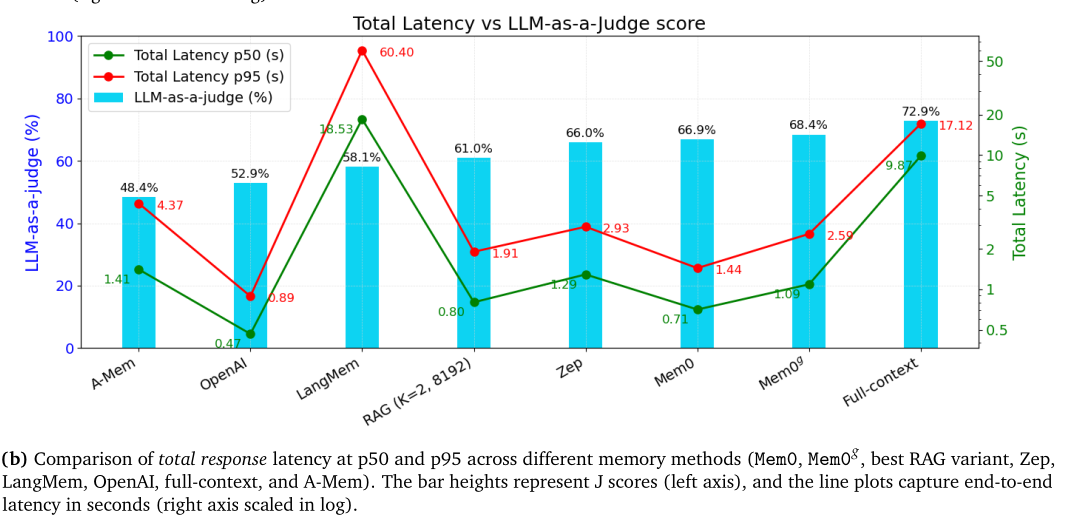
几个值得单独拎出来的数字:
- Mem0 的 search latency 是全场最低(p50 0.148s / p95 0.200s),比 Zep 快 3.5×,比 LangMem 快 120×+。
- LangMem 的 search p95 = 59.82s——论文直接判定「对交互式应用不可用」。
- Mem0 相对 full-context:p95 总延迟 −92%(17.117 → 1.440),J 只降 6.0pt(72.90 → 66.88);Mem0^g −85%(→ 2.590),J 降 4.46pt。
- 相对最好的 RAG(60.97):Mem0 +10% 相对增益,Mem0^g +12%。
记忆存储开销(4.5 节,这段信息密度最高)
| 系统 | 每段对话的记忆 token |
|---|---|
| Mem0 | ~7k |
| Mem0^g | ~14k(翻倍,因为多存 nodes + relationships) |
| 原始对话(无抽象) | ~26k |
| Zep | > 600k |
Zep 比原始对话本身还多 20 倍——论文归因于其设计选择:每个节点缓存完整的 abstractive summary,同时边上还存 facts,导致全图大量冗余。
还有一个很实际的工程观察:Zep 加完记忆后立刻检索经常答不对,隔几小时再搜同样的 query 结果明显变好——说明其图构建依赖多次异步 LLM 调用和大量后台处理,不适合实时场景。对比之下 Mem0 的图构建最坏情况也在一分钟内完成,加完即可用。
思考与可参考价值
局限(批判性看)
- Full-context 仍是天花板:72.90 vs Mem0^g 68.44,差 4.46pt。论文的论证是「用 4.5pt 换 92% 延迟降低值得」——这个 trade-off 在延迟敏感场景成立,在离线/高精度场景不成立。别把它当成「记忆系统全面超越长上下文」来读。
- 图记忆在 multi-hop 上是负收益(−3.96pt),论文自己也说 “surprisingly”,只给了「开销或冗余」这种定性归因,没有诊断实验。这是个没解释清楚的反常现象。
- 写入时 consolidate 丢历史:DELETE 物理删除、UPDATE 覆盖,意味着「这个偏好是什么时候变的」这类问题永久答不了。这正是 APEX-MEM 的批判点,也解释了 Mem0 temporal 只有 55.51/58.13——图版靠「标 invalid 不真删」拿回了 2.62pt,但基础版没有这层保护。
- 超参给得很薄:
m=10、s=10、相似度阈值t(论文没给具体值)、摘要刷新频率(没给)——想复现得自己扫。 - 全链路只用 GPT-4o-mini,没做模型消融。记忆管理的裁决质量高度依赖 LLM 的推理能力,换小模型会退化到什么程度是未知数。
- 评测面偏窄:只有 LOCOMO 一个 benchmark,且排除了 adversarial 类(即「该拒答的问题」——恰恰是生产系统最需要的能力)。
- OpenAI baseline 的对比不完全公平:论文自己说明它给了 OpenAI「所有记忆」而非「问题相关记忆」的特权访问,因为没有 API 做选择性检索。
可借鉴点
(1) 「用 LLM 的 function call 直接当记忆管理器」是最省事也最实用的一招。 不训分类器、不定规则,四个操作(ADD/UPDATE/DELETE/NOOP)+ top-s 召回就能维持知识库一致性。用户画像、商品属性维护、SEO 推词库的增量更新都可以直接照搬这个模式——关键是把「召回相似项」和「裁决操作」拆成两步,向量检索负责缩小范围,LLM 只在 10 条候选里做判断,成本和准确率都可控。
(2) UPDATE 的信息量守卫值得抄。 InformationContent(f) > InformationContent(m_i) 这个条件很小但很关键——没有它,一条粗略的新事实会把详细的老记忆冲掉。任何做「增量覆盖」的系统都会踩这个坑。
(3) 「异步摘要旁路 + 同步主链路」是延迟优化的通用套路。 全局语境的更新不需要实时,拆到旁路去,主链路只读最新快照。这个模式在推荐的用户长期兴趣建模里完全同构:长期画像离线刷,在线只读。
(4) 记忆 ≠ chunk,这是相对 RAG 拿 +10~12% 的根源。 存「去噪后的结论」而不是「原文片段」。对搜索/推荐场景的启示是:给 LLM 的上下文应该是结构化结论(这个用户偏好 X、这个商品属于 Y 类目、历史上试过 Z 策略失败),而不是拼一堆原始日志让它自己筛。
(5) Zep 的 600k token 是个反面教材。 「每个节点存完整摘要 + 边上存 facts」听起来信息更全,实际是 20 倍冗余 + 数小时的构建延迟。做图记忆时要盯住「单位信息的 token 成本」这个指标,Mem0^g 的 14k vs Zep 的 600k 是 43 倍差距,而准确率还更高。
(6) 图记忆的价值窗口是 temporal 和 open-domain,不是 multi-hop。 这是本文最有价值的负面结论:别默认「加图 = 全面变好」。如果你的下游问题主要是「把散落信息拼起来」(multi-hop),纯自然语言记忆的表达力已经够了,加图纯属增加复杂度和延迟(search p50 从 0.148 → 0.476,3.2×)。先看问题类型分布再决定要不要上图。