KG-Agent: An Efficient Autonomous Agent Framework for Complex Reasoning over Knowledge Graph
中国人民大学高瓴人工智能学院 × BOSS 直聘 NLP Center / Career Science Lab
把「LLM 在 KG 上做多跳推理」从**人工预定义的交互流程**改成**自主 agent 迭代**,并且证明这件事不需要 GPT-4:只用 10K 条合成指令微调 LLaMA2-7B 就能超过全量微调的 SOTA。关键是三个设计:(1) 把 KG 上的推理动作抽象成 13 个工具(extraction / logic / semantic 三类),让 LLM 只需选工具填参数,不必直接吐 SPARQL;(2) 不从 GPT-4 蒸馏,而是**把 KGQA 数据集里已标注的 SPARQL 反向编译成代码形式的推理程序**,再逐函数调用拆成 (input, output) 对,得到零成本的高质量 agent 轨迹;(3) 用 knowledge memory 只维护「问题 + 工具定义 + 当前可选关系 + 历史程序」四段,把无界的 KG 压成有界的决策上下文。WebQSP F1 81.0 / CWQ 69.8 / GrailQA 86.1 / KQA Pro 92.15,且零样本迁到 ODQA 与影视域 KG 仍然领先。
核心思路
问题:让 LLM 在知识图谱上回答复杂多跳问题(“C 罗 2011 年效力的球队里,哪支成立最晚?”)。KG 太大不能整图塞进上下文,而 LLM 又不擅长直接生成正确的 SPARQL。
已有做法的两个死结:
- retrieval-augmented(Ye et al.):把相关三元组检索出来序列化成 prompt。丢掉了图结构,且会捞进大量冗余。
- synergy-augmented(StructGPT / RoG / Pangu):设计 LLM ↔ KG 的多轮交互机制。效果更好,但交互流程是人手写死的——“先抽关系 → 再选关系 → 再抽实体”这种固定剧本,遇到 4 跳带两个约束、或者需要 argmax/count 的题就转不动;而且这些方法多数依赖 ChatGPT/GPT-4 蒸馏,蒸出来的计划本身受限于特定任务设定,未必适合去教一个更弱的小模型。
KG-Agent 的关键 idea:把固定剧本换成自主决策的 agent 循环,同时把「教会小模型做这件事」的数据来源从 GPT-4 蒸馏换成 KGQA 数据集里现成的 SPARQL 标注。
一句话概括这篇的范式判断:KG 推理的难点不在”知识”而在”操作”。因此 agent 只需要学「怎么在图上走」这套与具体 KG 无关的通用能力,不需要记住任何具体事实——这正是它能 10K 样本训成、并且零样本跨 KG 迁移的根本原因。作者据此声称 KG-Agent 是第一个只靠 7B 开源模型的 KG 自主推理 agent 框架(对比表见下)。
| Method | Work Flow | Base Model | Tool | Memory | Multi Task |
|---|---|---|---|---|---|
| Pangu | 预定义 | T5-3B | ✗ | ✗ | ✗ |
| StructGPT | 预定义 | ChatGPT | ✓ | ✗ | ✗ |
| RoG | 预定义 | LLaMA-7B | ✗ | ✗ | ✗ |
| ChatDB | 自主 | ChatGPT | ✗ | ✓ | ✗ |
| KB-BINDER | 预定义 | CodeX | ✗ | ✗ | ✗ |
| KG-Agent | 自主 | LLaMA2-7B | ✓ | ✓ | ✓ |
整体实现思路
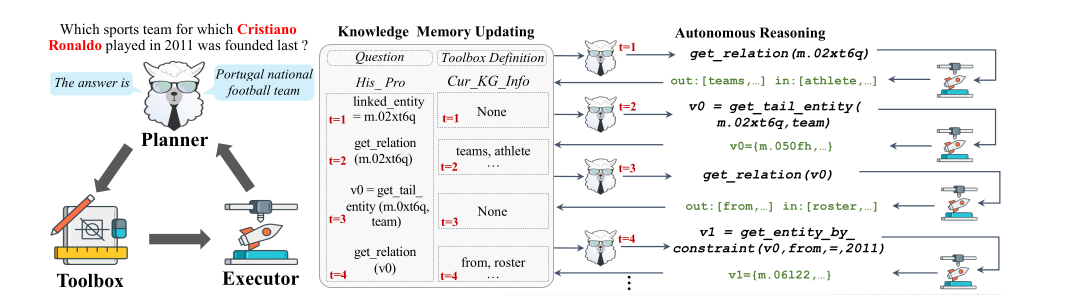
端到端由四个组件构成,跑一个**「选工具 → 执行 → 更新记忆」**的闭环:
- LLM-based Planner(指令微调后的 LLaMA2-7B):读当前 knowledge memory,输出一行代码形式的函数调用(如
v1 = get_entity_by_constraint(v0, from, =, 2011))。 - Multifunctional Toolbox:13 个工具,分 extraction / logic / semantic 三类,把 KG 上的原子操作封成统一签名的函数。
- KG-based Executor:用程序编译器真正执行这行调用,访问 KG 拿到新实体/关系,并缓存中间变量
v0, v1, v2...。 - Knowledge Memory:四段式上下文——
question+toolbox definition(固定不变) +current KG information+history reasoning program(每步更新)。
输入:自然语言问题 q + 已链接的话题实体(沿用 GraftNet/NSM 的设定,实体链接不在本文范围)+ KG G。
输出:答案实体集合 A_q。
终止:Planner 自己生成 ans = end(v_k) 时停止——不是外部固定 step 数,这是”自主”的具体含义。
整个循环与任务类型和具体 KG 无关:换 Wikidata、换影视域 KG,工具签名不变,agent 学到的决策能力可直接迁移。
子模块实现(可复现细节)
模块 A — Toolbox:把 KG 操作压成 13 个函数
设计依据是「KG 推理只需三种基本操作:从图中抽信息 / 按问题语义过滤 / 对抽出的结果做运算」,对应三类工具:
① Extraction Tool(6 个)— 访问 KG
| Tool | Input → Output | 说明 |
|---|---|---|
get_relation | 实体集 {e} → 一跳关系集 R_{e} | 返回入边和出边关系的并集 |
get_head_entity | {e}, r → {e} | 沿关系 r 取头实体 |
get_tail_entity | {e}, r → {e} | 沿关系 r 取尾实体 |
get_entity_by_type | 类型 t → {e} | 按类型取实体 |
get_entity_by_constraint | {e}, r, 算子 o, 值 v → {e} | v 非空时 o ∈ {=,>,>=,<,<=};v 为空时 o ∈ {argmax, argmin} |
get_candidate_entity | mention m → {e} | 实体提及的候选链接集 |
② Logic Tool(5 个)— 对中间结果运算:count({e}) → int、intersect([{e}]) → {e}、union([{e}]) → {e}、judge({e}, r, o, v) → bool、end({e}) → {e}(返回最终答案并终止)。
③ Semantic Tool(2 个)— 用小神经网络补语义:retrieve_relation({r}) → {r}(从候选关系里检索与问题语义相关的,实现follow SubgraphRetrieval)、disambiguate_entity({e}) → e(结合问题语义 + 实体一跳关系消歧,实现 follow TIARA)。
为什么这样切分很关键:get_relation 的输出直接成为下一步 memory 里的 current KG information,LLM 只需要从一个已经给定的候选关系列表里挑一个,而不是凭空生成关系名——这把「生成」问题降级成「选择」问题,是 7B 模型能干活的核心前提。同理 count/argmax 这类精确计算交给 executor,LLM 不碰。工具签名统一,可按需扩展。
模块 B — 指令数据合成:把 SPARQL 反向编译成 agent 轨迹
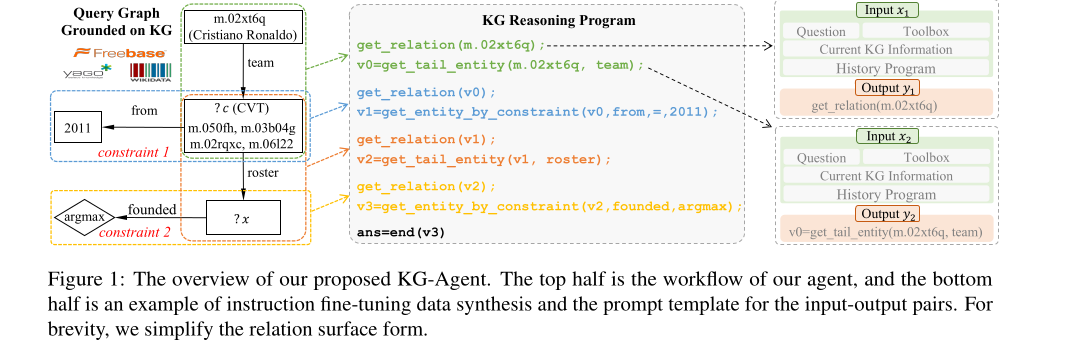
这是全文最有工程价值的部分:不从 GPT-4 蒸馏,而是把 KGQA 数据集里已有的 SPARQL 标注当作”金标准推理轨迹”回收利用。分三步:
B1. Reasoning Chain Extraction(SQL → query graph → 链)
- KG 太大,先按规则匹配(follow Yin et al. 2020)把标注 SPARQL grounding 到 KG 上得到 query graph——一个树状结构,能直接映射到逻辑形式,清楚刻画 SPARQL 的执行流。
- 从问题中提到的实体出发(例:
m.02xt6q= Cristiano Ronaldo)做 BFS 遍历 query graph 所有节点,产出一条从起点到答案的 reasoning chain(teams → roster_team),过程中自然带出约束条件(roster_from = "2011")和数值操作(founded取 argmax)。
B2. Reasoning Program Generation(链 → 函数调用序列)
- 把 chain 拆成一串相互关联的三元组,每个三元组对应一个中间推理步。
- 对每个三元组 ⟨e, r, e’⟩ 用规则模板合成表示 e→e’ 信息流的函数调用:先
get_relation(e)拿候选关系 {r},选出 r,再传给get_tail_entity或get_entity_by_constraint,得到新实体。 - 按 chain 顺序拼出完整程序,例:
get_relation(m.02xt6q);
v0 = get_tail_entity(m.02xt6q, team);
get_relation(v0);
v1 = get_entity_by_constraint(v0, from, =, 2011);
get_relation(v1);
v2 = get_tail_entity(v1, roster);
get_relation(v2);
v3 = get_entity_by_constraint(v2, founded, argmax);
ans = end(v3)
B3. Instruction Synthesis(程序 → 逐步 input-output 对)
- 对程序里每一个函数调用构造一个训练样本:
- input x_t =
question+toolbox definition+current KG information(当前实体集的候选关系)+history reasoning program(此步之前的所有调用) - output y_t = 当前这一步的函数调用
- input x_t =
- 执行完第 t 步后,history 追加该调用、current KG info 按执行结果更新,output 换成第 t+1 步 —— 迭代得到覆盖完整轨迹的
{⟨x_1,y_1⟩, ..., ⟨x_n,y_n⟩}。 - 全部套一个统一 prompt 模板格式化(图右侧的 Input x₁ / Output y₁ 结构)。
注意这里的隐含收益:因为 x_t 里的 current KG information 是真实执行得到的,训练分布天然贴合推理时分布;而 y_t 是从 gold SPARQL 推出来的,等于零成本拿到了 process supervision,不需要任何 LLM 打标。
模块 C — 指令微调
标准 decoder-only SFT,只在 response 上算交叉熵:
m 为输出 token 数,y_k 与 y_{<k} 是第 k 个及之前的输出 token。
超参(可直接复现):
- backbone:LLaMA2-7B
- 数据:从 in-domain 数据集共采 10,000 条,比例 WebQSP : KQA Pro : GrailQA : CWQ = 1 : 5 : 5 : 10
- cosine LR schedule,初始 lr 2e-5,weight decay 0.1,batch size 256,max length 1500,3 epochs
模块 D — 自主推理循环(推理期)
D1. Memory 初始化:question 与 toolbox definition 用给定值初始化且全程不变;current KG information 与 history reasoning program 初始化为空列表,每步更新。
D2. Planner 选工具:把 memory 四段按模板拼成 input(与训练时 x_t 完全同构),LLM 生成一个函数调用(工具名 + 参数,参数从 input 里选)。Planner 面对的决策实际是四类任务需求:
- 实体链接(
get_candidate_entity/disambiguate_entity) - 访问 KG(
get_relation/get_head_entity/ …) - 处理中间结果(
count/intersect/ …) - 返回答案终止(
end)
D3. Executor 更新 memory:程序编译器执行该调用,缓存/操作中间变量,从 KG 抽出新实体或关系。之后 memory 两处更新:① 该调用追加进 history reasoning program;② 若工具是取 KG 新信息的(如 get_relation),把结果并入 current KG information。
D4. 迭代直到 end:这个多轮决策过程”像是沿着关系在 KG 上行走”,一旦到达答案实体,agent 自行调用 end 停止。整个过程与任务类型、与具体 KG 均无关,因此是通用框架。
实验设置与结果
数据集
- in-domain(参与微调):WebQSP(4,737 题,≤2 跳,Freebase)、CWQ(WebQSP 的复杂化版本,≤4 跳,加约束,Freebase)、GrailQA(64,331 题,专测 i.i.d./compositional/zero-shot 三级泛化,Freebase)、KQA Pro(117,970 题,Wikidata,含组合推理/多跳/数值比较/集合运算)
- out-of-domain(零样本):WQ-Freebase、NQ-Wiki、TQ-Wiki(ODQA,closed-book 设定,过滤掉无法链接到 KG 实体的问题)
- 跨域 KG:MetaQA(40 万题,影视域 KG,1/2/3 hop 三个子集,one-shot 微调)
指标:WebQSP/CWQ 用 Hits@1 + F1,GrailQA 用 F1,MetaQA 用 Hits@1,ODQA 用 EM。注意作者的诚实处理:本方法与部分 baseline 返回的是无序答案集,不适合 Hits@1,故随机抽一个当 top-1、重复 100 次取平均(follow TIARA)。
主结果 — Freebase 三数据集(F1 / Hits@1)
| Model | WebQSP Hits@1 | WebQSP F1 | CWQ Hits@1 | CWQ F1 | GrailQA Overall | GrailQA I.I.D. | GrailQA Comp. | GrailQA Zero-shot |
|---|---|---|---|---|---|---|---|---|
| UniKGQA | 75.1 | 70.2 | 50.7 | 48.0 | - | - | - | - |
| ReasoningLM | 78.5 | 71.0 | 69.0 | 64.9 | - | - | - | - |
| TIARA | 75.2 | 78.9 | - | - | 81.9 | 91.2 | 74.8 | 80.7 |
| FC-KBQA | - | 76.9 | - | 56.4 | 83.8 | 91.5 | 77.3 | 83.1 |
| PanGu w/ T5-3B | - | 79.6 | - | - | 83.4 | - | - | - |
| RoG | 85.7 | 70.8 | 62.6 | 56.2 | - | - | - | - |
| GPT-4 | 73.2 | 62.3 | 55.6 | 49.9 | 31.7 | 25.0 | 20.6 | 39.2 |
| StructGPT | 72.6 | 63.7 | 54.3 | 49.6 | 54.6 | 70.4 | 44.3 | 50.5 |
| KG-Agent (7B) | 83.3 | 81.0 | 72.2 | 69.8 | 86.1 | 92.0 | 80.0 | 86.3 |
相对最强基线:WebQSP F1 +1.7%、CWQ F1 +7.5%、GrailQA F1 +2.7%(相对提升)。注意 GPT-4 在 GrailQA 只有 31.7,说明纯靠 LLM 参数知识答复杂 KG 问题根本不成立。
Wikidata — KQA Pro(Accuracy)
| Model | Overall | Multi-hop | Qualifier | Comparison | Logical | Count | Verify | Zero-shot |
|---|---|---|---|---|---|---|---|---|
| BART SPARQL | 89.68 | 88.49 | 83.09 | 96.12 | 88.67 | 85.78 | 92.33 | 87.88 |
| GPT-4 | 37.43 | 34.82 | 37.15 | 55.75 | 36.81 | 15.27 | 72.93 | 27.28 |
| KG-Agent | 92.15 | 91.03 | 87.90 | 96.32 | 91.28 | 88.21 | 92.86 | 91.40 |
GPT-4 的 Count 只有 15.27,KG-Agent 88.21 —— 这是”精确计算交给 executor 不交给 LLM”最直白的证据。
零样本 out-of-domain(EM):WQ-Freebase 28.90(vs BART-Large 26.33、ChatGPT 23.23);TQ-Wiki 35.89(vs BART-Large 33.05)。但 NQ-Wiki 33.00 明显输给 ChatGPT 57.49、TQ-Wiki 也输给 ChatGPT 88.68 —— 因为 NQ/TQ 基于 Wikipedia 构建、大模型很可能预训练时见过。作者的解释是 KG-Agent 只学”怎么和 KG 交互”、不背具体知识,所以在依赖 KG 的 WQ-Freebase 上反超、在纯记忆题上落后。
跨域 KG 迁移 — MetaQA(Hits@1,one-shot):1hop 97.1 / 2hop 98.0 / 3hop 92.1,全面超过全监督 TransferNet(96.5 / 97.5 / 90.1)与 StructGPT(94.2 / 93.9 / 80.2)。ChatGPT 直接答 3hop 只有 43.2。说明 agent 学到的是与 KG 无关的通用决策能力。
消融 1 — 指令数据量(2k → 64k)
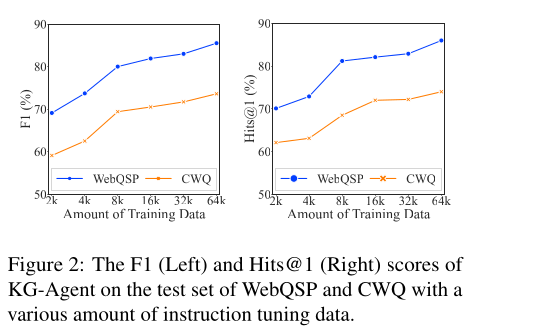
性能随数据量单调上升但16k 之后基本饱和(16k→64k 提升很小)。作者归因于合成数据多样性不足而非数量不足——毕竟全是规则模板从 SPARQL 编译出来的,模式有限。这也解释了为什么最终只用 10K。
消融 2 — 采样比例(总量固定,F1)
| Proportion (WebQSP:CWQ:GrailQA) | WebQSP | CWQ | GrailQA | Average |
|---|---|---|---|---|
| 1:10:5(本文选用) | 80.0 | 69.8 | 86.1 | 78.6 |
| 2:10:5 | 81.2 | 68.7 | 83.3 | 77.8 |
| 1:20:5 | 78.9 | 73.6 | 78.8 | 77.1 |
| 1:10:10 | 80.8 | 66.9 | 84.3 | 77.3 |
规律很干净:加倍某个数据集的比例,该数据集自身分数必涨,但平均分必跌。是典型的多任务数据配比 trade-off。
思考与可参考价值
局限(部分作者自陈)
- 只试了 LLaMA2-7B 一个 backbone,没验证 Mistral-7B / CodeLLaMA-7B——考虑到输出是代码形式的函数调用,CodeLLaMA 很可能更强,这个缺口不小。
- 数据合成完全依赖已有 SPARQL 标注。这是优点(零成本、高质量)也是致命依赖:没有 gold 逻辑形式标注的场景,这套方法整个立不住。想迁到自己的业务图谱,得先有等价的”标注查询”。
- 规则模板导致多样性天花板,16k 后饱和已经暴露了这一点。作者说 future work 是构造更多样的样本。
- 实体链接被假设为已给定(follow GraftNet/NSM 惯例)。真实系统里 mention → entity 的错误率往往才是瓶颈,本文用
get_candidate_entity/disambiguate_entity两个语义工具带过,但没有端到端的链接误差分析。 - 只评了事实型 QA,没有 data-to-text、formal-language-to-text 等更广场景;也只支持 KG,没扩到数据库/表格(作者列为 future work)。
- 没有延迟与调用次数统计。多跳题一步一个
get_relation+ 一步一个get_*_entity,4 跳意味着 8+ 次 LLM 前向 + KG 访问,线上服务这笔账文中完全没算。 - NQ/TQ 上落后 ChatGPT 很多——说明这套东西的价值窗口是「答案确实在 KG 里且需要多跳/约束/聚合」,纯知识记忆题不该用它。
对电商 / 搜推 / Agent 方向的可借鉴点
(1) 「把生成降级成选择」是小模型做 agent 的通用杠杆。 KG-Agent 从不让 LLM 凭空写关系名,而是先 get_relation 把候选摆在上下文里再让它挑。任何有大规模离散 ID/schema 的场景(商品类目、属性名、SEO 词表、指标名)都可以套这个模式:先用确定性工具枚举出合法候选,再让 LLM 在候选里选——幻觉率和模型尺寸要求同时降一个量级。
(2) 「从已有结构化标注反向编译 agent 轨迹」这条数据路子最值得抄。 大家做 agent SFT 默认路径是”GPT-4 蒸馏 + reject sampling”,又贵又受教师能力上限约束。本文指出:如果你的业务里已经存在等价的”gold 执行计划”(线上跑通的 SQL、生效的检索 DSL、历史成功的工具调用链、已上线的规则策略),就可以规则化地反编译成逐步的 (memory, next-action) 对,零 LLM 成本拿到 process supervision,且训练分布天然贴合推理分布。这对内部有大量历史查询日志的团队 ROI 极高。
(3) 精确计算永远交给 executor。 GPT-4 在 KQA Pro 的 Count 只有 15.27 vs KG-Agent 88.21。这与 APEX-MEM 的 GraphSQL 工具、CORONA 的 “LLM 粗筛 + GNN 精排” 是同一条哲学的不同实例:LLM 负责决策路径,确定性组件负责数值和集合运算。设计 agent 工具集时,凡涉及计数/排序/交并/比较的,一律出成工具而非提示词。
(4) knowledge memory 的四段式结构可直接照搬。 任务 + 工具定义(不变)+ 当前环境可选项(每步刷新)+ 历史动作序列 —— 这是一个把无界环境压成有界上下文的最小充分表示。相比往上下文里堆检索结果,它的关键差异是只保留”当前这一步能选什么”,而不是”到目前为止看到过什么”,上下文长度不随跳数爆炸(max length 只需 1500)。
(5) 「学操作而非学知识」决定了迁移性。 MetaQA one-shot 就超全监督基线、跨 Freebase↔Wikidata 联合训练还能互相增益,根因是训练目标里没有任何具体事实。做垂域 agent 时值得刻意做这个切分:能力层(怎么调工具、怎么规划)做通用训练,知识层完全外置到可替换的数据源,这样换业务线不用重训。
(6) 数据配比的 trade-off 曲线值得复用其结论:加倍某数据集 → 自身涨、平均跌。多任务 agent 训练里若某个 task 特别重要,可以主动接受这个牺牲;但如果目标是通用能力,均衡配比几乎总是最优。