APEX-MEM: Agentic Semi-Structured Memory with Temporal Reasoning for Long-Term Conversational AI
Amazon AGI
把 Agent 长期记忆的核心矛盾重新定义为「**写入时决策 vs 读取时决策**」的范式选择。现有记忆系统(Mem0 / MIRIX / Zep)都在**构建时**做 consolidate/overwrite——新事实来了就把旧的覆盖掉,等于在还不知道用户会问什么的时候就提前替他做了取舍,一旦问的是「X 什么时候变的」「Z 之前 Y 是什么」这类问题,被覆盖掉的历史已经找不回来了。APEX-MEM 主张反过来:构建时**只追加不覆盖**(append-only),把矛盾的、被推翻的事实全部保留并各自带上时间有效区间,把「哪个才算数」这个决策**推迟到检索时**由 agent 结合问题本身去裁决。为此它把对话建成一张 ontology 支撑的 property graph(35 类实体、事实以 subject-property-value + 时间区间 + 置信度 + 证据锚定到"事件"上),并配一个 ReAct agent 用四把工具(SchemaViewer 看 schema / EntityLookup 做实体归一 / GraphSQL 跑结构化时序查询 / Search 做混合检索)在图上多步推理。LOCOMO 88.88%(超 MIRIX 3.5pt)、LongMemEval 86.2%(超最强基线 11.6pt),时序类问题 90.63% 对比 Mem0 的 75.71%、MIRIX 的 65.62%。
核心思路
一句话问题:Agent 的长期记忆一旦「记错了该记哪个」,后面再强的检索也救不回来。
现有结构化记忆系统(Mem0、MIRIX、Zep)都有一个共同动作——consolidate / overwrite:新事实进来,把旧的同名事实覆盖掉,只保留「当前状态」。这个动作的问题在于它发生在构建时,而那时你根本不知道用户以后会问什么。
关键 idea:把「哪个事实才算数」这个决策,从写入时挪到读取时。
这就是全文的范式区分,值得先讲清楚:
Eager update(Mem0 / MIRIX / Zep)
  写入时:新事实 → 覆盖旧事实 → 图里只剩「当前状态」
  读取时:查到什么就是什么
  代价:  「X 什么时候变的」「Z 之前 Y 是什么」永久答不了

Append-only(APEX-MEM)
  写入时:新事实 → 追加,旧事实原样保留,各带 [t_from, t_to] 有效区间
  读取时:agent 把冲突的事实全捞出来,按问题需要的时间点自己裁决
  代价:  图更大、检索更复杂,换来完整的时间演化史
论文给的证据很直接(Table 12)——LOCOMO 时序类问题准确率:
| 系统 | 是否 append-only | 时序准确率 | 与 APEX-MEM 差距 |
|---|---|---|---|
| APEX-MEM | 是 | 90.63% | — |
| Zep | 部分(时序 KG) | 76.60% | −14.03 |
| Mem0 | 否(consolidate) | 75.71% | −14.92 |
| MIRIX | 否(state merge) | 65.62% | −25.01 |
MIRIX 整体分数(85.38%)其实很高,但时序单项掉到 65.62%,正好印证「eager update 把时间线抹平了」这个论断。
整体实现思路
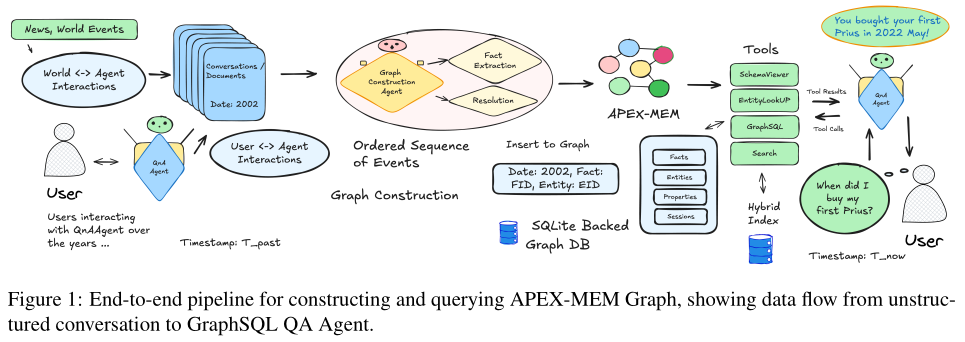
端到端分构建和查询两条链路:
构建链路(离线/增量)
- 输入:按时间排序的对话轮次或文档流(不限于人机对话——新闻流、文档流同样适用,此时”speaker”是 World、“listener”是 LLM Agent)
- 事实抽取:LLM 按 ontology 做 schema 约束生成,把每一轮变成一个「事件」+ 若干「事实」
- 实体/属性归一:新抽出来的实体去和已有实体做消歧对齐,避免同一个人裂成好几个节点
- 合并进图:
G^(t+1) ← Merge(G^(t), g_t),软归一化(soft-canonicalization),满足条件才融合节点 - 落库:一个 SQLite 支撑的图库(表:
entities / properties / facts / events / evidence / turns)+ 一个混合索引(dense + lexical)
查询链路(在线)
- ReAct agent 拿到问题,先把问题里的时间指代(“上个月”)解析成具体日期/区间
- 在四把工具间多步来回:
(r_t, a_t) ~ π_θ(· | x, h_t),每步产出一段推理r_t和一个动作a_t - 动作要么是调工具
(T_t, z_t),要么是终止并输出答案 - 工具输出追加进历史
h_{t+1} = h_t ∪ {(r_t, a_t, o_t)},最多 40 次工具调用
一个关键的工程选择:对超长对话(文档数 > 10³),离线建全图既不可行也没必要——大部分内容跟用户会问的问题无关。所以有 APEX-MEM Online 模式:先用语义+词法检索算每篇文档对当前问题的相关度,只对 Relevance(d_i | Q) > Θ_rel 的子集建图(实验里 Θ_rel = 0.2)。LongMemEval 和 SealQA 用的都是这个模式。
子模块实现(可复现细节)
模块 A — Ontology:混合「实体-事件」本体
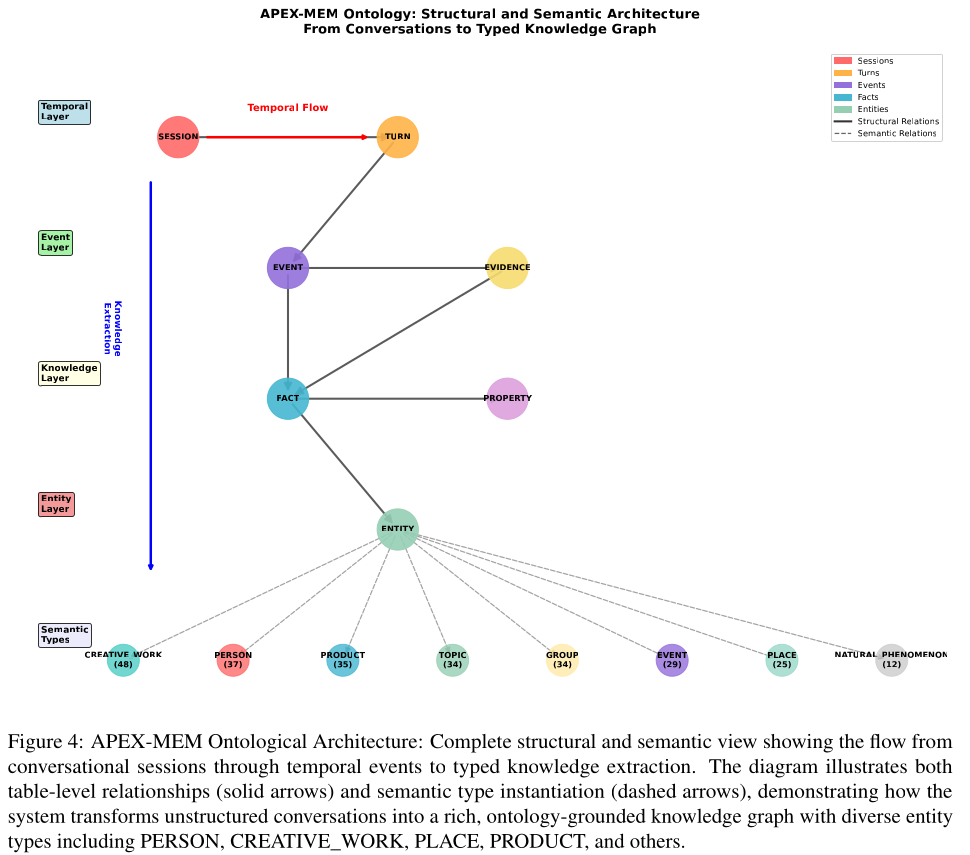
形式化定义:G = (V, E, Π, Λ),其中 Π: V ∪ E → P(K × S) 把每个节点/边映射到一组键值属性,Λ: V ∪ E → T 给每个节点/边打类型。
实体:e = (n, τ, ρ, id)
n名称,τ ∈ T类型(35 类,对标 YAGO 分类体系),ρ ∈ R会话角色(Speaker / Listener / Agent / Mentioned),id可选外部标识- 35 类覆盖:agents(Person / Organization / Corporation)、生物(Animal / Plant / Taxonomy)、时空(Place / Event / Time)、实物(Product / Device / Vehicle)、数字对象(Software / Dataset / Service)、信息资源(CreativeWork / Document / Message)、金融(Stock / Contract)、健康(Food / Medication / Disease)、抽象(Topic / Metric / Task)
事实:f = (s, p, v, δ, [t_from, t_to], c, E)
s主体实体、p属性、v值、δ数据类型、[t_from, t_to]时间有效区间、c ∈ [0,1]置信度、E证据集合
事件:ε = (type, T, L, P, F, E_ε)
T事件时间戳、L地点、P ⊆ {e_i}参与者、F ⊆ {f_j}关联事实、E_ε支撑文本证据
这里有个容易被略过但很关键的设计:事实不是直接挂在实体上,而是锚定到”事件”上。这正是 append-only 能成立的原因——同一个实体的同一个属性可以有多条事实,各自挂在不同时间的事件下,互不覆盖。相比之下 Mem0 那种「实体-关系」二元组结构,天然没地方放时间演化。
模块 B — 实体与属性归一(Entity / Property Resolution)
输入:对话文本里的一个 mention m
输出:o = (d, id, n_norm, τ, A, c, r)
流程:
- 从 dense 向量索引里按余弦相似度取 top-k 候选
C = {c_1, …, c_k},每个c_i = (id_i, text_i, s_i) - 用结构化 LLM 评估候选,产出决策
d ∈ {choose_existing, propose_new, none} - 输出里
n_norm是归一化名、A是别名集合、c是置信度、r是理由文本(保留 provenance 便于审计)
属性归一走同样的流程,额外多两步:属性名转 snake_case、推断数据类型 δ ∈ {str, int, float, bool, date, datetime, enum, url, list}。
模块 C — 事实抽取
输入:u = (s, l, text, t_anchor, ctx) —— speaker、listener、文本、锚点时间戳、近期上下文
输出:符合 ontology schema 的事件表示 ε
关键约束:
- few-shot prompt,人工挑的高质量示例覆盖多种模式:事实断言、数值、情绪状态、环境条件、个人属性
- 强类型校验:participants 必须符合
τ ∈ T和ρ ∈ R,facts 必须指定δ ∈ Δ - 时间表达一律相对
t_anchor归一化成 ISO 8601——这是整个时序推理的地基 - 每条事实都带置信度
c和证据E = {(e_text, e_turn, e_span)},能回溯到原始 utterance
实际转换长这样(Table 13 节选):
| 原文 | 实体 | 类型 | 属性 | 值 | 数据类型 |
|---|---|---|---|---|---|
| ”I went to a LGBTQ support group yesterday and it was so powerful.” | Caroline | PERSON | attended_event | ”LGBTQ support group” | str |
| experience_description | ”powerful” | str | |||
| LGBTQ support group | EVENT | event_date | ”2023-05-07” | date | |
| ”I just signed up for a pottery class yesterday. It’s like therapy for me.” | Melanie | PERSON | activity_benefit | ”therapy for me” | str |
| emotional_outlet | ”pottery helps express emotions” | str | |||
| pottery | CREATIVE_WORK | therapeutic_value | true | bool | |
| ”I’m swamped with the kids & work.” | Melanie | PERSON | has_children | true | bool |
| emotional_state | ”overwhelmed” | enum |
注意它连 emotional_state、therapeutic_value 这种软性属性都结构化了,且带类型(enum / bool)——这是它相比 Mem0「只存实体间关系」表达力更强的地方。
模块 D — 四把工具(ReAct agent 的动作空间)
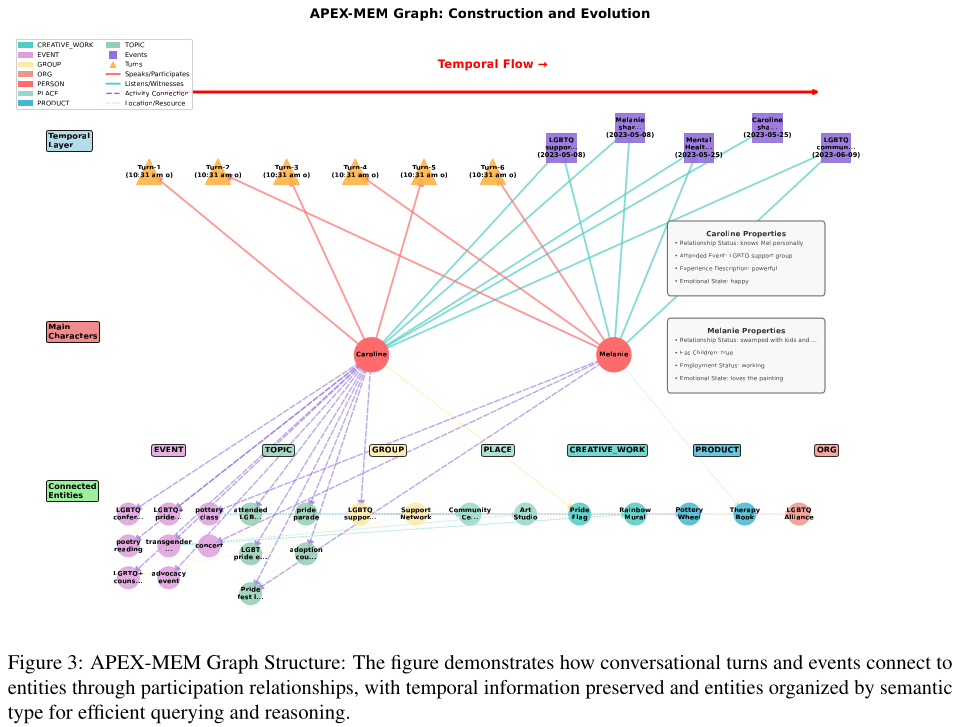
① SchemaViewer — T_schema: {0,1}² → S
输入两个布尔开关(要不要示例、要不要使用指南),返回结构化的 schema 视图。它其实是个元级规划辅助:agent 用它看清库里有哪些表、什么时候该调哪个工具、时序推理的 SQL 该怎么写。
② EntityLookup — T_ent: Q × N → D_ent
把自由文本 query + top-k 预算映射成排序好的实体文档。先用混合索引(dense + lexical)召候选 id,再去图库查 facts / properties / events / evidence,为每个实体 id 拼一个文档:
d = (id, name, type, latest, anchors, last_anchor, facts)
其中 latest 和 facts 是 markdown 表格形式的近期属性值快照,anchors / last_anchor 通过 events.anchor_datetime 暴露时间上下文。作用是把表面提及归一到图 id,并拿到带时间戳的事实快照。
③ GraphSQL — T_sql: S_sql × P_sql → R_sql
只读 SQL 接口。S_sql 限定为安全的 SQLite SELECT(或 WITH … SELECT),白名单表:events / facts / evidence / entities / event_participants / properties / turns。执行前校验:只允许单条只读语句,禁止 UPDATE 和 DDL。结果包成 markdown 返回。
它负责的是纯检索做不了的事——join、聚合、数学计算、基于 anchor_datetime 的时序运算。四类典型查询(Table 7/8):
-- SELECT:实体查找
SELECT DISTINCT entity_id, entity_name, entity_type FROM ...

-- JOIN:跨表关系遍历
SELECT f.property_name, f.value_json, f.dtype FROM facts f JOIN ...

-- AGGREGATE:跨实体集合运算
SELECT COUNT(DISTINCT device_name) as device_count FROM (
  SELECT 'Fitbit Versa 3' as device_name
  UNION SELECT 'nebulizer machine' UNION SELECT 'Accu-Chek Aviva Nano'
  UNION SELECT 'hearing aids' )

-- TEMPORAL:用 SQLite 的儒略日函数算天/周/月跨度
SELECT f.value_json as start_date, date(:question_date) ...
④ Search — T_search: Q → C,T_search(q) = (E_q, P_q, V_q, T_q)
混合检索层,一次返回候选实体、候选属性、候选事件/证据、相关对话轮次四路结果——本质是「围绕问题捞一个高相关子图」,捞完可以再交给 GraphSQL 精算。
模块 E — 时序冲突怎么被解掉(论文的 Case 1)
这个例子最能说明 append-only 的价值:
问题:“Alice 现在最喜欢的餐厅是哪家?”
时间线:
- Session 1(2024-01-15):Alice 说 “I love Italian Garden! Their pasta is the best in town.”
- Session 5(2024-03-20):Alice 说 “Italian Garden closed down last month. Now I go to Sakura Sushi every week instead.”
APEX-MEM 的处理:构建时抽出
(Alice, favorite_restaurant, "Italian Garden", from=2024-01-15)之后又抽出(Alice, favorite_restaurant, "Sakura Sushi", from=2024-03-20)但不删除前一条。检索时 GraphSQL 的时序查询把两条都按时间戳返回,agent 挑最近的有效条目(“Sakura Sushi”)。额外收益:因为完整演化史还在,追问「Alice 最喜欢的餐厅是什么时候变的?」也能答——这在 eager update 的系统里已经永久丢失了。
实验设置与结果
设置
| 项 | 配置 |
|---|---|
| 数据集 | LOCOMO(多 session 长期对话,问题分 single-hop / multi-hop / temporal / open-domain / adversarial)、LongMemEval(超长输入、跨 episode 推理)、SealQA-Hard(30 篇网页检索文档里藏 1–2 篇 gold,含冲突噪声) |
| 构建用模型 | 事实抽取 Claude Sonnet 4.5,实体/属性归一 Claude Haiku 4.5(成本与效果折中) |
| QnA agent | Claude 4.5 Haiku / Sonnet、Claude 3.5 Sonnet、GPT5、GPT4o |
| 工具预算 | ReAct 最多 40 次调用 |
| Online 模式 | LongMemEval / SealQA 用,Θ_rel = 0.2;LOCOMO 对全部 session 建图 |
| 评测 | LLM-as-a-Judge,温度 0,报 3 次均值(标准差 < ±1) |
构建质量(Table 2,500 条随机轮次,GPT5 当裁判):
| 模型 | 事实抽取精度 | Schema 覆盖 | 实体归一 |
|---|---|---|---|
| Claude Sonnet 4.5 | 97.3% | 91.1% | 98.2% |
| GPT4o | 94.2% | 75.7% | 98.1% |
| Claude Haiku 4.5 | 95.8% | 90.3% | 95.4% |
| Qwen3-14B | 95.4% | 88.9% | 92.5% |
注意 GPT4o 的 schema 覆盖只有 75.7%,明显低于 Claude 系——说明按 ontology 做约束生成这件事对模型的结构化能力要求不低。
主结果
LOCOMO(Table 1):
| 方法 | Single-Hop | Multi-Hop | Temporal | Open-Domain | Adversarial | Overall |
|---|---|---|---|---|---|---|
| APEX-MEM + GPT5 | 89.88% | 86.29% | 90.63% | 91.68% | 86.77% | 88.88% |
| APEX-MEM + Claude 4.5 Sonnet | 89.36% | 86.92% | 90.63% | 87.75% | 86.10% | 88.41% |
| APEX-MEM + GPT4o | 88.47% | 85.46% | 83.49% | 86.46% | 84.98% | 86.35% |
| MIRIX | 85.11% | 83.70% | 65.62% | 88.39% | N/A | 85.38% |
| Nemori | 84.9% | 75.1% | 77.60% | 51.0% | N/A | 79.4% |
| Zep | 61.70% | 41.35% | 76.60% | 49.31% | N/A | 75.14% |
| Mem0 | 65.71% | 47.19% | 75.71% | 58.13% | N/A | 68.44% |
LongMemEval:APEX-MEM + Claude 4.5 Sonnet 86.2%,对比最强基线 Nemori 74.6%(+11.6pt)、session-aware RAG 72.5%(+13.7pt)。
SealQA-Hard:APEX-MEM + GPT5 40.15%,对比 O3 34.6%、GPT5 带 web search 38.6%、DeepSeek-R1 15.4%、O4-Mini-HIGH 12%。
工具消融(Table 3,Claude 4.5 Haiku)
| 工具组合 | Single-Hop | Multi-Hop | Temporal | Open-Domain | Overall |
|---|---|---|---|---|---|
| SchemaViewer + EntityLookup | 80.85% | 76.64% | 72.92% | 76.34% | 77.19% |
| + GraphSQL | 80.78% | 79.75% | 82.29%(+9.37) | 78.00% | 79.45% |
| + Search | 85.46% | 84.74% | 79.17% | 89.18%(+11.18) | 87.00% |
分工非常清楚:GraphSQL 主要吃时序(+9.37pt)和多跳,Search 主要吃开放域(+11.18pt)。
最有意思的一组数字在工具调用量上(Table 6):GraphSQL-only 的变体要跑 27,282 次 GraphSQL 才拿到 79.45%;而完整版只用 8,260 次 GraphSQL + 8,900 次 Search 就拿到 87%。3.3× 的调用量差距——原因是 GraphSQL-only 必须先用 SchemaViewer/EntityLookup 摸清图结构才能写出有效 SQL,光是 schema 发现就烧掉大量调用。
成本(Table 9 / 10)
| 方法 | 建图 token/对话 | 摊薄建图 token/query | 总 token/query | 准确率 |
|---|---|---|---|---|
| MIRIX | ~15.2M | ~98,750 | ~112,000 | 85.38% |
| Zep/Graphiti | ~9.4M | ~60,900 | ~64,800 | 75.14% |
| APEX-MEM | 2.69M | 13,557 | ~30,000 | 84–89% |
| Mem0 | ~1.9M | ~12,409 | ~15,900 | 68.44% |
| Full Context | 0 | 0 | ~25,000 | 87.52% |
APEX-MEM 的 token 成本只有 MIRIX 的约 1/4,准确率还更高。 单 query 的 token 分解:工具框架开销 27.3%、记忆检索 26.6%、agent 循环 19.8%、系统 prompt 9.6%,建图摊薄后只占 16.6%——也就是说大头在 agent 的推理循环,不在建图。
其他值得记的数字:
- SQL 成功率(Table 11):Claude Sonnet 4.5 97.6%,GPT-5 93.4%(主要栽在 SQLite 语法差异),Haiku 95.4%
- 失败恢复:87% 的 SQL 失败能被救回来——SchemaViewer 重查 schema 占 45%、退回 EntityLookup 占 28%、退回 Search 占 14%
- 收敛速度:Claude 4.5 Sonnet 只要 ~10 次工具调用就到 84–86%,80–90% 的问题在前 10–20 次调用内解决;大部分 agent 在 ~20 次调用处触到性能天花板
思考与可参考价值
可直接借鉴的点
-
「决策推迟到检索时」是可以脱离对话场景迁移的范式。它的适用前提是:你不知道下游会问什么,且历史本身有信息价值。这个条件在很多地方成立——用户画像(去年爱买什么 vs 现在爱买什么,都有用)、商品属性演变(改过价、换过类目)、SEO 推词的历史版本。反过来,如果下游只问「当前状态」,那 append-only 就是纯粹的成本。先判断这个前提再决定要不要抄。
-
事实锚定到”事件”而不是”实体”,是 append-only 能成立的结构前提。很多人做知识图谱是
(entity, relation, entity)三元组,这种结构天然没地方放时间,想加时序只能往边上挂属性、越挂越乱。APEX-MEM 的Fact → Event → Time这条链是干净的,值得在设计商品/用户图谱时直接借鉴。 -
「LLM 负责粗筛、SQL 负责精算」的分工在这里再次被验证。GraphSQL 补的正是纯向量检索做不了的部分:join、聚合、日期运算。这和 CORONA 那种「LLM 粗筛 + GNN 精排」是同一个哲学的不同实例——别让 LLM 干它不擅长的精确计算。
-
那个 3.3× 工具调用量的对比很有说服力。它说明工具的”互补性”比单个工具的”强度”更重要:给 agent 一把万能但笨重的锤子(GraphSQL),它会把所有问题都拆成一堆 SQL;给它一组各有所长的工具,它自己会挑最省的路径。做 agent 工具设计时这是个可量化的评估角度——不只看准确率,还要看收敛所需的调用次数。
-
成本账算得诚实且反直觉:建图只占 16.6%,大头是 agent 循环(工具框架 27.3% + 检索 26.6% + 循环 19.8%)。做 agent 记忆系统时,优化重心应该放在减少工具往返,而不是压缩建图成本——这和大多数人的第一直觉相反。
-
Θ_rel 门控的 online 建图值得抄。「不对全量建图,只对与当前问题相关的子集建」这个思路,在文档量大但查询稀疏的场景(内部知识库、工单历史)ROI 很高。
局限与存疑
-
Full Context 基线其实并不弱。LOCOMO 上 GPT4o 全上下文拿到 87.52%,只比 APEX-MEM 的 88.88% 低 1.36pt,token 成本还更低(25K vs 30K)。也就是说在 LOCOMO 这个规模上,整套复杂的图构建 + 多工具 agent,相对”把全部内容塞进上下文”的净收益只有 1 个多点。真正拉开差距的是 LongMemEval(86.2% vs 62.2%)和时序单项——所以这套东西的价值窗口是「上下文塞不下」或「问题本身依赖时间线」,而不是普遍适用。这一点论文没有强调,但从表里读得出来。
-
强依赖底座模型的工具使用能力。GPT4o 当 QnA agent 时整体掉到 86.35%,作者明说是「SQLite 查询生成和工具选择的错误率过高」,而且得往 prompt 里加显式的报错示例才达到这个水平。这意味着换成能力弱一些的模型,这套架构会明显退化——对想用小模型降本的场景是硬约束。
-
延迟没有正面回答。大部分 agent 要 20 次工具调用才收敛,作者也承认「会影响交互场景的响应延迟」,但全文没有给任何端到端延迟数字。对话记忆本身就是交互式场景,这个缺失比较关键。
-
用 SQLite 模拟图查询是个妥协。作者自己在正文里写「GraphSQL 是复杂的结构化查询生成任务,因为我们用 SQLite 建模图查询」,并把「评估真正的图数据库」列为 future work。所以现在的 SQL 成功率数字(93–98%)有一部分是被 SQLite 语法拖累的,换 Cypher/Gremlin 未必是同一个结论。
-
SealQA-Hard 只有 40.15%,绝对值很低。作者归因于事实抽取还不够完整(隐式关系、时间细微差别、上下文依赖)。这说明在噪声大、多文档互相冲突的真实检索场景里,这套方法离可用还有距离——而这恰恰是电商/搜索最常见的场景。
-
失败模式暴露了实体链接的天花板(Case 3):问「Bob 上个月在巴黎去了几次餐厅」失败,根因是没能把餐厅名(“Le Jules Verne”)和巴黎这个地点实体从上下文线索(“Eiffel Tower”)关联起来。系统正确识别了实体,但没解析出隐含的空间关系。作者建议接 Wikidata 这类外部知识库——也就是说纯从对话里抽是不够的。
-
35 类 ontology 的通用性存疑。作者承认「跨领域标准化 ontology schema 仍有挑战,当前本体可能捕捉不到领域特定的细微差别」。落到电商这种垂域,35 个通用类大概率不够用,得自己扩——而扩本体又会反过来影响抽取模型的 few-shot 效果。