VISTA: A Test-Time Self-Improving Video Generation Agent
Google Research
Test-time 多 agent 闭环:分解 → 多组 prompt 生成视频 → pairwise tournament 选最优 → 视/音/上下文三 critic 出反馈 → 重写 prompt → 再生成。完全 black-box,对底层 T2V 模型零修改。
核心思路
问题一句话:文生视频(T2V)模型如 Veo 3 已经能产出高质量视频+音频,但对 prompt 极度敏感——同一个想法,措辞稍变结果天差地别,用户被迫陷入「改词 → 生成 → 筛选」的反复试错循环;而现有 test-time 优化方法(self-refine、prompt rewrite)只针对视频的单一属性(物体、无害性、视觉 reward),从未把视觉 / 音频 / 上下文三个维度统一进一个优化框架。
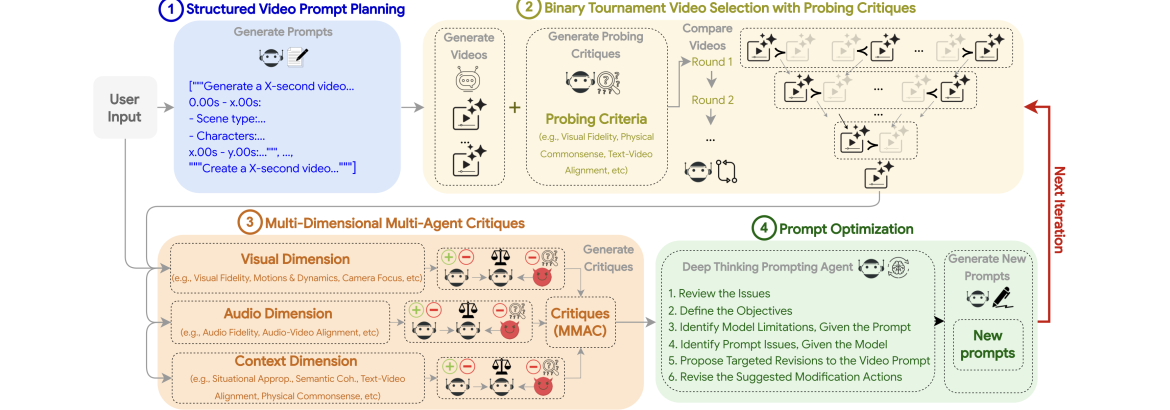
关键 idea:把 reasoning RL 里「测试期延长思考」的范式平移到视频生成。VISTA(Video Iterative Self-improvemenT Agent)是一个纯黑盒、对底层 T2V 模型零修改的多 agent 系统,在推理时通过「迭代重写 prompt」自我改进。它把人类评视频、改 prompt 的过程拆成四个可配置组件:(1) 结构化时序 prompt 规划(把用户想法分解成时间轴上的镜头序列,每段含 9 个视/音/上下文属性槽);(2) Pairwise Tournament 选优(用 MLLM-as-Judge 双向两两比较选当轮 champion,避免直接 K-way 打分的不一致与偏置);(3) 多维多 agent critique(MMAC)——受陪审团决策过程启发,每个维度设一个「正面法官 + 对抗法官 + 元法官」的三方法庭挖掘失败点;(4) Deep Thinking Prompting Agent(DTPA)——六步自省式推理把 critique 翻译成定向的 prompt 修改动作。整体跑 5 轮,对 Veo 3 的 win rate 最高达 60%,人类评测 66.4% 偏好 VISTA。
整体实现思路
VISTA 给定用户 prompt ,输出优化后的视频 及其精炼 prompt ,分初始化和自改进两个阶段(对应论文 Algorithm 1):
初始化阶段
- L1 — 结构化规划:
PromptPlanner把 解析成 个带时间戳的镜头序列变体 (保留原始 作为 residual,照顾那些不吃分解的模型)。 - L2 — 候选生成:对每个 prompt 变体调
T2V()生成多个视频,汇成候选集 。 - L3 — 选优:
PairwiseSelect用二元锦标赛选出当轮最佳 。
自改进阶段(循环 轮)
- L5 — MMAC critique:对当前 champion 生成多维多 agent 反馈 。
- L6 — prompt 优化:
PromptOptimizer(DTPA + 采样)基于反馈产出新一批 prompt 。 - L7 — 重新生成:对新 prompt 再调 T2V 得到 (把上一轮 champion 也放进候选集一起比,保证单调不退化)。
- L8 — 重选 champion:再跑一次
PairwiseSelect更新 。 - L9-10 — 早停:若连续 轮 champion 不变则 break。
实验配置:每轮采样 5 个 prompt、每个 3 变体、每 prompt 生成 2 个视频 = 30 视频/轮,跑 5 轮(1 初始化 + 4 自改进)。MLLM 用 Gemini 2.5 Flash,T2V 用 Veo 3。
子模块实现(可复现细节)
Step 1:结构化时序视频 prompt 规划(PromptPlanner)
- 输入:用户 prompt 。输出: 个 prompt 候选,每个是镜头序列 。
- 每个镜头 默认含 9 个属性槽(跨视/音/上下文三维):(1) Duration 时长(秒)、(2) Scene Type 场景类型(action/montage…)、(3) Characters 关键人/物、(4) Actions 有意义的动作、(5) Dialogues 台词/旁白/屏幕文字、(6) Visual Environment 环境背景、(7) Camera 运镜(景别/移动/角度)、(8) Sounds 音效/配乐/环境声、(9) Moods 情绪基调。
- 两点新意:(i) 时序镜头级分解——把 prompt 拆成语义连贯的时间段,支持对复杂内容的推理;(ii) 细粒度多模态 prompt——每段含视/音/上下文槽,使后续自动化多维 critique 成为可能。MLLM 负责填槽,缺失属性自动补全。
- 规划约束(可配置、默认开):Realism(除非 prompt 指明动画/奇幻,否则锚定真实物理)、Relevancy(只含 prompt 明示或隐含的元素,避免无谓发明)、Creativity(鼓励有益的环境声/特效;短/简单 prompt 抑制过多转场)。
Step 2:带 probing critique 的二元锦标赛选优(PairwiseSelect,Algorithm 2)
不用传统重指标系统(VBench 这类算力贵),而用 MLLM-as-Judge + 视频两两比较(pairwise 比绝对打分更稳、更贴人类偏好、避免无 ground-truth 打分的主观不可靠)。
- 二元锦标赛:每轮把候选视频两两配对,双向比较(交换顺序各比一次,消 token 位置偏置 和 );只有两次结果一致才定胜负,否则随机判,输家淘汰,胜者进下一轮,直到只剩 1 个。
- 两步解耦缓解「同时分析+比较」的双重负担:先对每个视频独立生成 probing critique (Alg2-L1),再把 critique 喂进 pairwise 比较辅助判断。
- 默认选优指标 Visual Fidelity, Physical Commonsense, Text-Video Alignment, Audio-Video Alignment, Engagement,在更多准则上胜出者赢。
- 带惩罚的打分公式():
其中 表示 在准则 上对 的 {Loss, Tie, Win}; 标记 是否违反 ; 是违规惩罚系数。 可自定义为任意约束,不必限于 ——这是把 T2V 常见失败(穿模、物体闪现等)显式扣分的关键机制。
Step 3:多维多 agent critique(MMAC,受陪审团决策启发)
直接用 MLLM-as-Judge 对 Veo 3 这类 SOTA 输出做 critique,即使明令「要挑剔」也往往浅薄无用(高质量输出连人类都难表面挑刺)。MMAC 把评估分解为 Visual, Audio, Context,每个维度建一个三方法庭(公式 1):
- Normal Judge:在好/坏两种立场上批判性打分。Adversarial Judge:生成探针式问题、反论点、专挑视频缺陷打分。Meta Judge:综合双方裁决。
- 输出 , 是 critique 文本、 是 1–10 分。
- 三维度下的细粒度 critique 指标( 默认配置,比 Step 2 更全,因为这里要的是深度):
- Visual:Visual Fidelity、Motions and Dynamics、Temporal Consistency、Camera Focus、Visual Safety
- Audio:Audio Fidelity、Audio-Video Alignment、Audio Safety
- Context:Situational Appropriateness、Semantic Coherence、Text-Video Alignment、Physical Commonsense、Engagement、Video Format(Beginning/Ending/Transitions)
- 案例:对「spaceship entering hyperdrive」,对抗法官能抓出「飞船竖直运动而非观众预期的水平加速」「缺微观动态、尾焰不真实」这类 Normal Judge 和普通 critique 漏掉、但人类直觉认可的缺陷。
Step 4:Deep Thinking Prompting Agent(DTPA)+ 采样
直接让 MLLM 优化 prompt 易过度复杂化、对 critique 理解肤浅。DTPA 在一条 CoT 里做六步自省推理(每步要求 ≥150 词,强制分析深度):
- Review the Issues:圈出所有 meta 分 ≤8 的指标及其定性反馈(无重大问题则跳过、不改)。
- Define the Objectives:明确期望产出类型(explainer/promo/tutorial)与成功标准/格式约束。
- Identify Model Limitations:判断哪些重大问题源自模型能力局限。
- Identify Prompt Issues:找模糊词(“engaging”/“high-quality”)、范围过宽、自相矛盾约束(“short but detailed”)、缺失信息。
- Propose Targeted Revisions:综合上面,给出一组修改动作 。
- Revise:复核修改是否覆盖第 1 步所有重大问题,再精修。
随后 MLLM 据此采样改进 prompt(采样器有硬约束:除非用户明示,禁止加字幕、人声旁白/配乐;鼓励改环境/运镜/活动增强吸引力,但不得改动核心动作与用户意图):
注意 DTPA「只产出修改动作、不直接重写 prompt」——把「诊断」和「执行」解耦。
实验设置与结果
Benchmark:单场景用 MovieGenVideo 随机 100 prompts(follow Dalal et al. 2025);多场景用内部数据集 161 个 ≥2 镜头的 prompts。 模型:MLLM = Gemini 2.5 Flash,T2V = Veo 3(另测弱模型 Veo 2)。 Baseline:(1) Direct Prompting (DP) 直接用户 prompt;(2) Visual Self-Refine (VSR) 迭代评估+改写;(3) Rewrite(按 Vertex AI 指南重写);(4) VPO(按无害/准确/有用三原则扩写)。把 Rewrite/VPO/VSR 按 VISTA 总视频数 scale up(记 †,VSR 版即 VSR++),公平对比。 评测口径:Gemini 2.5 Flash 做 pairwise,10 个准则,双向比较记 Win/Tie/Loss,Win−Loss,交换后冲突记 Tie;一个视频获胜需在至少 3 个准则上更优且不在 Text-Video Alignment 上输。另报 IS、CLIP-Score、VBench 8 视觉指标、NISQA 3 音频指标。
主结果:win/Δ 随迭代单调上升
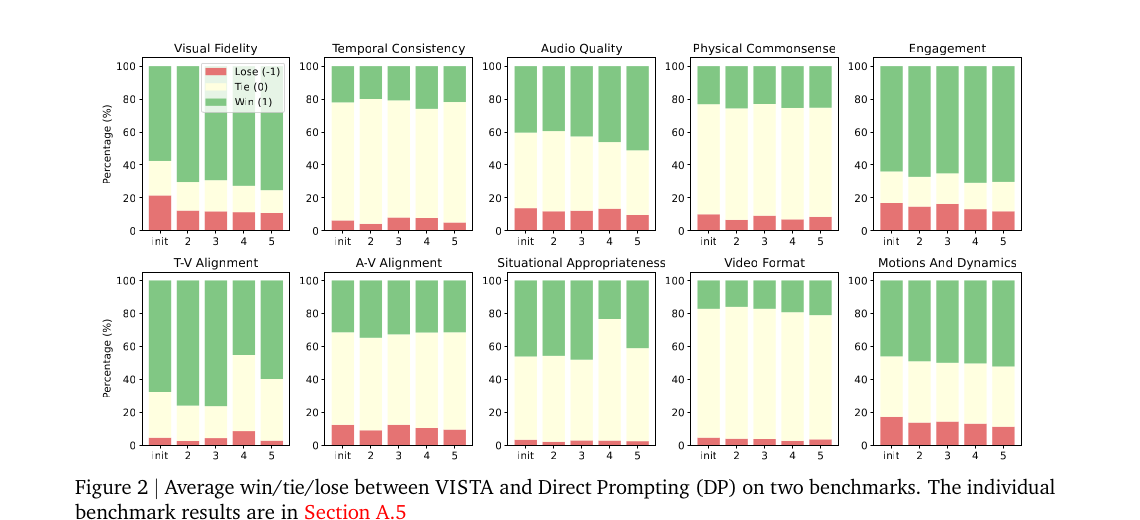
VISTA vs DP,5 轮 Win 率(%)/ Δ(Win−Loss):
| 场景 | Init Win/Δ | iter2 | iter3 | iter4 | iter5 |
|---|---|---|---|---|---|
| 单场景 | 35.5 / 21.1 | 40.7 / 30.8 | 41.4 / 26.5 | 42.4 / 28.3 | 45.9 / 32.0 |
| 多场景 | 37.8 / 27.9 | 39.4 / 26.0 | 38.4 / 29.0 | 43.7 / 31.1 | 46.3 / 35.1 |
对比 baseline 的不稳定:原始 VPO 单场景仅 Win 29%、Δ=4.0%;Rewrite 多场景甚至 Δ=−16.3%(gains 被别处回退抵消)。scale-up 后 baseline(†)有所缓解,但继续加视频数不再涨;VISTA 则随 test-time compute 持续 scale。VISTA 直接对 baseline 的 win 率:单场景 27.8–60.0%,多场景 18.5–53.2%。
细粒度:10 维度 win/tie/lose
常规指标(VBench/NISQA/CLIP,单场景 Table 5 节选)
| 指标 | DP | 最佳 baseline | VISTA |
|---|---|---|---|
| Dynamic Degree | 75.95 | 77.22 | 89.87 |
| Aesthetic Quality | 61.86 | 63.45 | 64.53 |
| Temporal Style | 7.88 | 9.26 | 9.63 |
| CLIP-Score | 0.310 | 0.311 | 0.358 |
| Inception Score | 1.053 | 1.085 | 1.101 |
| Audio Noisiness↑ | 1.74 | 1.73 | 1.88 |
Dynamic Degree 从最佳 baseline 77.22 跃到 89.87(更丰富真实的运动),CLIP-Score +3% abs,音频噪声/不连续也改善 ~0.1/5。
人类评测(50 prompts,多名标注员)
- 头对头偏好:VISTA 66.4% vs 最佳 baseline 33.6%。
- 自改进轨迹打分(1-5):VISTA 3.78 vs VSR(++) 3.33。
- 视觉质量:DP 3.36 → VISTA 3.77;音频质量:DP 3.21 → VISTA 3.47。
成本与 scaling
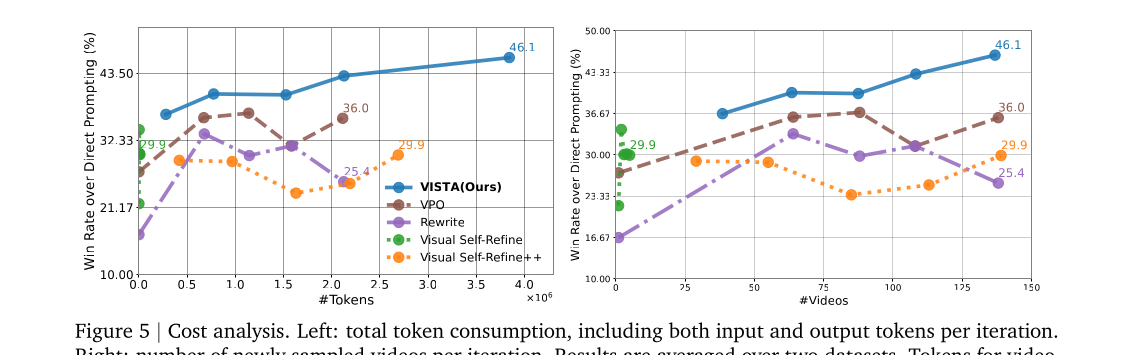
约 0.7M token + 28 视频 / 轮,最终达 46.1% 平均 win 率;token 大头来自 tournament 选优(每个视频输入 >2K token)。扩到 20 轮仍稳定上升,baseline 噪声大且早饱和。
消融(Table 3,半 benchmark,单场景 Init→iter5 win 率)
| 变体 | Init | iter5 | 结论 |
|---|---|---|---|
| 完整 VISTA | 35.5 | 45.9 | — |
| w/o PromptPlanner | 25.2 | 35.1 | 初始化显著变弱 |
| w/o PairwiseSelect | 24.5 | 33.3 | 后期不稳、掉点 |
| 仅 Adversarial Judge | 35.0 | 42.0 | 单场景强但多场景 18.8% 停滞、不泛化 |
| 仅 Normal Judge | 35.0 | 17.2 | 多场景崩溃 |
| w/o DTPA | 35.0 | 37.8 | 提升平滑但天花板低 |
结论:四模块各司其职——PromptPlanner 强化初始化,PairwiseSelect 稳住迭代,正/对抗双法官缺一不可(平衡 critique 深度与有用性),DTPA 的推理式改写决定上限。弱模型 Veo 2 上 VISTA 同样有效(单场景 win 率 15.0→23.8,多场景 27.6→33.3),但增益小于 Veo 3(弱模型难吃透精细优化)。
思考与可参考价值
局限:(1) 评测主依赖 MLLM/自动指标,可能有系统性偏置、漏掉人类在意的质量面(虽有人评但全量人评太贵);(2) 默认 critique 指标隐含某种「视频质量」假设,跨文化/创作风格/用户偏好未必通用;(3) 需要强指令跟随+推理能力的 MLLM 与 T2V 才好使;(4) 算力随轮次线性增长(5 轮 ~150 视频、~3.5M token),tournament 也引入 MLLM 判别偏置;(5) 严格说是 inference-time scaling 而非狭义自迭代训练,目前主要在 Veo 系列验证。
对电商 / 搜推 / Agent 的可借鉴点:
- 「诊断—执行」解耦的 critic 架构:DTPA「只产出修改动作不直接改写」+ 采样器执行,避免单 agent 同时承担分析与生成时的浅薄化。这对电商商品文案/素材自动优化、搜推 query 改写很可直接套用——把「为什么不好」和「怎么改」拆成两个 agent,质量明显更稳。
- 正面+对抗+元 三法庭(MMAC):单一 LLM judge 对高质量候选给不出有效区分(SOTA 输出连人都难挑刺),强制配一个对抗法官专挖缺陷再由元法官仲裁——这套范式可平移到电商风控/合规审核、推荐结果的多维 LLM 评估,比单 judge 更失败敏感、更少 sycophancy。
- 带惩罚的双向 pairwise tournament 选优:无 ground-truth 场景下,绝对打分不可靠,双向交换比较+违规显式扣分( 项可自定义任意硬约束)是个干净的LLM-as-Judge 排序方案,适合素材/落地页/广告创意的离线择优,且天然消位置偏置。
- 可配置的多维度 reward 接口: / / 各步约束全可配——对应到业务即「把领域 KPI(CTR 倾向、品牌调性、合规红线)写成 critic 指标」,无需重训生成模型就能定向引导,落地友好。
- test-time scaling 的多模态范式:对黑盒大模型零侵入、靠「多轮 critique+重生成」换质量,提示了一条不依赖 RLHF 重训的产品化路径;同时也指向「视频/素材质量 reward model」这一新方向。代价是 token/调用成本随轮次线性涨,业务落地需做早停与预算控制。