SkillOS: Learning Skill Curation for Self-Evolving Agents
UIUC × Google Cloud AI Research × MIT
首篇把 "skill curation 本身" 升级为 RL 训练目标的 agent self-evolution 框架。冻结 executor + 训 8B skill curator,curator 通过 insert / update / delete 三个函数调用维护一个 Anthropic SKILL.md 风格的外部 SkillRepo;用 grouped task streams 把延迟稀疏的下游 task outcome 转成密集监督,叠上 composite reward (task / function-call validity / content quality / compression) 进一步加密学习信号。ALFWorld / WebShop / 推理任务上稳超 ReasoningBank / MemP,且 8B 训练出的 curator 比直接拿 Gemini-2.5-Pro 当 curator 还强。
首篇把 “skill curation 本身” 升级为 RL 训练目标的 agent self-evolution 框架。冻结 executor + 训 8B skill curator,curator 通过 insert / update / delete 三个函数调用维护一个 Anthropic SKILL.md 风格的外部 SkillRepo;用 grouped task streams 把延迟稀疏的下游 task outcome 转成密集监督,叠上 composite reward (task / function-call validity / content quality / compression) 进一步加密学习信号。ALFWorld / WebShop / 推理任务上稳超 ReasoningBank / MemP,且 8B 训练出的 curator 比直接拿 Gemini-2.5-Pro 当 curator 还强。
核心思路
问题:LLM agent 被部署在 streaming 任务流(任务按时间逐个到达、必须解完当前才看到下一个)里,却始终是 “one-off problem solver”——不会把过去任务的经验沉淀成可复用资产。业界共识是把经验沉淀成 reusable skills(Anthropic SKILL.md 风格的 procedural memory)是 self-evolution 的天然载体,但真正的瓶颈在 skill curation:什么时候 insert 一条新 skill、什么时候 update 一条过时的、什么时候 delete 一条有害的。这类决策的反馈是延迟、间接、稀疏的——只有当未来某个相关任务被 executor 解出来,才知道之前那次 curation 是否有用。
关键 idea:把 skill curation policy 本身升级为一个 RL 训练目标,而不是用人工规则 / prompt 启发式去做。具体做三件事:
- 模块化双 agent 解耦:冻结一个 agent executor
π_L(负责检索+执行 skill),只训练一个 8B skill curatorπ_S(负责维护外部 SkillRepo),后者通过insert / update / delete三个函数调用像操作系统的 file I/O 一样编辑 markdown skill 文件。 - Grouped task streams:把训练数据按 skill 依赖关系切成 group,让早期任务的 curation 决策被同 group 后续相关任务的 executor 表现反向打分——把延迟稀疏信号转成密集监督。
- Composite reward:task outcome + function-call 合法性 + skill 内容质量(外部 judge)+ SkillRepo 压缩率,四项加权,进一步把下游环境反馈归因到具体的 curation 决策上。
这是 self-evolution 路线上第一篇专门优化 curator(而非 executor 或 skill-using policy)的工作。
整体实现思路
端到端是一个 closed-loop streaming 系统:每来一个任务 x_t,executor 从当前 SkillRepo S_t 检索相关 skill 子集执行、产生 trajectory ξ_t;curator 看着这条 trajectory + 自评对错 + 检索到的 skill 子集,输出一串 curation 操作把 S_t 演化成 S_{t+1},供后续任务用。
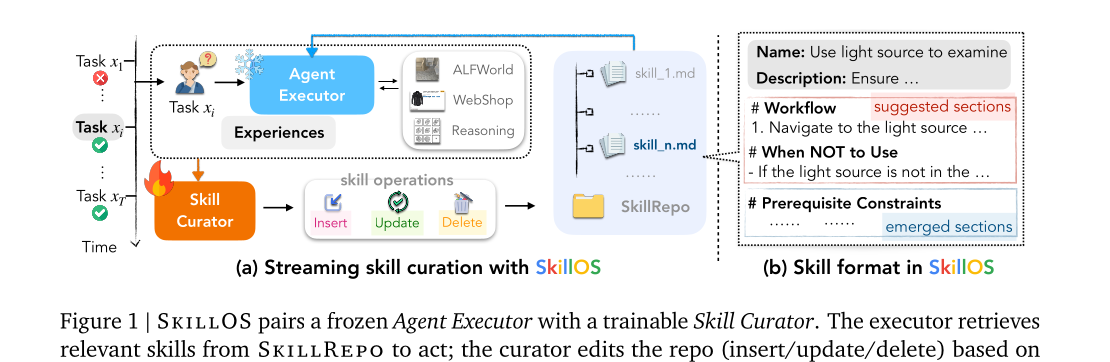
训练侧是把这个 test-time streaming 循环搬进 RL 训练:每个 training step 采一个相关任务 group、从空 SkillRepo 起步,让 curator 在 group 内逐任务演化 repo,最后用 GRPO 按 composite reward 更新 π_S,executor 全程冻结。
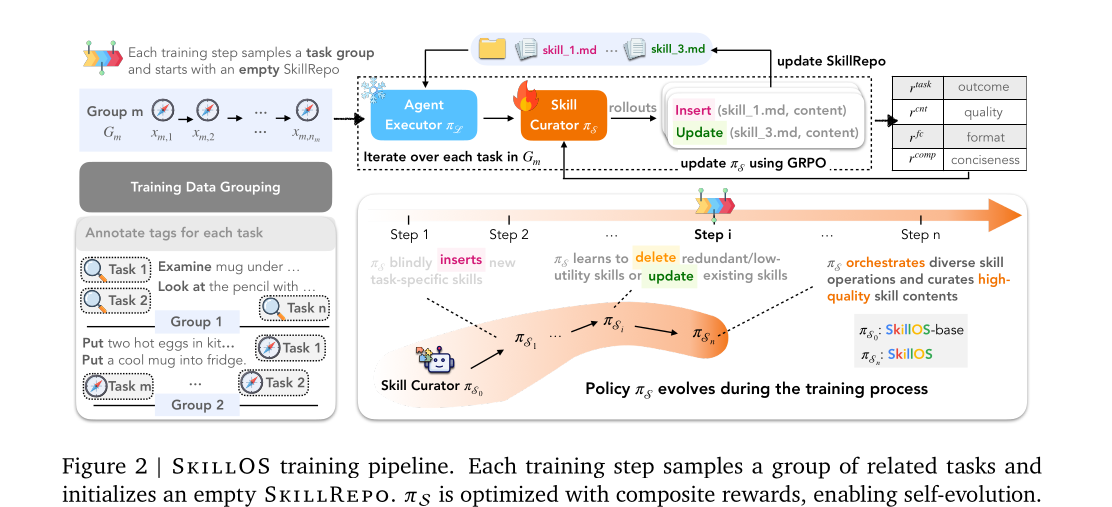
数据预处理用 Gemini-2.5-Pro 给每个任务打 skill-relevant 属性标签,再用 soft-Jaccard 相似度+依赖门控把数据集切成若干有依赖关系的 group。整套 recipe 用 verl 框架在 16×H100 上训 2.5–5 天。
子模块实现(可复现细节)
1. SkillRepo(外部 skill 仓库)
- 输入/输出:时间戳
t维护一个仓库S_t = {s¹_t, ..., s^{N_t}_t},每个 skill 是一个 markdown 文件,遵循 Anthropic 的 SKILL.md 格式:- YAML frontmatter(强制):
---包裹,严格两个 key——name(人类可读的 skill 名)+description(一句话 what/when/why/how,会被未来检索用到)。 - Markdown body:紧接第二个
---后用 markdown 标题组织,建议段如# Workflow、# When NOT to use;要求 atomic / modular / reusable,去掉具体 ID/数字/物名(用变量或概念替代)。
- YAML frontmatter(强制):
- 操作通过函数调用实现,签名:
new_skill_insert(skill_name, content):无相关 skill 时新建。skill_update(skill_name, new_name?, new_content?):skill_name必须精确匹配现有标题;new_content会整段替换旧内容。skill_delete(skill_name):按标题删除。
- 参数以 JSON object 格式给。
S_{t+1} = ApplyOps(S_t, c_t)。
2. Agent Executor π_L(冻结)
- 输入:任务
x_t、环境观测o_t、检索到的 skill 子集S̃_t ⊆ S_t。 - 检索:对每个任务用 BM25 从
S_t取相关子集S̃_t。 - 执行:
a ∼ π_L(· | x_t, o_t, S̃_t),agentic 任务用 ReAct(<think>...</think>+<action>...</action>),reasoning 任务用 CoT(\boxed{}包最终答案)。训练时 executor 也用 Qwen3-8B;测试再换 Qwen3-32B / Gemini-2.5-Pro / Gemini-3.1-Flash-Lite 验泛化。 - 输出:trajectory
ξ_t = {o₁, a₁, ..., o_n, a_n},以及一个 self-judged correctness 信号1[ξ_t](用同款冻结 executor 做 LLM-as-a-judge,各任务有专门的 judge prompt,如 ALFWorld 要求”每个条件在 trace 结尾都成立、部分完成算失败”)。
3. Skill Curator π_S(被训练的,base = Qwen3-8B)
- 输入:trajectory
ξ_t、自评对错1[ξ_t]、检索到的 skill 子集S̃_t。 - 输出:结构化操作序列
c_t = (u¹_t, ..., u^{M_t}_t) ∼ π_S(· | ξ_t, 1[ξ_t], S̃_t),每个u∈ {insert_skill, update_skill, delete_skill},以函数调用形式执行。 - System prompt 要点:角色是把过去 agent 执行经验转成 reusable / general skill;critical constraints 含「No Specifics(去掉具体数字/名字换成变量/概念)」「No Hallucination」「每条 skill atomic/modular/reusable」;要求先分析 trajectory 对错→对的抽可复用知识、错的定位失败点抽修复 skill→再决定 insert/update/delete。
4. Grouped Task Streams(训练实例构造)
把 D = {x_i} 转成 grouped 训练集 G = {G_j} 的两阶段 pipeline:
- Stage 1 — 属性标注:用 Gemini-2.5-Pro(最高 thinking budget + 结构化 JSON 解码)给每个任务打 5 维 phrase-list
Z_i = (T_i, S_i, C_i, R_i, P_i)= 高层 topic / 所需 skill / 数学概念或定理 / 启发策略 / 常见陷阱,每维若干条 ≤5 词的标准化短语,禁止泄露题面/答案。agentic 任务直接用 benchmark 自带任务类型(如 ALFWorld 6 类)当Z_i。 - Stage 2 — 分组构造:以一个 seed 任务为起点迭代追加相关后继任务。
- phrase 相似度:用 soft-Jaccard
SJ_τ(A,B)——精确匹配 + 剩余 phrase 在all-MiniLM-L6-v2cosine 相似度 > 阈值τ下做贪心一对一匹配;m_τ(A,B)= 匹配对数。 - 依赖门控(候选
x_t全部满足才接受):① 共享基础m_τ(C_s,C_t) ≥ κ_C且m_τ(S_s,S_t) ≥ κ_S;② 共享推理m_τ(R_s,R_t)+m_τ(P_s,P_t) ≥ 1;③ 非近重复SJ_τ(T_s,T_t) ≤ θ_T且加权总相似Ω ≤ σ_max;④ 非过度无关Ω ≥ σ_min;⑤ 进阶性(x_t至少引入一个新概念/skill);⑥ 课程方向d_t − d_s ≥ δ_min(reasoning 用 DeepMath 的难度标量d_i做 curriculum,几乎纯 forward)。 - 候选检索:对
{C,R,P}建倒排索引,候选池 = 与 source 共享至少一个精确 dependency phrase(封顶K_inv,均匀下采样),从而避免 group 坍缩到单一窄主题;评分s(x_s,x_t) = Σ_f w_f·SJ_τ(f_s,f_t) + λ·b(d_s,d_t),b是有界难度 bonus;倒排索引无候选过门时回退到大小F的均匀随机池。
- phrase 相似度:用 soft-Jaccard
5. RL 训练目标(GRPO + Composite Reward)
每个 group G = (x₁,...,x_{|G|}) 采 N 个独立 rollout(整条 curation 序列),不同 rollout 演化出不同 repo 历史。Composite reward:
- Task outcome reward:首任务必从空 repo 起(curator 还没更新过),故
r_task = (1/(|G|−1)) Σ_{i=2}^{|G|} 1(ξ_i),即后续 |G|−1 个任务的平均 success——这是 executor-grounded 的下游信号。 - Function call reward:
r_fc = (1/|G|) Σ_i Valid(c_i),Valid(c_i)= 该步生成的函数调用里合法且成功执行的比例。 - Compression reward:
r_comp = (1/|G|) Σ_i (1 − |S_i| / |χ_i|),|S_i|= 应用c_i后 repo 的 token 长度、|χ_i|= curator 输入上下文 token 长度——奖励比上下文更紧凑的 repo,防止 verbatim 复刻 trajectory。 - Content quality reward:
r_cnt = (1/|G|) Σ_i Judge(c_i),外部 judge = Qwen3-32B,按 4 条标准打分(ABSTRACTION 泛化无逐字拷贝 / REUSABILITY atomic 模块化 / ACTIONABILITY body 给可执行指引 / FAITHFULNESS 所有 claim 有 trajectory 支撑),输出 JSON{VALID, ISSUES, EXPLANATION}。 - GRPO:advantage
A_n = r_n − (1/N) Σ_{n'} r_{n'}(组内相对,去掉了均值归一的 std);clipped surrogateL = E_n[min(ρ_n A_n, clip(ρ_n,1−ε,1+ε)A_n)],ρ_n = π_S(c_n|χ)/π_{θ_old}(c_n|χ);advantage 均匀分配到c_n所有 token;丢掉 KL 项鼓励探索。
关键超参:base = Qwen3-8B,lr=1e-6,batch=32,group size=8,λ_f=1.0 / λ_u=0.1 / λ_c=0.05;16×H100 + verl;训练时长 ALFWorld 3 天 / 推理 2.5 天 / WebShop 5 天;结果报 3 次 run 的均值±std。
实验设置与结果
数据/任务:agentic 用 ALFWorld(6 子集共 140 题)+ WebShop;reasoning 用 AIME24 / AIME25 / GPQA-Diamond,训练集从 DeepMath-103k 随机抽 33,000 条。三种 executor scale:Qwen3-8B / Qwen3-32B / Gemini-2.5-Pro。
指标:effectiveness 用 success rate(agentic)/ accuracy(reasoning);efficiency 用每任务交互步数(agentic)/ 每题 token 数(reasoning)。
Baseline:① No Memory;② ReasoningBank(蒸 reusable insight);③ MemP(procedural memory + 高级记忆管理);④ SkillOS-base(未 RL 训练的初始 curator);⑤ SkillOS-gemini(直接拿 Gemini-2.5-Pro 当 curator,不训)。
ALFWorld 平均 SR(Steps↓):
| Executor | No Memory | ReasoningBank | MemP | SkillOS-base | SkillOS-gemini | SkillOS |
|---|---|---|---|---|---|---|
| Qwen3-8B | 47.9 (21.1) | 55.7 (20.1) | 49.7 (21.0) | 53.1 (20.4) | 50.7 (20.8) | 61.2 (18.9) |
| Qwen3-32B | 54.5 (20.3) | 61.4 (18.7) | 55.7 (20.0) | 59.8 (19.2) | 63.6 (18.1) | 68.6 (17.3) |
| Gemini-2.5-Pro | 66.4 (17.7) | 71.4 (16.0) | 74.3 (15.2) | 70.7 (16.3) | 79.3 (14.9) | 80.2 (14.8) |
WebShop(Score / SR / Steps)+ Reasoning(Avg. Acc):
| Executor | 方法 | WebShop Score | WebShop SR | Reasoning Avg.Acc |
|---|---|---|---|---|
| Qwen3-8B | No Memory | 33.3 | 9.8 | 69.6 |
| Qwen3-8B | SkillOS | 40.6 | 16.5 | 73.8 |
| Gemini-2.5-Pro | No Memory | 48.6 | 38.4 | 81.8 |
| Gemini-2.5-Pro | ReasoningBank | 50.8 | 40.2 | 83.5 |
| Gemini-2.5-Pro | MemP | 51.3 | 39.8 | 80.6 |
| Gemini-2.5-Pro | SkillOS | 56.0 | 41.3 | 88.6 |
关键观察:
- 8B trained curator > Gemini-2.5-Pro untrained curator(SkillOS 全面压过 SkillOS-gemini,尤其配小 executor 时)——targeted training 胜过 raw model scale;frontier 生成的 skill 可能与 executor 能力/用法不对齐(curator-executor mismatch)。
- 跨 executor 泛化:curator 在 Qwen3-8B 上训,配从没见过的 Qwen3-32B / Gemini-2.5-Pro 仍稳涨(ALFWorld 8B 47.9→61.2、Gemini 66.4→80.2);RL 收益随 executor 容量复合(vs SkillOS-base,Gemini +9.5 > 8B +7.9)。
- 更高效:ALFWorld 三个 executor 分别比 No Memory 少 2.2/3.0/3.1 步,靠的是 distill 出 procedural shortcut 绕过冗余探索,而非更长 trajectory。
- agentic 收益 >> reasoning:agentic 任务暴露 action ordering / 探索策略 / 恢复行为等 procedural regularity 更易复用;reasoning 的可复用知识更抽象(decomposition / verification heuristic),增益小但更通用——cross-task 实验里从 reasoning 学的 curator 迁到 agentic 特别好,反向不成立。
消融(ALFWorld,Qwen3-8B 既当 curator 又当 executor):
| 配置 | Avg. SR | Steps |
|---|---|---|
| SkillOS-GRPO(完整) | 61.2 | 18.9 |
w/o r_cnt(内容质量) | 58.6 | 20.1 |
w/o r_comp(压缩) | 60.0 | 19.3 |
| w/o grouping(随机任务序列) | 57.3 | 20.6 |
→ grouping 降幅最大(−3.9)是核心;content-quality reward 次之(−2.6);compression reward 影响小但一致。
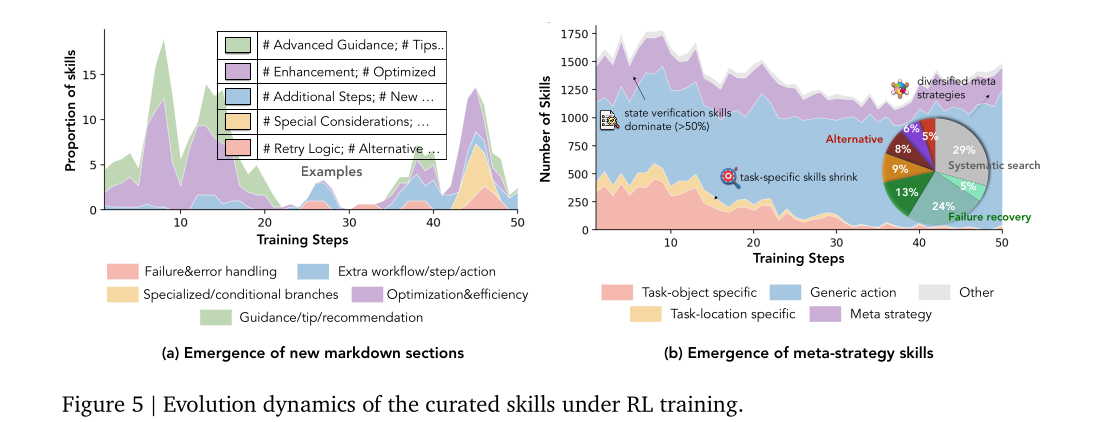
行为演化(Fig 5):训练初期 insert 占绝对多数(curator 只会盲目堆新 skill),随训练 update 显著上升(转向 refine/consolidate 已有 skill),delete 始终小比例但缓增;skill 内容从堆 ”# Tips / # Advanced Guidance / # Optimization” 这类装饰段,演化到 ”# Retry Logic / # Failure Handling / # Conditional Branches” 这类可执行结构;全局上 task-specific skill 萎缩、verification / failure recovery / systematic search / alternative 等 meta-strategy skill 占比升到 30%+。skill 利用分析(Fig 6):SkillOS 在全部评测样本上都调用 skill、coverage 从 53.6%→72.9%,但每题用更少 skill(更精准的选择而非更多上下文)。
思考与可参考价值
局限:① executor 完全冻结,curator 学到的 skill 终究受 executor 能力上限约束,解不了 executor 本就做不了的题;② SkillRepo 用 BM25 检索 + markdown 文件,真到几千 skill 量级时检索/管理代价没讨论;③ task grouping 依赖 Gemini-2.5-Pro 离线打 tag + 一整套 soft-Jaccard 门控,数据预处理成本高、tag 质量本身没消融;④ 动作空间固定在 insert/update/delete 三个,没探讨 merge/split/引用/版本控制等更复杂操作;⑤ 绝对增益(ALFWorld +5.5 over ReasoningBank)虽稳但不算 dramatic,对比的 ReasoningBank/MemP 都相对早期,未与更新的 long-context memory 方法直接比;⑥ v1 未开源代码/数据,复现门槛较高。
对电商/搜索推荐/Agent 方向的可借鉴点:
- “curator vs. executor 解耦、只训 curator” 是把 RL 用到外部知识库维护上的最干净路径,比同时优化两个 policy 更稳——可直接套到任何「agent + 外部 knowledge base」系统:RAG 知识维护、tool 库维护、agent memory 维护、电商商品知识/卖点库的自动沉淀与去重。
- Grouped task streams 本质是「把延迟稀疏 reward 转成密集 reward」的数据组织法,与 GRPO 组内相对优势天然契合——电商/推荐里长周期、跨 session 才显效的优化(如用户长期价值、跨会话偏好沉淀)都可借鉴这种「按依赖分组、用后续相关任务反向打分」的构造。
- Composite reward 配方(task outcome + function-call validity + judge 打的 content quality + token compression)是个能 cap 住 reward hacking 的实用模板:compression reward 防 verbatim 复刻、judge reward 保内容质量、validity reward 保格式合法——做任何「生成结构化资产并打分」的 RL(如自动生成投放文案/选品理由/搜索 query 改写规则库)都可照搬。
- 8B trained curator > Gemini-2.5-Pro:meta-policy 的训练价值 > 推理能力的 raw scale,对工业落地极有意义——小模型 + 任务对齐训练就能做好「管理/编排」类元任务,部署成本可控。
- markdown SKILL.md 沉淀 procedural memory 已是 Anthropic / Claude Code / 本文的三方共识,正在成为 agent skill 的事实标准格式,自建 agent 系统的经验沉淀层值得直接对齐这套格式以互通生态。