Search Self-play: Pushing the Frontier of Agent Capability without Supervision
Alibaba (Qwen Applications)
同一 LLM 同时扮演 task proposer 与 problem solver;用 RAG 验证 proposer 出的题有 ground truth,从而无需人工标注就能持续提升 deep-search agent。
同一 LLM 同时扮演 task proposer 与 problem solver;用 RAG 验证 proposer 出的题确有 ground truth,从而无需人工标注就能持续自我提升 deep-search agent。本文是 ICLR 2026 接收论文,代码与 checkpoint 全开源。
核心思路
一句话问题:RLVR(可验证奖励强化学习)已是训练 LLM agent 的主流范式,但它死死依赖「人工出题 + 标准答案」这对监督信号。在多轮搜索这种长程交互场景里,人工出题根本扩不动;而离线的 query-synthesis(如 WebSailor/ASearcher 的「先注入再模糊化」管线)又有两个硬伤——① 每条合成 QA 都得离线严格校验答案正确性与逻辑一致性,扩展性受限;② 离线静态出题,无法随 solver 能力动态调难度,出太简单 RL 没梯度信号,出太难 solver 学不会。
关键 idea / 范式:把围棋 AlphaZero 的 self-play 真正落到 search agent 上。让同一个 LLM 策略 用两套不同 system prompt 分别扮演两个角色:
- Proposer(出题者):给定一个 ground-truth 答案 ,多轮调用搜索引擎挖掘隐式事实证据,反向工程出一道需要 跳搜索才能解的 deep-search 问题 ;
- Solver(解题者):在不知道答案的条件下,像普通 deep-search agent 那样多轮搜索 + 推理,预测答案。
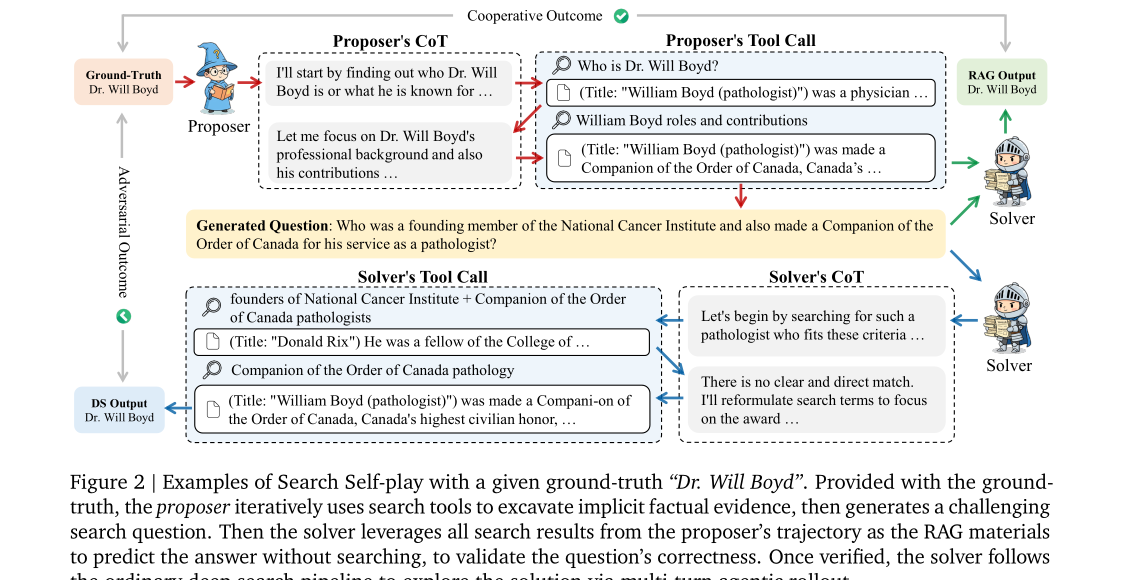
二者构成 min-max 零和对抗博弈:proposer 要出更难的题打败 solver,solver 要不论题多难都答对。但纯对抗会被 hack——proposer 只要狂出错题/无解题,solver 永远答不对,proposer 永远赢。论文的核心工程创新:用 RAG 验证给博弈注入「合作」约束——把 proposer 自己检索到的全部网页文档收集起来当外部知识,让 solver 在「不再搜索、只读这些文档」的 RAG 条件下试解;若能解对,说明「在提供完整资料时这题确有唯一 ground truth、且 proposer 的搜索动作是有意义的」,该题才合法进入训练。这把「题目正确性验证」也交给模型自身完成,彻底去掉人工验证,同时让难度随 solver 能力自适应上升。
整体实现思路
端到端 pipeline(对应 Algorithm 1,每个 RL step):
- 采答案:从预定义答案集 (5 万条,全部采自公开训练集的标答,不带题干)采一个 batch 的 ground-truth 。
- Proposer 出题:对每个 , 用 proposer prompt 多轮搜索后生成候选题 , 是 proposer 轨迹。
- 双重过滤得合法题集 :
- 规则过滤:题须用
<question></question>包裹;剔除空题 / 全程没调搜索 / 题干过短 / 题干里直接含答案; - RAG 验证:把 proposer 轨迹里所有检索文档 当 RAG 材料(再混入 4 篇同 batch 其他轨迹的无关噪声文档),让 solver 在不搜索条件下试解,只有 的题才保留。
- 规则过滤:题须用
- Solver 多次 rollout:对每道合法题 ,solver 正常 deep-search 探索 条轨迹 ,每条算二元奖励 。
- 算双方奖励:solver 奖励即答对与否;proposer 奖励 (solver 越答不对,proposer 越高分)。
- 同步更新同一个 :solver 侧轨迹用 GRPO 更新,proposer 侧轨迹用 REINFORCE 更新。
- Replay Buffer(周期重置):合法题在过滤后往往不够一个满 batch,用 replay buffer 补满,每 10 步清空一次以平衡复用与新鲜度。
下图是 SSP 博弈一轮的完整示意(给定 ground-truth “Dr. Will Boyd”):上方图例区分 proposer/solver 的 CoT 与 tool call、合作/对抗两种 outcome;proposer 反向挖证据出题,solver 先用 RAG 验证(合作)、再正常多轮搜索求解(对抗)。
子模块实现(可复现细节)
形式化与 MDP 建模
搜索 agent 轨迹记为 : 输入 prompt, 第 步 LLM 输出, 是搜索工具返回的 observation。建模为 token 级 MDP :状态空间 = 语言序列空间,动作空间 = 词表 (逐 token 生成),转移 把新 token 追加到末尾,若 形成了完整的搜索调用就额外追加 observation 。给定 system prompt 与 query ,搜索策略 。
- Proposer 策略:,输入是答案 ,输出题目轨迹 ,用 抽出题目。
- Solver 策略:,输入题目,输出解题轨迹 ,用 抽出预测答案。
训练目标(对抗 + 合作的约束式 min-max)
裸对抗目标:
其中 是二元判定函数(用 LLM-as-judge 判语义等价,judge 用 Qwen2.5-32B-Instruct)。合作目标(RAG 验证, 是 solver 在 RAG 条件下的轨迹):
作者发现联合优化合作 + 对抗会训练低效(合作目标要求题完全正确,否则对抗目标会被 reward hacking 污染),于是把合作目标改成 rejection sampling 硬约束——只保留 RAG 验证通过()的题,整体目标变为带约束的 min-max:
Solver 更新:GRPO
每道题 solver rollout 次,组内均值作 baseline:
优势 ,奖励是二元 ,KL 系数 。
Proposer 更新:REINFORCE
即 solver 成功率越低,proposer 拿到的奖励越高——驱动 proposer 出越来越难的题。注意 proposer 每个 prompt 只采 条(REINFORCE),solver 采 条(GRPO),这是经济性与效果的权衡(详见消融)。
Proposer 出题 prompt 的关键设计(反向工程)
prompt 要求 proposer从答案出发反向构造 跳链:① 不直接搜答案本身,而是先头脑风暴一个「关联概念」(相关历史事件 / 关键人物 / 地理位置 / 独特属性 / 上位类别);② 用探索性搜索找到连接「关联概念」与最终答案的「桥接事实」,抽出一个唯一可验证的「preceding fact」作为第 跳答案;③ 把这个 fact 当新目标迭代回溯,直到凑齐 链;④ 链的起点成为题面初始线索。Critical Rules:必须基于搜到的事实(禁假设)、题面不能含答案或中间步骤的剧透、必须无法靠常识直接答(强制走搜索)、搜索跳数须精确等于指定值、答案须唯一确定。格式严格用 <think>/<search>/<answer>/<question> 标签,偏离格式则零奖励。
关键工程细节与超参
| 类别 | 配置 |
|---|---|
| 框架 | VeRL + SGLang 异步多轮 tool-integrated rollout |
| 学习率 / warmup | 1e-6 / 5 步 |
| Global / mini-batch | 256 / 128 |
| Max prompt / response | 4096 / 8192 tokens |
| KL 系数 / rollout 温度 / valid 温度 | 0.01 / 1.0 / 0.0 |
| Proposer:算法 / 采样数 / warm-up | REINFORCE / / 禁用 |
| Solver:算法 / 采样数 | GRPO / |
| Batch 采样 | Replay Buffer(每 10 步周期重置) |
| RAG 验证 / 噪声文档数 | 开 / 4 篇 |
| 搜索工具 | 本地 E5 retriever + Wiki-2018 语料,每 query 取 top-3 文档 |
| 单轨迹最大搜索轮数 | 10 |
| 训练步数 | 150–200 步 |
| RAG 验证用 solver | Qwen2.5-32B-Instruct(提采样效率) |
Loss masking:跟 Search-R1 一样,对 <information></information> 内的检索内容做 loss mask,不计入训练梯度以稳训练。答案集 :5 万条标答,采自 Search-R1 训练集(NQ + HotpotQA)+ ARPO 释放训练集;平均词长 14.53,主题分布人物 26.3% / 时间日期 12.9% / 地理 9.2% / 音乐 8.4% / 体育 5.5% 等,不含题干。
实验设置与结果
Benchmark:7 个 QA 数据集——GeneralQA 三个(NQ、TriviaQA、PopQA)+ Multi-HopQA 四个(HotpotQA、2Wiki、MuSiQue、Bamboogle)。每个随机采 500 条(Bamboogle 用全部 125 条)。指标:LLM-as-judge(judge = Qwen2.5-32B-Instruct)的 pass@1 准确率,百分制。
Baseline / 覆盖设置:① from-scratch(Qwen2.5-7B Base/Instruct);② 跨架构泛化(LLaMA-3.1-8B、Qwen3-8B);③ 在 search 专用 agent 上 continual RL(ZeroSearch-7B、Search-R1-7B、R-Search-7B,从各自最佳 checkpoint 起训);④ scale up(Qwen2.5-14B/32B-Instruct)。
主结果(Table 1,“+SSP” 一致优于各自基座)
| 设置 / 模型 | NQ | TriviaQA | PopQA | HotpotQA | 2Wiki | MuSiQue | Bamboogle | Avg |
|---|---|---|---|---|---|---|---|---|
| Qwen2.5-7B-Base | 32.0 | 33.2 | 25.0 | 18.0 | 10.8 | 11.0 | 26.4 | 22.3 |
| + SSP | 54.2 | 73.6 | 56.0 | 52.8 | 33.2 | 24.0 | 47.2 | 48.7 (+26.4) |
| Qwen2.5-7B-Instruct | 44.2 | 64.0 | 36.4 | 45.0 | 32.8 | 16.8 | 51.2 | 41.5 |
| + SSP | 54.8 | 73.4 | 51.8 | 51.8 | 38.8 | 21.2 | 54.4 | 49.5 (+8.0) |
| LLaMA-3.1-8B | 50.2 | 65.2 | 45.8 | 34.6 | 19.4 | 11.4 | 30.4 | 36.7 |
| + SSP | 58.0 | 75.8 | 55.4 | 44.2 | 34.4 | 16.2 | 40.0 | 46.3 (+9.6) |
| Qwen3-8B | 53.6 | 76.0 | 50.8 | 54.2 | 48.0 | 26.6 | 58.4 | 52.5 |
| + SSP | 56.0 | 78.2 | 55.0 | 58.0 | 51.5 | 28.0 | 67.2 | 56.3 (+3.8) |
| Search-R1-7B | 56.6 | 75.4 | 57.2 | 58.2 | 45.2 | 29.6 | 55.2 | 53.9 |
| + SSP | 57.8 | 78.0 | 58.4 | 60.4 | 45.6 | 30.6 | 59.2 | 55.7 (+1.8) |
| R-Search-7B | 50.8 | 71.0 | 53.8 | 54.0 | 56.4 | 29.8 | 53.6 | 52.8 |
| + SSP | 52.4 | 74.2 | 56.8 | 54.2 | 58.0 | 31.4 | 55.2 | 54.6 (+1.8) |
| Qwen2.5-32B-Instruct | 58.0 | 78.4 | 53.4 | 57.0 | 48.4 | 27.4 | 63.2 | 55.1 |
| + SSP | 62.6 | 82.8 | 55.0 | 62.8 | 49.2 | 32.0 | 69.6 | 58.5 (+3.4) |
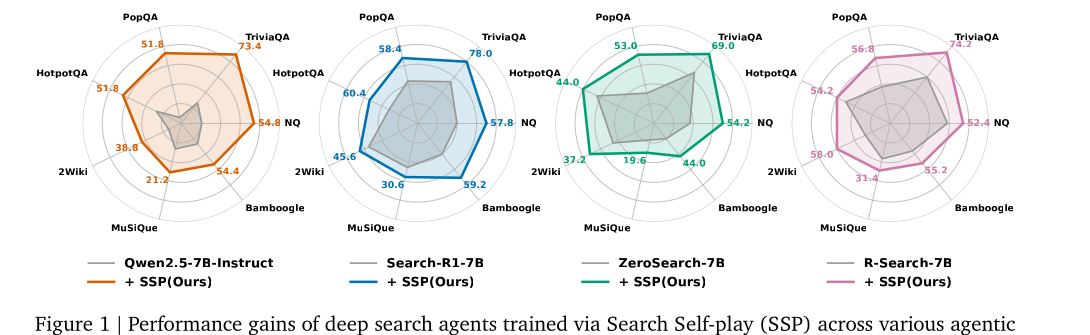
结论:from-scratch 增益最猛(base 模型 +26.4,TriviaQA 单项 +40.4);instruct 模型 +8.0;模型无关(LLaMA/Qwen3 都涨);对已大量训过 search 任务的强 baseline 也能继续涨(continual RL 仍 +1.8);scale 到 32B,5/7 个 benchmark 取得 SOTA。
下图是 4 个 baseline 「+SSP」前后的雷达对比,可直观看到 7 个轴上几乎全面外扩:
消融 1:自博弈 vs 固定对手(Table 2,Qwen2.5-7B-Instruct)
| 变体 | GeneralQA 平均(NQ/TQA/PQA) | Multi-Hop 平均 | Avg |
|---|---|---|---|
| 基座 | — | — | 41.5 |
| +SSP (Solver-Only,固定 proposer) | — | — | 44.2 |
| +SSP (Proposer-Only,固定 solver) | — | — | 41.7 |
| +SSP (完整自博弈) | — | — | 49.5 |
完整 SSP 显著胜出。训练动态揭示原因:Solver-Only 的 in-game reward 迅速饱和到 ~0.9(题分布静态,solver 很快掌握后过拟合,NQ/2Wiki 评测先升后降);Proposer-Only 评测先降后略回升(学到通用工具用法但不足以解多跳);完整 SSP 的 solver reward 先升后略降——这不是退化,而是 proposer 协同进化、出更难题压住 solver 成功率的关键证据,形成「难度随 solver 水平永动调整」的自适应课程。
消融 2:RAG 验证 + 噪声文档数(Table 3)
| 配置 | GeneralQA Avg | Multi-Hop Avg |
|---|---|---|
| 无 RAG 验证 | 49.5 | 36.7 |
| RAG 验证 + 0 噪声文档 | 58.5 | 38.2 |
| RAG 验证 + 1 噪声文档 | 58.5 | 36.9 |
| RAG 验证 + 4 噪声文档 | 60.0 | 41.6 |
| RAG 验证 + 7 噪声文档 | 57.8 | 35.9 |
去掉 RAG 验证性能大跌(尤其 GeneralQA)。注入无关噪声文档是防 hack 的关键:不加噪声时 proposer 会出「易-RAG 但难-deep-search」的退化题(如先搜 5 张人物传记,再问”谁出生最早”——在固定 5 文档里 RAG 秒解,但放开搜索自由度后条件不足无法解);混入 4 篇随机噪声逼 proposer 出「答案被检索证据强且唯一支撑」的稳健题。4 篇最优,7 篇过多反而干扰验证。
其他附录消融
- Batch 采样策略(Qwen2.5-7B-Base):Dummy Padding 41.4 < Dynamic Resampling 42.4 < Replay Buffer 全复用 44.4 < Replay Buffer 周期重置 48.7(兼顾复用密度与新鲜度,主实验采用)。
- RL 算法组合(proposer-solver):RF-RF 42.0(9.1 s/step)< GRPO-RF 46.5(50.1 s)< RF-GRPO 49.5(83.4 s,默认) < GRPO-GRPO 50.9(504.4 s,约 6× 慢)。结论:GRPO 放在 solver 侧(多轨迹信用分配直接提解题质量)比放 proposer 侧有效;GRPO-GRPO 仅微涨不值 6× 代价。
- Proposer 奖励设计:把无效题奖励从 0 改成 -0.1(惩罚)会触发「死亡螺旋」——惩罚逼 proposer 提高策略熵去逃离负奖励 → 生成更随机更易无效 → 有效题率塌到 ~0.0056 → solver 在静态旧题池上假性涨分却不泛化。说明 proposer 奖励须精心标定,惩罚式奖励会摧毁整个自博弈。
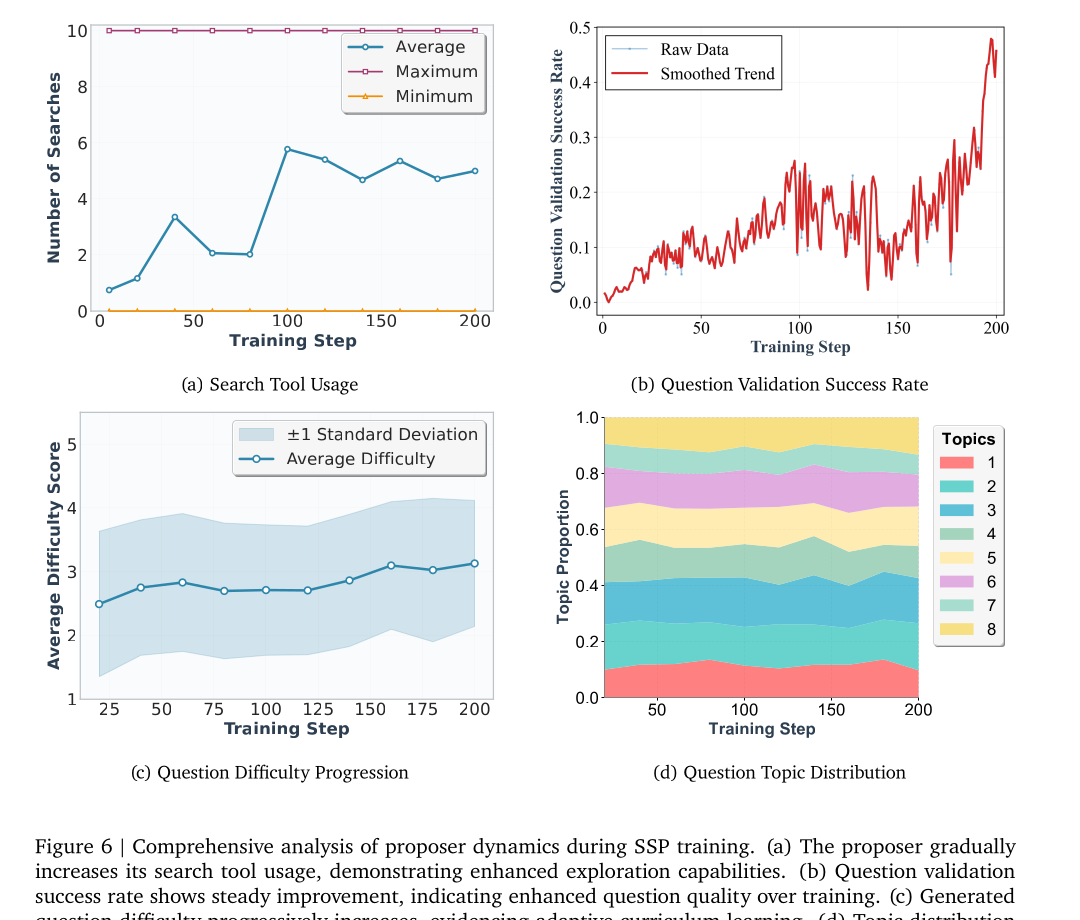
- Proposer 训练动态:搜索调用次数稳升、题目验证通过率从 ~0% 升到 ~50%、生成题难度单调上升(用 DeepSeek-V3.2 打分)、LDA 主题分布全程均衡(不塌缩到单一题型)。
思考与可参考价值
局限:① RAG 验证默认「检索到的=正确的」,对 web 噪声 / 谣言敏感,本文用本地 Wiki-2018 干净语料规避,开放 web 上鲁棒性存疑;② proposer 奖励极其脆弱(-0.1 惩罚即崩),调参成本高;③ 只覆盖 search 一类工具,未推广到 code / browse / GUI;④ solver 后期增益放缓部分因搜索轮数硬上限 10,scale 这个上限可能解锁更多收益;⑤ RAG 验证用 32B judge,验证成本不低,且「高精度低召回」会丢掉部分本可用的合法题。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- 「出题即数据飞轮」范式:电商里很多任务(商品比价问答、多跳属性检索、导购意图理解)缺人工标注。可仿 SSP 让同一模型一边从「已知答案/已知商品」反向生成多跳 query,一边解题,把答案池替换为商品库实体 / 历史成交记录,零标注扩 RL 数据。
- 「可执行性验证」替代「模型自评」是降 reward hacking 的通用模板:SSP 不靠 proposer/solver 自我打分,而靠一个客观、低成本可重放的验证器(RAG 能否答对)裁判题目合法性。电商场景可把验证器换成「能否被现有检索系统召回到唯一 SKU」「价格/库存是否在数据库可核验」,给自动出题加客观闸门。
- 难度自适应课程 = 在线对抗压力:相比离线难度分级,让 proposer 随 solver 实时涨水平出更难题,天然形成 curriculum。推荐/搜索的难负样本挖掘、hard query 合成可借此思路在线生成,避免静态难度过拟合。
- 工程坑提醒:噪声注入(4 篇)防退化题、replay buffer 周期重置防过拟合、GRPO 放 solver 侧、proposer 用零奖励而非惩罚——这几条都是可直接迁移到自博弈/自蒸馏管线的实操经验。
一句话:SSP 是 self-play 在 search agent 上首个干净跑通、且把「题目正确性验证」也无监督化的工作,代表了「task synthesis as scaling axis」思潮,下一步显然是把 RAG 验证换成更通用的「环境可执行性」验证迁到 code/browse agent。