Learning to Evolve: A Self-Improving Framework for Multi-Agent Systems via Textual Parameter Graph Optimization
Future Living Lab of Alibaba(阿里巴巴)
把 MAS 抽象成一张 "文本参数图"(agent / tool / workflow 都是可优化节点),用 GRAO(Group Relative Agent Optimization)做元学习式的图优化,使多 agent 系统能自动 debug 自己。
核心思路
一句话问题:多智能体系统(MAS)的性能高度依赖一堆自然语言配置(每个 agent 的 system prompt、tool 描述、workflow / 通信协议),手工调这些”文本参数”(Agent Engineering)是高维、非确定、不可微的搜索,几乎没有收敛保证;而现有自动 prompt 优化(DSPy / TextGrad / PromptAgent / EvoPrompt)只会”拍平成一段文本”去改,没有结构感知,无法定位是某个 tool 定义的 bug 还是 workflow 的逻辑漏洞;更要命的是这些优化器是静态的,改完这次不会从历史经验里学到怎么改得更好。
关键 idea / 范式:把 MAS 优化重新表述为图演化问题。三个支柱:
- TPG(Textual Parameter Graph):把整套 MAS 配置 Θ 拆解成一张有向图 ,节点是 role / logic / tool 三类语义单元,边是它们之间的依赖与数据流。优化从”改一大段 prompt”变成”对图做节点改写 + 结构编辑”。
- Textual Gradient(文本梯度):从执行轨迹 trace 里产出结构化自然语言反馈(正梯度 δ⁺ 蒸馏好行为、负梯度 δ⁻ 指出具体错误并给纠正建议),充当不可微世界里的”梯度信号”沿图回传。
- GRAO(Group Relative Agent Optimization):一个元学习层,把每次”问题→图编辑→有效性分数”存进经验记忆库;遇到新错误簇时检索语义相似的历史经验、按有效性分数做”组内相对”排序,把最有效的当 few-shot 喂给 Optimizer LLM——让优化器本身越用越强,并抑制迭代中的灾难性遗忘。
名字来源类比 GRPO:GRPO 在 token / 回答组里用组内相对优势更新策略,GRAO 把这套”组内相对”搬到 agent 图编辑空间——一组历史优化经验按效果相对排序,指导下一次图编辑。
整体实现思路
TPGO 是一个闭环 pipeline,对一个给定的 baseline agent 框架(ReAct / MiroFlow)跑至多 5 轮离线优化迭代,端到端三阶段:
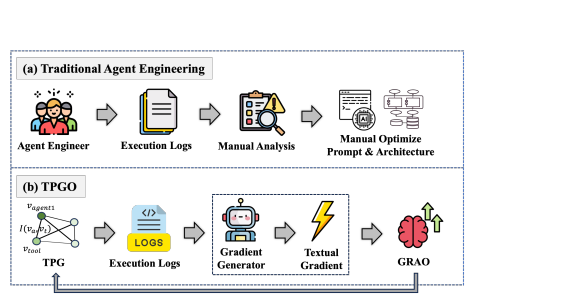
端到端流程(对应下图三个 phase):
- Graph Construction(建图):用 Parser LLM 把每个 agent 的原始 system prompt 按语义功能层级拆成 role / logic / tool 节点,序列化成嵌套 JSON 的 PromptNode 结构 = TPG。
- Gradient-Driven Evolution(梯度驱动演化):对一个 batch 任务跑 MAS 收集轨迹 ;Reflector(诊断模型)对每条轨迹产出 δ⁺/δ⁻ 文本梯度;把所有 δ⁻ embedding 后 DBSCAN 聚类成”错误簇”(一类反复出现的失败模式);每个簇交给 Optimizer LLM 产出一个机器可读的图编辑提案 ∆G(REWRITE_NODE / PRUNE_EDGE / ADD_NODE / ADD_EDGE),应用得到 。
- GRAO(元优化):把 ∆G 在”贡献了该错误簇的那个任务子集”上做定向验证,算有效性分数 ;把 (问题上下文 C, 图编辑 ∆G, 分数 E) 三元组写进 Optimization Experience Memory;下一次遇到相似错误簇时检索 + 按 E 重排,把最优经验当 in-context demo 指导 Optimizer。若本轮验证掉点则回滚到上一版图(失败经验仍保留在记忆里)。
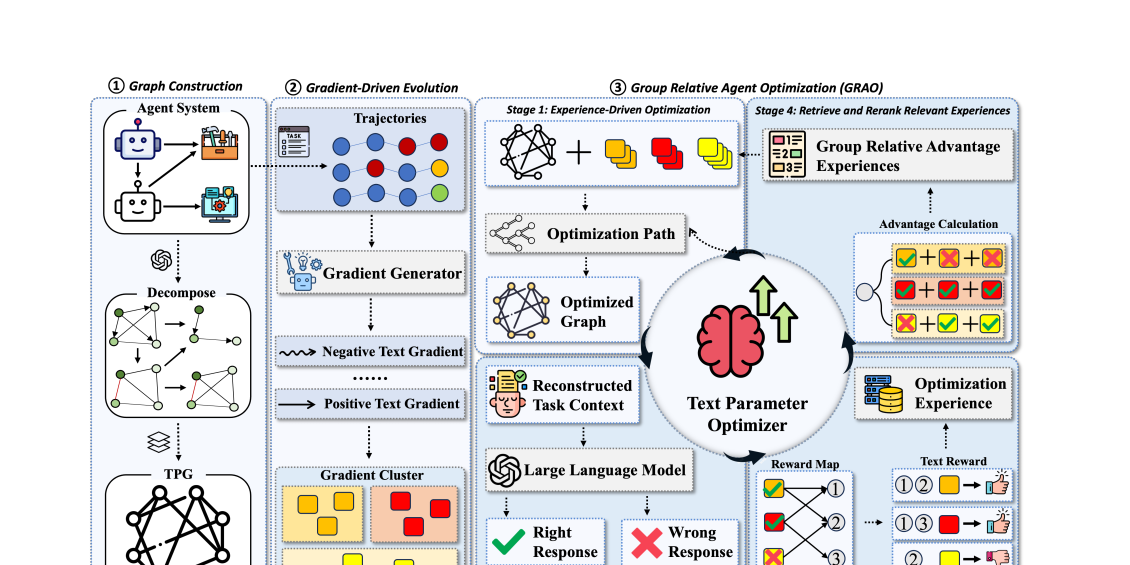
子模块实现(可复现细节)
0. 形式化与目标
MAS 由文本参数 参数化, = 所有 agent prompt + tool 描述 + 通信规则。给定任务分布 (数据集 ),系统 输入 产出 与轨迹 。目标:
其中 是奖励指标(如 success rate), 是所有文本配置构成的庞大、离散、非结构化空间——这正是难点。TPGO 给 强加”图结构”再做基于学习的搜索。
1. TPG(Textual Parameter Graph)—— 输入/输出与表示
- 输入:各 agent 的原始 system prompt(单段大文本)。
- 输出:有向图 ,。
- 节点 V(三类语义单元,外加一个
generic兼容类型):- Role 节点:persona、高层目标、战略指令。
- Logic 节点:推理协议、操作约束、验证规则、链式思考 / workflow 指令。
- Tool 节点:功能描述、API 规范、调用示例。
- 边 E:有向边 表示 的内容为 提供信息 / 约束 / 上下文。三种典型关系:intra-agent(Role→Logic)、tool integration(Logic→Tool)、inter-agent communication(跨 agent 子图连边)。
- 嵌套结构:高层 agent 组成主图,其内部组件是互联子图。
- 两种优化算子:① 节点内容改写(类比参数微调,如改 Tool 节点内容提升工具调用正确率);② 结构修改(剪边可吊销某 agent 对某 tool 的访问,加节点/边可引入新技能或新 agent)。
- Parser LLM 关键指令:按语义功能而非排版切分;父节点组织章节、叶节点装实际文本;不拆分原子指令 / 代码块 / JSON / 紧耦合示例;一个节点要么有 children 要么有 content(互斥);保留原意、不改写不优化。
2. Textual Gradient(文本梯度)—— 三步生成-聚合-应用
Step 1 轨迹诊断与梯度生成:对 batch 轨迹 ,Reflector(诊断模型)对照 ground-truth / 理想行为找差异,产出
- 正梯度 δ⁺:从成功轨迹蒸馏高质量推理 / 工具使用模式(如”正确把问题拆成子步 A、B、C”),强化正确行为的模板。
- 负梯度 δ⁻:从失败轨迹指出具体错误(幻觉、工具误用)并给纠正动作(如”幻觉了 search 工具的参数,应该先调 list_parameters”)。
- 关键约束:描述可泛化的行为模式而非任务特定事实;忽略纯环境/外部服务造成的失败;若给了参考答案,只用来诊断行为、不得泄露或复述答案(防答案泄漏,imitative 设定下尤其重要)。Reflector 输出 schema:
{summary, error_list:[δ⁻...], experience_list:[δ⁺...]}。
Step 2 梯度聚合(聚类):逐条 δ⁻ 直接改易噪声且互相冲突。把所有 δ⁻ 文本 embedding(all-MiniLM-L6-v2 句向量),先按 cosine 相似度去近重复,再用 DBSCAN(,min_samples,不预设簇数)聚成”错误簇”,每簇 = 一类反复失败(如”误解某 tool 约束”/“低效 inter-agent 通信”)。目标是治根因而非补单点。
Step 3 生成并应用优化提案:每个错误簇交给 Optimizer LLM,输入 = 簇代表错误描述 + 当前图 ,输出机器可读 ∆G,四种图编辑算子:
| 算子 | 含义 |
|---|---|
REWRITE_NODE(v, new_content) | 改某节点文本(内容精修) |
PRUNE_EDGE(u, v) | 剪边,禁用错误路径 |
ADD_NODE(v_new, content) | 引入新技能 / 约束 |
ADD_EDGE(u, v) | 建立新依赖 / 逻辑流 |
应用得 。Optimizer 输出 schema:{problem_context, modifications:[{operation, target, new_node, new_content, addresses_errors:[idx], rationale}]}。指令强调:编辑前先诊断根因;偏好可复用修复而非任务特定补丁;给了历史经验就模仿有效策略、避开无效策略;保持与当前图内部一致。
3. GRAO(元优化)—— 让优化器自身进化
- 有效性打分:∆G 应用后只在”贡献该错误簇的任务子集”上重跑(定向验证,避免全量重评的高成本),对比新旧结果算 = 在问题任务子集上的成功率。
- 优化经验记忆(持久化):每条 entry = 三元组 (问题上下文 C, 解决方案 ∆G, 结果 E)(实现里还存 rationale)。随时间积累 problem-solution-outcome 数据集。
- 自适应提案生成(in-context 检索增强):新错误簇 来时——① 检索语义相似的历史 组成一”组”;② 按有效性 做组内相对排序(“group relative”:哪些历史策略对这类错误最有效);③ 把最高分正/负样例格式化成 few-shot 前置到 Optimizer 上下文,引导产出更精准的 。
- 回滚机制:每轮监控验证集表现,掉点就回滚到上一版图;但失败更新仍留在记忆(作为”别这么改”的反例)。所有提案 / 图状态 / run 元数据全归档以便复现。
关键超参 / 实现配置
- Meta 组件 LLM:Parser / Reflector / Optimizer 统一用 Gemini-2.5-Pro,temperature 0.7、top-p 0.95,每次 API 调用最多重试 3 次(指数退避),走 OpenAI 兼容接口。
- 执行 backbone:ReAct 用 GPT-4.1 / DeepSeek-V3.2(temp 1.0、top-p 1.0);MiroFlow on GAIA 用 GPT-5(主 agent reasoning effort=high,子 agent=medium,temp 1.0、top-p 1.0)。
- 聚类:DBSCAN over all-MiniLM-L6-v2,、min_samples。
- 迭代:默认至多 5 轮优化。图更新由 prompt manager 原子应用(支持节点改写 / 插入 / 删除)。
实验设置与结果
数据集与两种优化设定
- MCP-Universe(exploratory optimization,无 gold 答案,靠执行反馈自纠):评测子集 146 个任务,四个域——Repository Management / 3D Designing / Browser Automation / Web Searching。Reflector 只看执行 trace、不给 gold。
- GAIA(imitative optimization,有可验证 golden 答案):从 165 题 public validation 过滤出 text-only 142 题(Level1:49 / Level2:71 / Level3:22);Reflector 额外拿到 ground-truth 答案,但 prompt 被约束只产”泛化行为反馈”防泄漏。
- Baseline 框架:ReAct(GPT-4.1 / DeepSeek-V3.2)on MCP-Universe;MiroFlow(GPT-5)on GAIA。
- 指标:Success Rate(pass@1,单次产出正确答案的任务比例,主指标);Average Time(秒,wall-clock,衡量效率)。
主结果 1:MCP-Universe(exploratory)
| Model | Repo Mgmt | 3D Design | Browser Auto | Web Search | Overall |
|---|---|---|---|---|---|
| ReAct (GPT-4.1) | 36.70 | 55.26 | 26.41 | 5.45 | 30.96 |
| + TPGO (1 iter) | 40.79 | 52.63 | 27.05 | 8.33 | 32.2 |
| + TPGO (3 iter) | 41.21 | 60.53 | 32.41 | 12.73 | 36.72 |
| + TPGO (5 iter) | 41.21 (+4.51) | 65.79 (+10.53) | 33.74 (+7.33) | 14.55 (+9.10) | 38.82 (+7.86) |
| ReAct (DeepSeek-V3.2) | 42.18 | 60.03 | 20.51 | 16.36 | 34.77 |
| + TPGO (1 iter) | 40.85 | 60.52 | 20.38 | 17.14 | 34.72 |
| + TPGO (3 iter) | 44.18 | 63.16 | 26.13 | 21.81 | 38.82 |
| + TPGO (5 iter) | 45.52 (+3.34) | 63.16 (+3.13) | 28.03 (+7.52) | 30.73 (+14.37) | 41.86 (+7.16) |
GPT-4.1 overall 30.96→38.82(相对 +25.4%),最大增益在 Web Searching(5.45→14.55);DeepSeek-V3.2 在 Web Searching +14.37 点。说明纯靠环境反馈,TPGO 能定位并修复工具使用逻辑的系统性缺陷。
主结果 2:GAIA(imitative)
| Model | Level 1 | Level 2 | Level 3 | Overall | Avg Time (s) |
|---|---|---|---|---|---|
| MiroFlow (GPT-5) | 78.8 | 77.5 | 44.4 | 73.8 | 4014 |
| + TPGO (1 iter) | 76.9 | 71.2 | 45.5 | 70.59 | 3680 |
| + TPGO (3 iter) | 82.1 | 73.1 | 54.5 | 75.7 | 2278 |
| + TPGO (5 iter) | 90.6 (+15.0%) | 79.1 (+2.1%) | 63.6 (+43.2%) | 81.6 (+10.6%) | 1765 (−56.0%) |
即便对强 baseline MiroFlow,overall 73.8→81.6(相对 +10.6%),且平均耗时砍半(4014→1765s,−56%)——优化过程剪掉了低效推理路径。增益最大在最难的 Level 3(44.4→63.6)。
消融(Browser Automation 子集,ReAct)
| 方法 | Success Rate |
|---|---|
| TPGO (full) | 28.03 |
| w/o Textual Parameter Graph | 25.13 (−2.90) |
| w/o Structural Graph Edits | 24.90 (−3.13) |
| w/o Clustering | 26.52 (−1.51) |
| w/ Random Clustering | 19.97 (−8.06) |
结论:① 去掉 TPG 退回整段 prompt 改写掉 2.90 点 → 结构化模块化有用;② 去掉结构图编辑掉 3.13 点 → 增益不只来自局部文本改写,结构修改贡献明显;③ 语义聚类重要,随机分组反而比不聚类更差(19.97,−8.06)→ 噪声聚合有害,三者互补而非可替换。
稳定性:GRAO 防灾难性遗忘
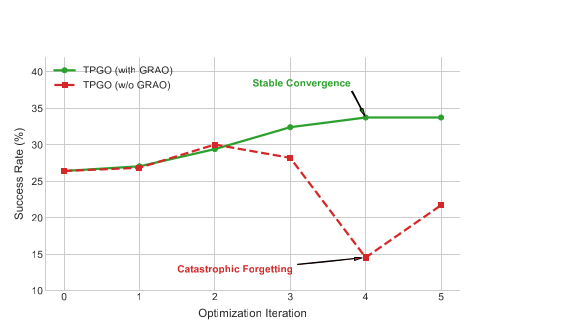
两者都从 26.41% 起。带 GRAO:第 3 轮升到 33.74% 后稳定。不带 GRAO(只用最新错误簇、不检索历史经验):第 2 轮峰值 30.03% 后第 4 轮暴跌到 14.55%(远低于 baseline)——没有历史上下文,优化器过拟合最近失败、引入伤害已有能力的更新。GRAO 同时提升最终性能与鲁棒性。
跨域泛化(仅在 Browser Automation 上优化)
| Method | Browser | Web | Repo | 3D |
|---|---|---|---|---|
| ReAct (DS-V3.2) | 20.51 | 16.36 | 42.18 | 60.03 |
| + TPGO | 28.03 (+7.52) | 18.18 (+1.82) | 44.91 (+2.73) | 63.16 (+3.13) |
只在 Browser 域优化,三个未见域也全涨 → 学到的是通用的工具使用 / agent 行为改进,而非记忆域特定补丁(缓解”只是过拟合定向验证子集”的质疑)。
成本-收益(GAIA 一轮优化)
| 指标 | 值 |
|---|---|
| 总 token | 19.9M |
| 总 wall-clock | 1380s(8 路并发) |
| 摊销 token / 轨迹 | 73.7K |
| 摊销时间 / 轨迹 | 5.6s |
一次性离线优化成本(5.6s/轨迹)相对 baseline 单任务平均执行 4014s 很小,换来 +7.8 点成功率和 −56% 耗时;当优化在反复部署中摊销时实用。
思考与可参考价值
局限(论文自陈 + 延伸):① 经验框架、无形式化优化保证——“文本梯度”是启发式反馈而非解析梯度,误差会沿图传播放大;② 优化环每个提案都要在任务子集上验证,成本不低,更大 benchmark / 更复杂系统扩展性受限;③ 强依赖底层 LLM(Parser/Reflector/Optimizer 全靠 Gemini-2.5-Pro),弱模型会产噪声反馈;④ 当前只做文本参数 + 预定义图编辑算子,不涉及 backbone 选型、数值超参、节点合并/子图生成等更丰富结构变更;⑤ 图节点粒度仍靠 Parser 的先验切分,缺与端到端 RL(直接 fine-tune agent)的横向对比。
对电商 / 搜索推荐 / Agent 方向的可借鉴点:
- 把”调 prompt”升级成”改图”:电商多 agent 链路(导购→比价→下单→客服)里,单段 prompt 改写很难定位”是 tool schema 写错还是 workflow 漏了一步”。把每个 agent 的 role / 工具描述 / 业务规则拆成可独立优化的节点,能做精准的”剪掉某 agent 对某高危工具的访问""给客服 agent 加一个强制校验节点”等结构编辑——这对工程化、可审计的 agent 系统很有指导意义。
- 定向验证 + 经验记忆 = 低成本在线自改进的可落地范式:不必每次全量重评,只在贡献错误的任务子集上验证;把”问题→改动→效果”三元组持久化并按效果检索复用,天然适配电商场景”反复出现的同类 badcase”(如某类商品的属性抽取错误、某类 query 的意图误判)的批量根因修复。
- 聚类治根因而非补单点 + 防遗忘回滚:负反馈先 DBSCAN 聚成失败模式再统一改,避免逐条 badcase 打补丁导致 prompt 越改越乱、互相冲突;GRAO 的”掉点回滚 + 失败经验留档”对生产环境迭代很关键(消融里随机分组 −8 点、无 GRAO 第 4 轮暴跌,都是工程上必须警惕的反例)。
- “答案只用来诊断行为、不泄漏”的反馈设计:imitative 设定下让 Reflector 产泛化行为反馈而非灌答案,对推荐/搜索的离线优化避免过拟合验证集、保泛化,是个可直接借鉴的 prompt 约束技巧。
- GRPO 思想迁移:把”组内相对优势”从 token/回答空间搬到 agent 图编辑空间,提示我们 RL 里成熟的相对排序信号可以泛化到任何”一组候选+可打分”的离散优化场景。