Agent-World: Scaling Real-World Environment Synthesis for Evolving General Agent Intelligence
ByteDance Seed × 人民大学
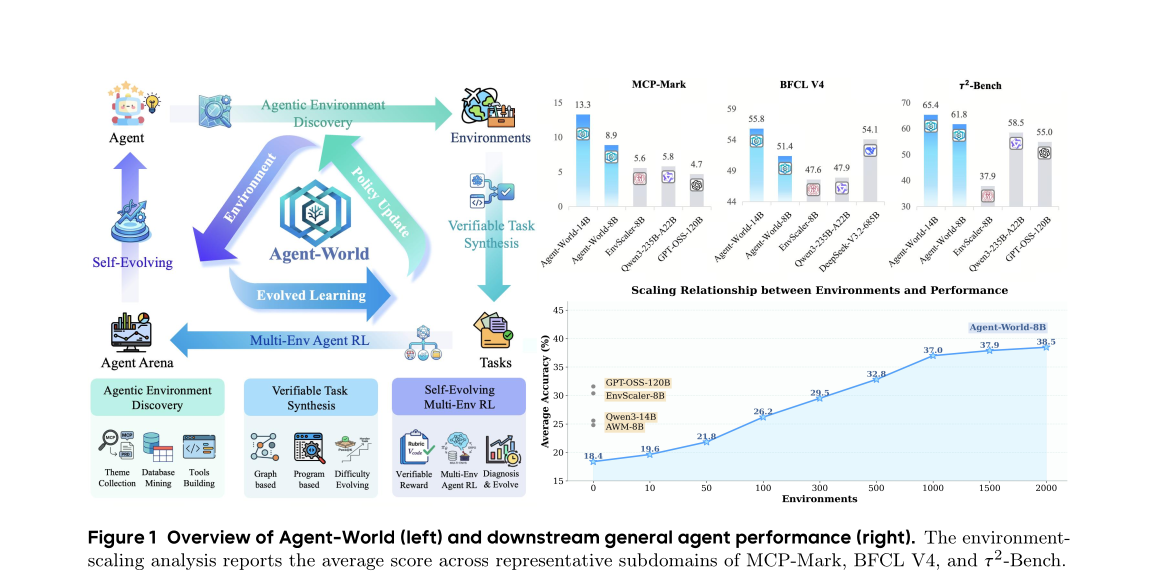
端到端 "环境 + agent 共进化" arena:自动从真实主题挖环境、生工具、合成可验证任务,再用多环境 RL 训 agent,由 self-evolving arena 自动诊断短板、定向扩环境。共合成 1978 环境 / 19822 工具,平均任务 >15 轮交互。
核心思路
一句话问题:通用 Agent 训练严重受限于”真实、可执行、可验证、有状态”环境的稀缺——现有环境要么是 LLM 纯模拟(易幻觉、偏离真实动态),要么来自有限的开源 toolchain(复杂度低、不能支撑长程多状态任务),且缺乏用环境去”诊断 agent 短板并定向补强”的 life-long learning 机制。
关键 idea:把”环境数据”提升为 Agent Scaling 的第一公民。论文构建一个自演化训练竞技场 Agent-World,它由两个紧耦合组件闭环组成:
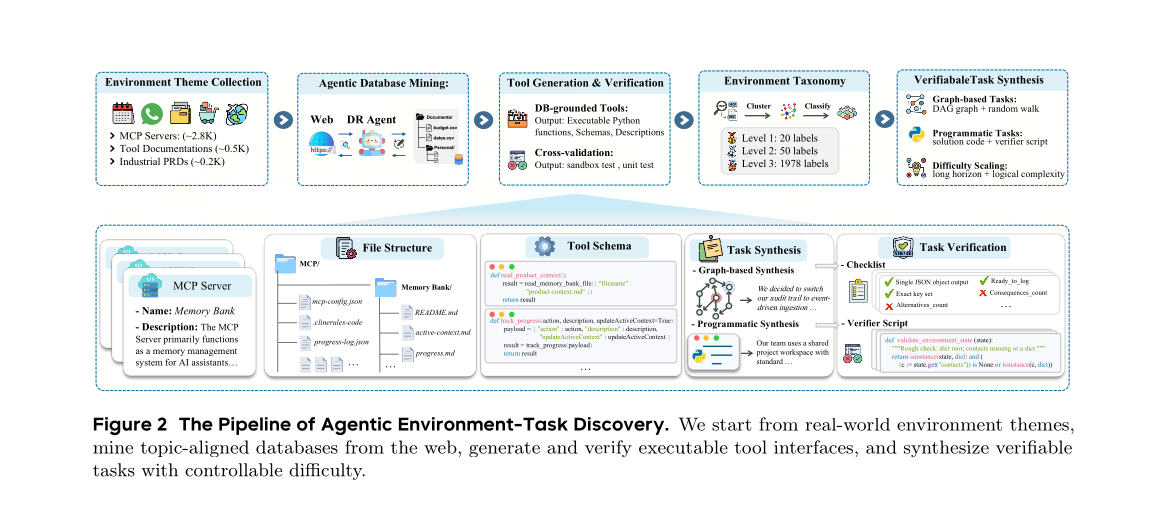
- Agentic Environment-Task Discovery:用 deep-research agent 从数千真实主题(MCP servers / 工具文档 / 工业 PRD)自主从 Web 挖掘 topic-aligned 数据库 + 生成并验证可执行工具,再用图游走 / 程序化两种方式合成可验证、难度可控的长程任务。最终产出 1978 个真实环境 + 19822 个工具。
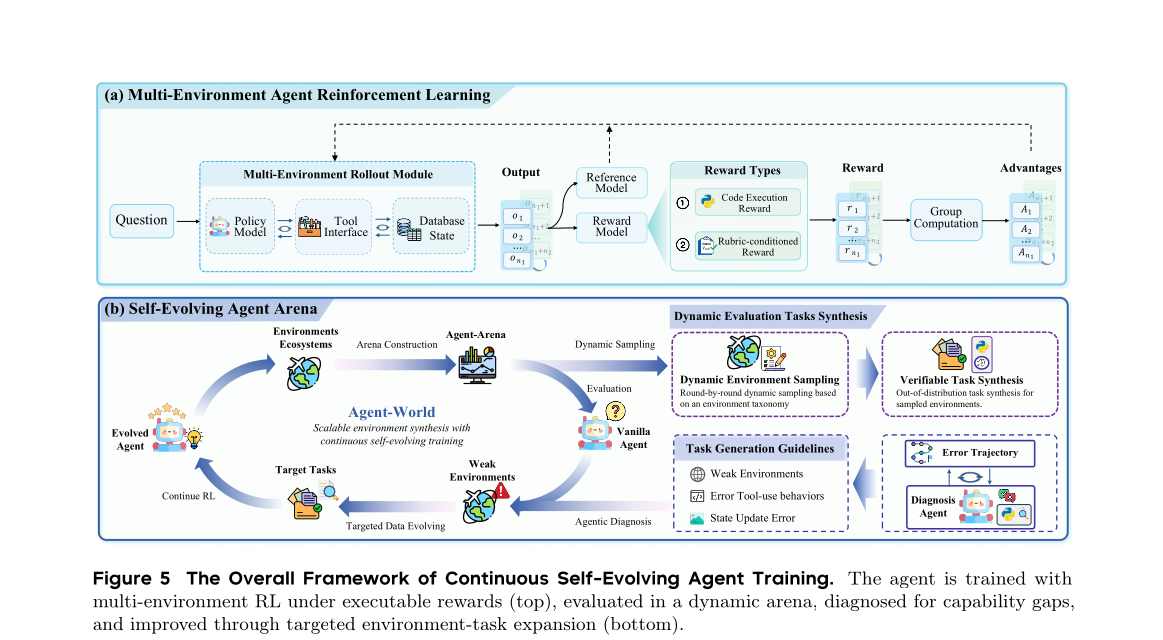
- Continuous Self-Evolving Agent Training:多环境 RL(GRPO + 可执行 reward)训练策略;同一环境生态又当作动态诊断 arena,自动发现弱环境与失败模式,定向再合成环境/任务,让”策略 ↔ 环境”正反馈共进化。
核心范式总结:environment scaling 是与 reward scaling / data scaling 并列的独立可扩展轴,论文用”环境数量”和”自演化轮次”两条 scaling 曲线给出经验证据。
整体实现思路
端到端 pipeline 是一个两阶段闭环:
真实主题 M ──┐
            ▼
[阶段1] Agentic Environment-Task Discovery
  主题采集(MCP/Doc/PRD) → 深研 agent 挖数据库 D → 数据库复杂化 φ
  → coding agent 生成工具 f + 单测 → 交叉验证过滤 → 环境生态 E={(D,F)}
  → 层级 taxonomy(20/50/2K) → 可验证任务合成(图游走 X_graph + 程序化 X_prog)
            ▼
[阶段2] Continuous Self-Evolving Agent Training
  冷启 SFT(40K 轨迹) → 多环境 GRPO RL(可执行 reward)
  → Self-Evolving Arena: 分层抽样 arena → 动态合成新评测任务
    → 在 agent-tool-database 协议下评测 → 诊断 agent δ 定位弱环境 W^(r) + 任务生成指南 G_guide^(r)
    → 定向再合成 X_target^(r) → continue RL → π^(r+1)
            └──────── 反馈回阶段1 再扩环境 ────────┘
形式化基础是把多轮 agent 交互建模为 POMDP (U, S, A, O, P):
- 全局状态
S = S_E × S_H:环境状态s_E(数据库/文件/服务)+ 对话状态s_H(历史/约束/偏好)。s_E不可直接观测,只能从工具观测O_E间接推断。 - 每个环境显式参数化为
e = (D, F):D是环境状态的存储载体(结构化记录/文件),F = {f_k}是可读写D的可执行算子集合,调用工具会诱导环境状态转移。 - 动作
A = A_tool ∪ A_resp(工具调用 vs 自然语言回复);a_t ∈ A_tool时执行f改写D、产生结构化观测o_E_{t+1},a_t ∈ A_resp时只更新对话状态、环境状态不变。
子模块实现(可复现细节)
1. 环境主题采集(Environment Theme Collection)
- 输入/输出:三路真实来源 → 种子主题集
M = M1 ∪ M2 ∪ M3。M1MCP Servers(~2.8K):从 Smithery(smithery.ai/servers)取真实 MCP server 规范,每个带结构化 JSON(数据源描述 + 标准化工具定义)。M2Tool Documentations(~0.5K):过滤开源 tool-use 数据集,抽工具定义文档,用 LLM 反向映射到环境主题。M3Industrial PRDs(~0.2K):产品需求文档,天然含背景 / 领域 workflow / 系统接口,直接作主题锚点。
2. Agentic Database Mining(数据库挖掘 + 复杂化)
-
deep-research agent
G:以策略模型π_θ为核心 + 外部工具集T(search / browser / code compiler / OS 工具)。对每个主题m迭代检索挖数据,再用 OS 工具结构化持久化:D(m) = G(m; π_θ, T) -
数据库复杂化
φ:单次挖掘往往规模小、结构简单,故迭代N轮扩充丰富:D^(n+1)(m) = φ(D^(n)(m), m, T),n = 0,…,N-1,最终D^(N)(m)。 -
关键点:用真实 Web 结构化数据而非 LLM 合成数据库(区别于 EnvScaler 等纯合成路线),强调真实数据可实时更新、高价值。
3. 工具接口生成与验证(Tool Generation & Verification)
-
coding agent
ψ(带 code compiler + OS 工具T̂):给(m, D^(N)(m))生成候选工具 + 单测:(f̂, Ĉ_f̂) = ψ(m, D^(N)(m); π_θ, T̂),每个工具一对多映射到测试集Ĉ_f̂。 -
交叉验证过滤:工具测试精度
Acc(f̂; Ĉ_f̂) = (1/|Ĉ_f̂|) Σ_{ĉ∈Ĉ_f̂} 1[f̂(ĉ) passes]保留条件(三者同时满足):① Python 编译通过;②
Acc > 0.5;③ 该环境至少含 1 个有效工具 + 1 个有效测试用例。过滤后得F(m),环境生态E = {(D^(N)(m), F(m)) | m∈M}。
4. 环境 Taxonomy 构建
- 层级聚类(hierarchical clustering)数千主题 → 50 个簇心;回溯每簇样本随机选代表;基于 TOUCAN taxonomy,用 GPT-OSS-120B 做监督式摘要识别簇主题 → 50 个二级标签;再请 3 名标注员合并抽象成 20 个一级类型,交叉验证讨论定稿。
- 最终:20 一级 / 50 二级 / 2K+ 三级(1978)标签,记一级类别集合
C。用于跨环境任务合成 + 分层 arena 构建。
5. 可验证任务合成(Verifiable Task Synthesis)
两条互补策略,均靠 sandbox 执行收集 trace、导出 ground-truth、保证可验证。
(a) 图游走任务 X_graph(建模顺序工具依赖):
- 工具图构建:对每个环境构造全连通带权有向图
G=(V,E),节点是工具,边由 LLM 评估三种依赖:- 强依赖
f_i → f_j, w=3:f_j输入严格依赖f_i输出(如create_order拿order_id再get_order_details),严格有向边。 - 弱依赖
f_i ↔ f_j, w=2:f_j输入可来自f_i也可另取(查库 / 常量),双向边。 - 独立边
f_i ↔ f_j, w=1:无参数级依赖,作 fallback 保证全连通、防 random walk 死路。
- 强依赖
- 随机游走:优先从”有输出但无强依赖前驱”的起点
f_1出发,第t步按边权w偏置概率采样后继,得原始序列τ=[f_1,…,f_k];强/弱依赖传上一工具输出,独立边从D^(N)(m)随机采有效值;LLM 复核剪冗余得精炼可执行序列τ*。 - 任务与 rubric 生成:LLM 据
τ*起草q_init(严禁含工具名/库 schema 防泄漏)→ sandbox 逐步执行记录 trace 与返回 → LLM 据真实字段精炼出q_final+ 严格 JSON ground-trutha*+ 结构化评分 rubricR(字段完整性 / schema 匹配 / 数值容差等)。 - 一致性验证:部署 ReAct agent 在 sandbox 求解 5 次,≥2 次得一致答案才保留。
(b) 程序化任务 X_prog(建模条件/循环/聚合等非线性推理):
- LLM 据工具 schema + 库描述生成复杂 query
q_prog(不暴露工具/库细节)→ LLM 当 solver 写端到端可执行 Python 解π_code(含 for/if-else/统计聚合),包在 ReAct loop 里遇错自动 debug → 执行得a*。 - 验证码生成:把
(q_prog, π_code, a*)喂 LLM 生成可执行验证脚本V_code(a, a*),含多级断言 + 自定义逻辑,校验候选答案a和数据库状态s_E是否满足全部约束;同样 ReAct debug 保可靠。同样 5 次跑、≥2成功才留。
难度 scaling(两策略通用):增大随机游走最大步数扩工具链、提高弱依赖/独立边采样概率削弱”明显顺序输出”依赖、程序化侧增加唯一工具数与调用数 + 注入条件分支 + 跨库聚合排序过滤;最后改写任务描述抹去工具名/执行逻辑,逼 agent 从抽象目标自行推断 workflow。
6. 多环境 Agent RL
-
多环境 rollout:三组件闭环——LLM 策略
π_θ、工具 runtime(执行F(m)、维护 DB 连接/缓存等环境侧状态)、数据库状态D^(N)(m)。给任务x,π_θ据h_t=(o_0,a_0,…,o_t)采动作a_t;输出y=(τ, a_final),τ为交互轨迹。全局 batch 内每个任务配独立动态环境实现多环境 rollout。 -
结构化可验证 reward(两类):
r(x,y) = I[ (1/n)Σ_j I[Judge(x,y,r_j)] == 1 ],若x∈X_graph(rubric-conditioned LLM-as-judge,全部 criterion 通过才得分)r(x,y) = I[ Execute(V_code(y, y*)) ],若x∈X_prog(sandbox 跑验证脚本校验答案/状态) -
策略更新(GRPO):每任务采
G条轨迹,算 token 级 advantageÂ_{i,t},clipped importance ratio + KL 惩罚到参考策略:J_GRPO(θ) = E[ (1/G)Σ_i (1/|y_i|)Σ_t min( r_{i,t}(θ)Â_{i,t}, clip(r_{i,t}(θ),1-ε,1+ε)Â_{i,t} ) − β·D_KL(π_θ‖π_ref) ]
7. Self-Evolving Agent Arena(自演化诊断闭环)
-
Arena 构建:基于层级 taxonomy 分层抽样,每个一级类别
c∈C随机选K=5个环境,合成E_arena(兼顾覆盖广度与评测成本)。 -
动态评测任务合成:每轮
r对 arena 每个环境按 §5 新合成一批 fresh 可验证任务X_arena^(r)(m_i)(图+程序化,各带R或V_code),环境与任务都逐轮动态防过拟合静态评测。 -
Agentic Diagnosis:诊断 agent
δ(带 Python 解释器 + search)输入:① 每任务失败 trace(工具日志/中间观测/validator 反馈)② 按环境与 taxonomy 的错误分布统计 ③ 环境元数据(工具 schema + 库描述);输出 (a) 排序后的弱环境集W^(r) ⊆ E_arena+ (b) 环境专属任务生成指南G_guide^(r)(m)(刻画缺失能力,如错误工具用法 / 状态更新错误)。 -
共进化循环:据
W^(r)和G_guide^(r)重跑任务合成得定向训练集X_target^(r)(弱因状态多样性不足时还触发φ数据库复杂化)→ 从π^(r)continue RL 得π^(r+1):π^(r) --evaluate--> W^(r) --diagnose+target--> X_target^(r) --continue RL--> π^(r+1)
关键超参(复现要点)
| 项 | 值 |
|---|---|
| 环境挖掘/任务合成/诊断 policy | GPT-OSS-120B |
| 冷启 SFT 轨迹 | 40K(由 in-house Doubao-Seed-1.8 生成) |
| backbone | Qwen3-8B / 14B |
| RL 算法 | GRPO(RLVR) |
| clip ratio | ε_low=0.2, ε_high=0.28 |
| 最大轨迹长度 / 单步生成上限 | 80K / 32K tokens |
| 每步采样任务数 × rollout | 32 × 8 |
| 解码 | temperature=1.0, top_p=1.0 |
| arena 每一级类别抽环境数 K | 5 |
| 任务一致性保留阈值 | 5 次跑 ≥2 次成功 |
| RL 样本规模 | 5K |
实验设置与结果
数据集规模:1978 环境 / 19822 工具;每环境平均 >10 工具(部分 >40);数据库文件类型多样(json/csv/sql/html/tex/yaml);所有任务 ≥7 轮交互,平均 >20 轮,非平凡部分 >40 轮;用 Doubao-Seed-2.0-pro 在 Pass@10 下测,多数任务仅 10 次成功 1 次、少量全 0,证明难度 scaling 有效。
Baseline 三组:① 闭源前沿(GPT-5.2 High / Claude Sonnet-4.5 / Gemini-3 Pro / Seed2.0);② 开源基座 8B–685B(DeepSeek-V3.2-685B / GPT-OSS-120B / Qwen3-235B-A22B / Qwen3-8B/14B/32B);③ 开源环境 scaling 方法 7B–14B(Simulator-8B / TOUCAN-7B / EnvScaler-8B / AWM-8B/14B / ScaleEnv-8B)。
Benchmark:23 个,覆盖 agentic tool-use(MCP-Mark / BFCL V4 / τ²-Bench)、advanced AI assistant(SkillsBench / ARC-AGI-2 / Claw-Eval)、通用推理(MATH500/GSM8K/MATH/AIME24/25/KOR-Bench/OlympiadBench)、agentic search & coding(WebWalkerQA / SWE-bench Verified+Multilingual / Terminal-Bench 1.0+2.0 / GAIA / HLE)、knowledge & MCP(MMLU / SuperGPQA / MCP-Universe 5 子域)。每实验跑 8 次取均值。
主结果(三大 agentic tool-use 套件,Avg %)
| Method | MCP-Mark | BFCL V4 | τ²-Bench |
|---|---|---|---|
| GPT-5.2 High(闭源) | 53.1 | 75.0 | 80.2 |
| Claude Sonnet-4.5 | 33.3 | 68.8 | 84.7 |
| Gemini-3 Pro | 50.8 | 68.8 | 85.4 |
| Seed 2.0 | 54.7 | 76.6 | 83.0 |
| Qwen3-8B(基座) | 2.4 | 81.3 | 26.2 |
| Qwen3-14B | 3.4 | 81.3 | 32.4 |
| Qwen3-235B-A22B | 5.8 | 87.5 | 58.5 |
| DeepSeek-V3.2-685B | 36.7 | 37.5 | 80.3 |
| EnvScaler-8B | 5.6 | 93.8 | 37.9 |
| AWM-14B | 5.1 | 75.0 | 39.0 |
| ScaleEnv-8B | – | – | 38.5 |
| Agent-World-8B | 8.9 | 93.8 | 61.8 |
| Agent-World-14B | 13.3 | 93.8 | 65.4 |
注:MCP-Mark/BFCL 上 Avg 列对应论文表 1 各子项均值(如 BFCL 的 Relevance 子项 Agent-World 达 93.8)。重点结论:Agent-World-8B 在三套件一致超过所有环境-scaling baseline 且超过 Qwen3-235B-A22B;14B 比 8B 再 +约5%,BFCL-V4 上 55.8(论文文中口径)甚至胜 DeepSeek-V3.2-685B(54.1)。基座 Qwen3-8B 在 MCP-Mark 仅 2.4 → 提到 8.9,τ²-Bench 26.2 → 61.8,提升显著。
环境数量 scaling
环境数 0→10→100→500→1000→2000(1978),在 4 个代表域(MCPMark-Postgres / BFCL-WebSearch / BFCL-Multi-Turn / τ²-Bench-Airline)评测:四域均值 18.4% → 38.5%(+20.1,翻倍多);MCPMark-Postgres 4.8→19.9,BFCL-WebSearch 7.0→47.0。阶段性跃升集中在 10→100、100→500(早期补关键交互模式覆盖),500→2000 边际递减但仍正向(后期补细粒度鲁棒性)。
自演化轮次消融(Table 2)
| Model / Round | τ²-Bench | BFCL-V4 | MCP-Mark(Post.) |
|---|---|---|---|
| Agent-World-14B (base) | 60.2 | 52.4 | 29.5 |
| +1 round | 63.5 (+3.3) | 54.9 (+2.5) | 36.3 (+6.8) |
| +2 rounds | 65.4 (+1.9) | 55.8 (+0.9) | 38.1 (+1.8) |
| EnvScaler-8B (base) | 37.9 | 47.6 | 9.5 |
| +1 round | 40.2 (+2.3) | 49.1 (+1.5) | 13.9 (+4.4) |
| +2 rounds | 41.6 (+1.4) | 50.0 (+0.9) | 15.1 (+1.2) |
结论:① 两轮单调增益,MCP-Mark 涨幅最大(Agent-World +8.6 / EnvScaler +5.6),因其最吃状态追踪与真实 MCP 交互,正契合”诊断定位弱环境 → 定向合成难例”目标;② 自演化 loop 对非本方法基座(EnvScaler-8B)同样有效,不依赖 Agent-World 初始化;③ 第二轮增益小于第一轮(早期修 pattern 级错误,后期攻长程残余失败),递减但仍正。
其他泛化结论
- 通用推理不退化:7 个数学/推理 benchmark 上 Agent-World-8B profile 最佳,核心数学无 degradation。
- 长程 search & coding 增益最大:WebWalkerQA/SWE-Verified/SWE-Multilingual/Terminal 1.0+2.0/GAIA/HLE 一致超基座与 EnvScaler;EnvScaler-8B 在 SWE / Terminal 1.0 反而低于其 Qwen3-8B 基座。
- AI assistant 跨尺度稳定:8B→14B 在 SkillsBench(9.2→12.6)/ARC-AGI-2(6.5→8.5)/Claw-Eval(30.5→31.5) 一致提升,而多数 baseline 8B→14B 无稳定增益(Qwen3 在 ClawEval 25.6→24.7 反降)。
- 训练动态:GRPO 下 reward 稳定上升,entropy 稳步增长不坍缩——模型适配陌生 API/异构状态转移时维持甚至扩大探索空间。
思考与可参考价值
局限:
- 23 benchmark 是否覆盖真实工业 agent 场景仍待验证;arxiv v1 标注 “Working in progress”,结果可能更新,社区独立复现尚未跟上。
- 自动 capability-gap 诊断的准确率没有充分披露:诊断 agent
δ的弱环境定位 / 错误归因到底多准、误诊会不会把 RL 带偏,缺定量评估。 - MCP-Mark 绝对分仍很低(8B 仅 8.9,14B 13.3),离闭源(50+)差距巨大——环境 scaling 缩小了相对差距但绝对能力天花板未突破。
- 环境合成大量依赖 GPT-OSS-120B 这一强 teacher(挖库/合任务/诊断都用它),合成质量与该模型强相关,蒸馏味较重。
- 数据库主要靠 Web 真实数据,受可访问性/版权/时效约束;“复杂化
φ”和”难度 scaling”靠 prompt 启发式控制,缺可量化的难度旋钮。
对电商 / 搜索推荐 / Agent 方向可借鉴点:
- environment-as-data 思路直接可迁电商:电商客服/履约/比价天然是有状态多工具 workflow(查库存→下单→改日历),可照
e=(D,F)把”商品库/订单库/物流库 + 可执行工具”封成环境,用图游走(强/弱/独立依赖)自动合成长程可验证任务,省去人工标 SOP。 - 可执行 reward + rubric/验证码双轨值得搬:电商任务多有客观终态(订单状态/库存数/金额),程序化
V_code校验数据库终态比 LLM-judge 更可靠、抗 reward hacking;主观环节再用 rubric-conditioned judge 兜底。 - 自演化诊断闭环可作为线上 agent 的持续运维范式:用真实/影子环境周期性合成 fresh 评测任务 → 诊断 agent 定位弱品类/弱工具 → 定向补数据 continue RL,比一次性静态训练更贴”线上分布漂移”,且实验证明对非本方法基座也有效,可低成本接入既有模型。
- 环境数量 scaling 的阶段性规律(10→500 跃升、500+ 递减)提示工程上先广覆盖品类/工具再深挖的资源分配策略,避免一上来堆单一垂域。
- 任务难度可控合成(改写抹去工具名、增弱依赖比例)对构造”逼 agent 从用户意图自行规划”的电商 Agent 训练集有直接参考价值,避免模型靠表层模式作弊。