Arbor: Toward Generalist Autonomous Research via Hypothesis-Tree Refinement
中国人民大学高瓴人工智能学院 × Microsoft Research (MSRA)
把「自主科研」形式化成 Autonomous Optimization(AO)——给一个初始 artifact + 目标 + dev/test 评测器,让 agent 在无人逐步监督下迭代改进。核心是 Hypothesis-Tree Refinement(HTR):用一棵持久化的「假设树」当研究状态,长寿命 coordinator 管全局策略(观察→构思→选择→派发→回传→决策六步循环),短寿命 executor 在隔离 git worktree 里实现单个假设并回传结构化证据;只有在 held-out test 上真正变好才 merge 进当前最优。把「一堆零散试验」变成「可累积、可审计、能跨任务迁移的科研过程」。六个真实科研任务上 held-out 全部最优,平均相对增益是 Codex / Claude Code 的 2.5×+;MLE-Bench Lite 用 GPT-5.5 拿 86.36% Any-Medal。
这是一份 living technical report(作者声明会持续扩充评测)。系统名 Arbor,开源在
github.com/RUC-NLPIR/Arbor。Backbone 默认 Claude Opus 4.6(coordinator 与 executor 同款),也测了 GPT-5.5 / Gemini-3-Flash。注意它和「Agent 推荐 / 推荐系统」无关——是自主科研 / AI 造 AI 方向。
核心思路
一句话问题:现在的 coding agent(Codex、Claude Code、OpenHands)能在真实 codebase 上连续干很多小时,但它们的「自主」基本只是持续执行任务——把每次试验当成一个孤立的局部尝试,长跑下来丢掉了科研的结构:哪些方向试过、失败给了什么教训、证据如何改变下一步该试什么。科学研究的累积性恰恰来自这个被丢掉的东西。
关键 idea / 范式:先把问题形式化为 Autonomous Optimization(AO)——P = (M₀, O, E_dev, E_test),agent 从初始 artifact M₀ 出发、在固定目标 O 与固定评测器下、无逐步人工监督地迭代改进,目标是返回在 held-out E_test 上最好的 artifact。再用 Hypothesis-Tree Refinement(HTR) 解决它:维护一棵持久化假设树当「研究状态」,它同时是 ① 搜索前沿(哪些方向 active / validated / pruned)、② 长期记忆(成功与失败的可复用证据)、③ 可审计记录(每个 artifact 改动都链回驱动它的假设与证据)。一个长寿命 coordinator 管这棵树的全局策略,一批短寿命 executor 在隔离 worktree 里实现单个假设。这样把「持续试错」变成「在持久研究状态上做证据驱动的精化」。
整体实现思路
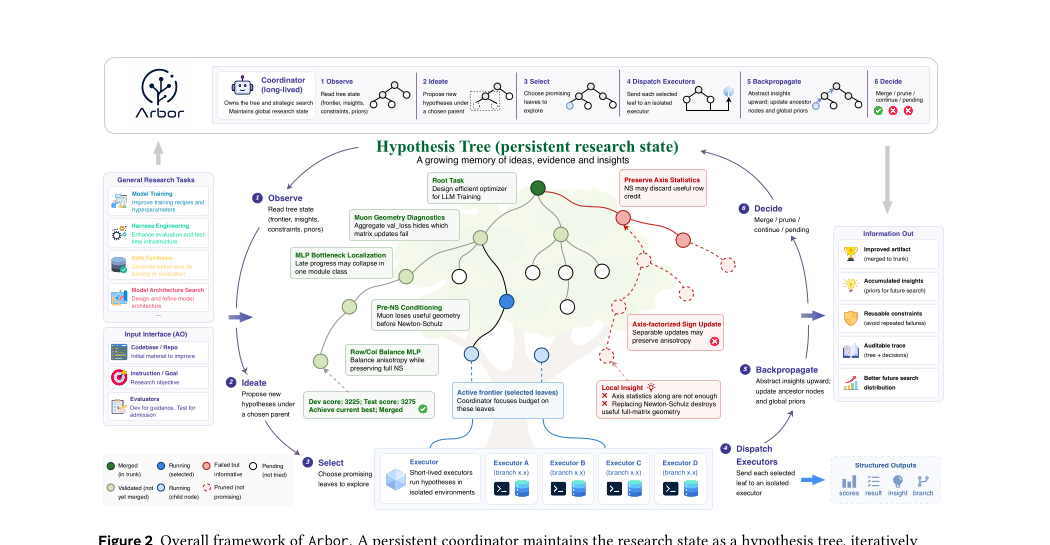
端到端 pipeline(见上图 Figure 2):
- 输入接口(AO):① Codebase / Repo(待改进的初始材料
M₀);② Instruction / Goal(研究目标O);③ Evaluators(E_dev给搜索做引导,E_test做准入裁决)。 - 持久研究状态:中央那棵 Hypothesis Tree。根节点是粗粒度研究方向,越往下越具体到「可被 executor 实现并评测的干预」。每个叶子执行后把分数 / 结果 / artifact 引用 / 提炼出的 insight 写回,再把 insight 向上传播到祖先,使局部实验结果变成方向级教训、最终汇成全局先验。
- 两级控制循环:coordinator 跑 Observe → Ideate → Select → Dispatch → Backpropagate → Decide 六步;每步选中的叶子被派给独立 executor,在 fresh git worktree 里实现+评测,回传紧凑结构化报告(dev 分、事实结果、提炼 insight、branch 引用)。
- 输出:合并进主干的改进 artifact + 累积的 insight(未来搜索的先验)+ 可复用约束(避免重复失败)+ 可审计 trace(树 + 决策)。
设计上有三条硬约束驱动这个架构:有结构的分支(多个竞争假设并存但保持可比可操作,不退化成流水账)、全局策略 ∥ 局部执行分离(低层执行 trace 不污染全局研究状态,实验结果能归因到产生它的假设)、探索 vs held-out 准入(dev 反馈只引导搜索,artifact 级进步只在迁移到 test 时才承认)。
子模块实现(可复现细节)
1. 假设树节点结构 n = ⟨hₙ, ιₙ, μₙ⟩
每个节点把「假设的语义内容 / 可复用证据 / 可执行接地」三件事正交拆开:
- Hypothesis
hₙ:一个可验证/可证伪的主张——「怎么改材料能改进目标」。粒度随深度变化:近根=宽方向,近叶=可实现可评测的具体干预。 - Insight
ιₙ:证据的可复用解释,不是执行 transcript。叶子节点:试了什么 / 发生了什么 / 为什么这结果支持或削弱或约束了该假设;内部节点:对子节点 insight 的抽象,是「语义记忆」供后续 ideation/selection 用。 - Metadata
μₙ:把语义假设连到可执行证据——节点状态、dev 分、事实结果记录、实现引用(git branch / commit)、可选背景证据。材料本身不复制进树,只存对隔离 worktree 里外部 artifact 状态的引用,保证研究状态紧凑又可接地。
内部「方向节点」与可执行「叶子节点」分离;叶子执行后写回 score/result/artifact ref/insight,insight 沿路径向上更新祖先。
2. Coordinator —— 证据感知的前沿控制(六步循环)
关键:LLM 策略只负责”怎么解读研究状态”,所有持久状态变更都表达为对假设树的受控 mutation(加节点 / 派 executor / 更新证据 / 传播 insight / 剪枝 / 合并)。
- Observe:每个 cycle 开始读 Tree 的结构化投影(active frontier、近期返回证据、祖先 insight、当前最优
M_best)。让树成为 context 压缩后的权威状态,不依赖有损的对话历史。 - Ideate:选一个父节点,在其下提一小撮子假设(refinement / 替代 / 修正),初始化为 pending。受树证据约束:validated insight 给可建立的假设、pruned 节点给负约束、近期 executor 报告提示哪些干预可行/欠测——不是自由 brainstorm。
- Select:选 pending 节点去执行。不是单纯分数最大化,而是延迟反馈下的前沿控制——可能因为强先验证据、因为兄弟节点暴露未解歧义、或因为「它失败能澄清一个重要假设」而被选。
- Dispatch:选中的假设派给独立 executor,并行跑兄弟假设以获得同方向内的对比证据(利于后续剪枝与抽象)。
- Backpropagate:executor 报告回来,写进对应叶子并沿路径更新 insight。传播的不只是标量分数,还有因果归因、适用条件、可复用教训——叶子级的「数据接口不匹配」能升成方向级约束,最终变全局先验。
- Decide:树吸收新证据后,决定继续扩展 / 剪掉被证伪子树 / 停止 / 尝试合并。合并由 held-out merge gate 把守:候选在 fresh worktree 上跑
E_test,只有在目标O下优于当前最优才 merge 进M_best。
3. Executor —— 假设绑定的实验(hypothesis-bound)
给定节点 n,executor 收到 hₙ + 祖先 insight + 当前最优 + E_dev,开一个隔离 worktree,施加实现 hₙ 所需的最小干预,跑评测,检查失败/未触发代码路径并自行修复实现(可多次 edit+rerun)。
关键契约:executor 全程绑定被指派的假设,metric 卡住时也不许改 hypothesis——否则回传的分数就不再是关于该节点的证据,祖先 insight 会变得无法解释。它只回传 coordinator 树接口要消费的四样:可比 dev 分(选择用)、事实结果(ideation 用)、提炼 insight(回传用)、branch 引用(held-out 验证用)。
4. HTR 主算法(Algorithm 1,伪代码)
输入: P=(M0,O,E_dev,E_test), 预算 B, 分支数 k
初始化: Tree=({n0},∅), 节点0的 artifact ← M0, M_best ← M0
while 预算未尽 且 存在 pending 叶子:
    V ← Observe(Tree, M_best)              # 树形态、根 insight、剪枝/验证教训
    p ← 在 V 下选父节点; 挂 k 个 pending 子节点 {n(i):h(i)} ← Ideate(p,V)
    L ← Select(V) 下的 pending 叶子           # 前沿控制
    {(s_n,r_n,ι_n,b_n)}_{n∈L} ← 并行 Executor(h_n, ι_anc(n), M_best)   # Dispatch
    for n∈L, a∈path(n0→n):
        写回 (s_n,r_n,ι_n,b_n); ι_a ← Abstract({ι_c}_{c∈children(a)})    # Backpropagate
    n† ← argmax_{n∈L} s_n
    if O(E_test(b_n†)) > O(E_test(M_best)): M_best ← merge(b_n†)        # held-out 准入
    剪掉被 {ι_n} 证伪的子树; 持久化 Tree
return M_best, Tree

Procedure Executor(h_n, ι_anc(n), M_best):
    fresh worktree W_n ← M_best
    repeat:
        Δ ← Implement(h_n, ι_anc(n), W_n);  (s_n,r_n) ← E_dev(apply(Δ,W_n))   # 只修 Δ,h_n 固定
    until 运行成功 且 h_n 路径被触发, 或达上限
    return (s_n, r_n, Distill(h_n,Δ,r_n), commit(W_n))
默认预算:20 个 coordinator cycle,树最大深度 2;executor 并行度受评测资源约束。
实验设置与结果
两类 benchmark:① 自建 AO Task Suite(6 个真实科研任务,跨 model training / harness engineering / data synthesis);② MLE-Bench Lite(官方协议)。协议严格:数据与评测 harness 不可变,dev 集供迭代搜索,test 集只用于 merge / 最终验证,每个实验绑 branch 级 artifact 与假设树记录。baseline:Codex(GPT-5.5)、Claude Code(Claude Opus 4.6),同样的初始材料/目标/评测器/预算,48 小时墙钟,跑各自的 /goal 长任务模式。
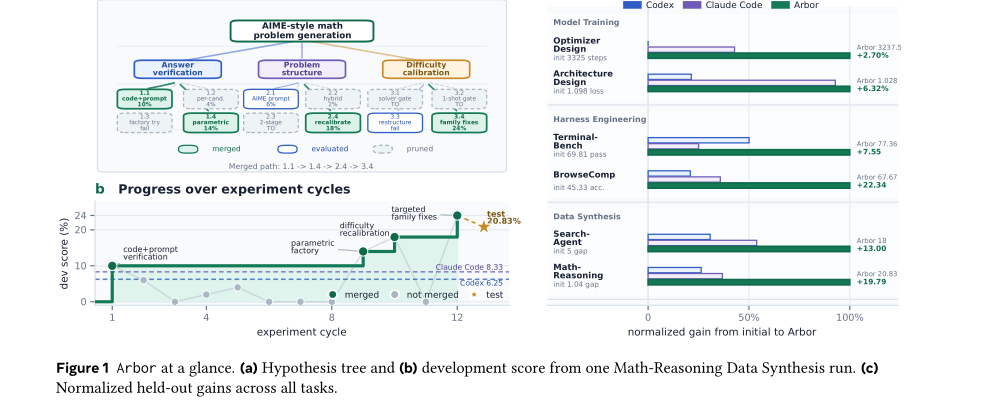
主结果(六个真实科研任务,held-out test)
| 任务 (指标方向) | Initial | Codex | Claude Code | Arbor |
|---|---|---|---|---|
| Optimizer Design (steps ↓) | 3325 | 3325 (+0.0%) | 3287.5 (+1.13%) | 3237.5 (+2.63%) |
| Architecture Design (loss ↓) | 1.098 | 1.083 (+1.37%) | 1.033 (+5.92%) | 1.028 (+6.38%) |
| Terminal-Bench 2.0 (pass ↑) | 69.81 | 73.59 (+3.78) | 71.70 (+1.89) | 77.36 (+7.55) |
| BrowseComp (acc ↑) | 45.33 | 50.00 (+4.67) | 53.33 (+8.00) | 67.67 (+22.34) |
| Search-Agent Data Synth (gap ↑) | 5.00 | 9.00 (+4.00) | 12.00 (+7.00) | 18.00 (+13.00) |
| Math-Reasoning Data Synth (gap ↑) | 1.04 | 6.25 (+5.21) | 8.33 (+7.29) | 20.83 (+19.79) |
六个任务 held-out 全部最优,同一个 controller + 树深度跨三类 artifact(训练算法 / agent harness / 数据生成 pipeline),只换初始材料和评测器——说明增益来自搜索过程本身而非任务定制。Math-Reasoning 上 +19.79 vs baseline 的 5.21/7.29,差距悬殊。
dev/test split 暴露过拟合:Terminal-Bench 上 Claude Code 拿了最高 dev 分(75.00)但 test 掉到 71.70;Arbor dev 更低(72.22)却 test 最高(77.36)——这正是 held-out merge gate 的动机:高 dev / 低 test 不算成功,而是「当前方向在刷评测信号」的证据。
MLE-Bench Lite(官方协议,%)
| 系统 | Model | Above median | Gold | Any medal |
|---|---|---|---|---|
| AIBuildAI | Claude-Opus-4.6 | 81.82 | 37.88 | 77.27 |
| AI-Scientist | Gemini-3-Flash | 86.36 | 31.82 | 81.82 |
| Arbor | Gemini-3-Flash | 86.36 | 40.90 | 81.82 |
| Arbor | GPT-5.5 | 95.45 | 77.27 | 86.36 |
同 Gemini-3-Flash backbone 下追平最佳同 backbone 的 Any-Medal、Gold 更高;只换 backbone 到 GPT-5.5(controller/深度/调度/adapter 全不动),Any-Medal 升到 86.36%、Gold 77.27%,全表最高。
消融与迁移(关键)
| 变体 (MLE-Bench Lite, Opus 4.6) | Valid sub. | Above median | Gold | Any medal |
|---|---|---|---|---|
| Full Arbor | 100 | 90.91 | 50.00 | 81.82 |
| w/o tree(拍平成扁平实验队列) | 100 | 72.72 | 31.82 | 63.64 |
| w/o insight feedback(保留树但禁止 insight 上传) | 100 | 77.27 | 36.36 | 54.54 |
- 三者 Valid submission 都是 100% → HTR 改善的不是「能不能跑通」,而是后期研究精化质量(一旦有可运行解,树帮你决定该扩展/修正/放弃哪个方向)。
- 去掉 insight feedback 比去掉整棵树掉得更多(54.54 < 63.64)→ 光有层级结构不够,树必须能累积证据才有用;没有传播的教训,树只是语法上组织实验,提供不了语义记忆。两者互补。
- 跨任务迁移:在 BrowseComp 上跑出的 search harness 冻结后直接评未见任务——HLE 25.50%→31.50%、DeepSearchQA 61.00%→69.00%(这俩从没参与优化)→ 学到的是能扛分布漂移的 harness 级改动,不是只拟合源 benchmark。
- 成本:六个任务 Arbor 用 20.12M–43.19M tokens,和单轨迹 baseline 同量级 → 增益来自怎么组织预算(维护竞争假设、隔离执行、对比证据、更新树),不是单纯多花 token。节点统计显示很多节点 dev+ 但只有一小撮被 merge——held-out gate 过滤掉了「dev 涨但不迁移」的假进步。
思考与可参考价值
局限:① 默认预算很小(20 cycle、树深 2),更长 horizon 下树的可扩展性/剪枝策略未充分压测;② executor「假设绑定、不许改 hypothesis」是干净的设计,但现实里假设本身设错时只能靠 coordinator 下一轮纠偏,浪费一次执行;③ held-out merge gate 要求每次合并都跑一遍 E_test,在评测昂贵(如训练任务)时成本不低;④ living report,部分任务样本量偏小(如 Optimizer Design test 只平均 2 个 seed)。
对电商 / 搜推 / Agent 方向可直接借鉴:
- 「持久研究状态 = 一棵带证据的树」是很通用的 agent 记忆范式。任何「离线评估→在线效果」的闭环优化(SEO 推词策略迭代、排序调参、simulator 优化)都能套:节点绑假设+实现 branch+评测证据+提炼 insight,insight 向上传播成方向级约束——比「不断膨胀的 context window」或「扁平 trajectory 记忆」更抗长 horizon 衰减。
- held-out merge gate 是防「刷指标」的硬机制。我们做评估 / 调参 agent 时最大的坑就是 dev 涨 test 不涨(overfit 评测器)——把「dev 引导搜索、只有 test 迁移才承认进步」做成架构级门禁,比事后人工 review 可靠。dev/test 分歧本身就是「在刷信号」的信号。
- coordinator(全局策略) / executor(局部接地) 分离 + executor 假设绑定,对多智能体编排是好范式:低层执行 trace 不污染全局状态、结果可归因到具体假设。和我之前看的 Sortify「LLM 当二阶元控制器、有边界的顾问」是同一类思想——别让 LLM 直接乱改底层,让它在受控接口上 mutate 结构化状态。
- insight 必须可累积才有价值(消融最强的证据):给 agent 加「记忆/树」时,如果只存结构不做语义抽象与传播,等于没加。这条对 simulator 驱动的实验循环(我自己在做的方向)是直接的警示。
一句话总结:Arbor 把「自主科研」收敛成 AO 形式化问题,用一棵 coordinator 维护 / executor 接地 / held-out 准入 的持久假设树,把零散试错变成可累积、可审计、能跨任务迁移的研究过程——六任务 held-out 全胜、迁移成立、token 不超量、消融证明「树 + insight 传播」缺一不可,是 auto-research / AI 造 AI 方向上设计干净且证据扎实的一份进展。